 网硕互联帮助中心
一、项目介绍
摘 要
系统采用 Flask 作为后端框架,结合 Vue.js 框架构建前端界面,确保了系统的响应式设计和用户体验。后端使用 Python 编程语言,利用决策树算法进行身价预测,并通过 MySQL 数据库存储和管理数据。系统主要功能包括用户登录、概览、统计分析、回归分析、决策树和模型比较。用户登录后,可以查看足球运动员身价的概览信息,进行统计分析,利用回归分析探索影响因素,并通过决策树和模型比较功能进行身价预测和模型评估。
系统在功能设计上注重用户体验和数据可视化。概览模块为用户提供了足球运动员身价的总体概览,帮助用户快速了解市场趋势。统计分析模块允许用户对身价数据进行多维度的分析,探索不同因素对身价的影响。回归分析模块则使用回归模型对影响因素进行量化分析,揭示各因素对身价的贡献程度。决策树模块采用决策树算法进行身价预测,提供直观的预测结果和决策路径。模型比较模块则支持用户比较不同模型的预测性能,选择最优模型进行身价预测。系统通过这些功能模块,为用户提供了一个全面、高效的足球运动员身价分析及预测工具。
关键词:大数据技术; 足球运动员身价影响因素分析及预测;数据可视化;Python;MySQL数据库
研究内容
本系统说明书的研究内容主要围绕足球运动员身价影响因素的分析与预测展开。首先,系统利用Python编程语言,结合决策树算法,对足球运动员的身价进行预测。通过收集和处理大量足球运动员的相关数据,包括个人技术指标、比赛表现、转会记录等,系统运用MySQL数据库进行数据存储和管理。用户登录后,可以访问概览页面,快速了解足球运动员身价的总体情况。此外,系统还提供了统计分析功能,允许用户对身价数据进行深入分析,探索不同因素对身价的影响。
其次,系统通过回归分析模块,对影响足球运动员身价的因素进行量化分析,揭示各因素对身价的贡献程度。决策树模块则采用决策树算法进行身价预测,提供直观的预测结果和决策路径。模型比较模块支持用户比较不同模型的预测性能,选择最优模型进行身价预测。系统的研究内容不仅包括技术实现,还包括对用户界面的设计,确保用户能够方便地使用系统进行身价分析和预测。通过这些功能模块,系统为用户提供了一个全面、高效的足球运动员身价分析及预测工具。
功能需求分析
本系统旨在为用户提供全面的足球运动员身价影响因素分析及预测服务,融合了Python、决策树、MySQL、Vue和Flask等多种技术。用户登录后,可访问概览、统计分析、回归分析、决策树和模型比较等核心功能模块。概览模块提供系统功能简介和快速导航;统计分析模块利用Python进行数据可视化,展示球员身价分布、趋势等;回归分析模块基于MySQL数据库中的历史数据,运用Python进行回归分析,预测球员身价;决策树模块则利用决策树算法,直观展示影响球员身价的关键因素;模型比较模块允许用户对比不同预测模型的准确性和适用性。系统还需支持用户管理、数据导入导出等基本功能,确保用户能够便捷、高效地获取所需信息和分析结果。通过这些功能,系统将为用户提供一个集数据展示、分析和预测于一体的综合平台,助力用户深入理解足球运动员身价的影响因素和未来趋势。
系统总体流程设计
本系统的总体流程分为数据准备、模型构建、系统实现和用户交互四个主要阶段。首先,在数据准备阶段,系统通过爬虫或API接口收集足球运动员的相关数据,包括个人基本信息、比赛统计数据、转会记录等,并将数据存储到MySQL数据库中。然后,在模型构建阶段,系统使用Python的机器学习库构建决策树模型,对球员身价进行预测。模型构建过程中,系统会对数据进行预处理、特征选择和模型训练,并通过交叉验证等方法优化模型参数。
接下来,在系统实现阶段,系统采用Flask框架构建后端服务,实现数据的管理和模型的调用。前端则使用Vue.js框架构建用户界面,实现用户登录、数据展示和交互功能。最后,在用户交互阶段,用户登录系统后,可以访问概览、统计分析、回归分析、决策树和模型比较等功能模块。用户可以通过这些模块查看球员身价的总体情况、分析影响身价的各个因素、比较不同模型的预测性能,并最终选择最优模型进行身价预测。系统通过这些流程,为用户提供了一个全面、高效的足球运动员身价分析及预测工具。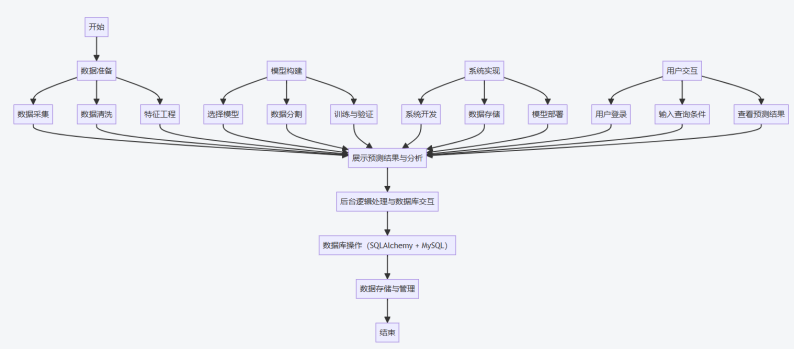
二、文档介绍
三、項目设计与实现
功能模块设计
本系统主要包含五个功能模块:用户登录模块、概览模块、统计分析模块、回归分析模块、决策树模块和模型比较模块。用户登录模块负责用户的身份验证和权限管理,确保系统的数据安全。概览模块提供足球运动员身价的总体情况和趋势分析,使用户能够快速了解市场动态。统计分析模块则深入挖掘影响球员身价的各个因素,并通过图表和报表的形式展示分析结果。回归分析模块采用多元回归分析方法,量化各因素对身价的贡献程度,揭示身价的影响机制。决策树模块则使用决策树算法进行身价预测,提供直观的预测结果和决策路径。模型比较模块支持用户比较不同模型的预测性能,选择最优模型进行身价预测。通过这些功能模块,系统为用户提供了一个全面、高效的足球运动员身价分析及预测工具。
系统算法设计
本系统的算法设计主要涵盖前后端交互、决策树分析以及回归分析三个方面,旨在实现用户登录后对足球运动员身价影响因素的全面分析和预测。
首先,前后端交互方面,系统采用Vue.js构建前端界面,利用Flask框架搭建后端服务。前端通过Ajax技术与后端进行异步数据交互,确保用户能够实时获取数据并查看分析结果。用户在登录后,前端界面将提供概览、统计分析、回归分析、决策树和模型比较等功能模块的入口。用户选择相应的功能模块后,前端将发送请求至后端,后端接收到请求后,将调用相应的Python脚本进行处理,并将结果返回给前端进行展示。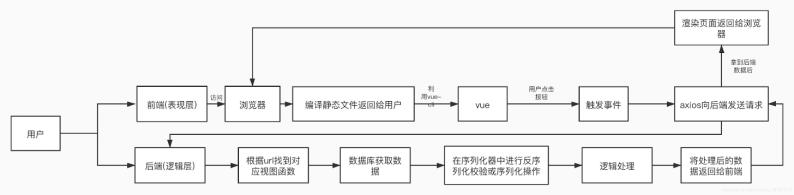
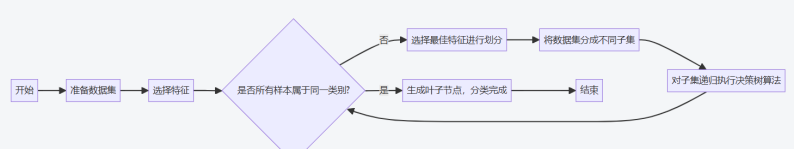
决策树是一种常用的机器学习算法,它通过树状结构来表示决策过程和结果。决策树模型由节点和分支组成,其中节点代表决策点或特征,分支代表不同的决策路径,叶子节点则代表最终的决策结果。决策树算法的核心在于如何选择和划分特征,使得数据能够被有效地分类或回归。
决策树模型的构建过程通常包括以下几个步骤:
(1)明确决策目标和数据特征;
(2)选择最优特征进行划分,并递归地对每个子节点进行相同的操作,直到满足停止条件(如所有样本属于同一类别或达到最大深度);
(3)生成决策树并进行剪枝优化,以提高模型的泛化能力。
决策树模型具有直观易懂、易于解释、计算复杂度不高等优点,因此在许多领域得到了广泛应用,如金融风险评估、医疗诊断、客户行为分析等。然而,决策树模型也存在一些局限性,如容易过拟合、对连续值处理不够灵活等。为了解决这些问题,研究者们提出了许多改进的决策树算法,如ID3、C4.4.3、CART等。
预测是自然语言处理领域的一个重要任务,旨在从文本数据中识别和提取信息。决策树算法在预测任务中发挥着重要作用,它可以通过学习文本特征与倾向之间的映射关系,实现对文本的自动分类。
在决策树预测中,首先需要对文本进行预处理,包括分词、去除停用词、词性标注等步骤。然后,将预处理后的文本转换为数值型特征,如词袋模型、TF-IDF等。接下来,使用决策树算法对特征进行训练和分类,构建分类模型。
决策树预测模型具有易于理解和解释的优点,可以通过可视化的方式展示决策过程和结果。同时,决策树模型还能够处理缺失值和异常值,对非线性关系具有较好的适应性。然而,决策树预测模型也存在一些挑战,如特征选择、过拟合等问题。为了提高模型的性能,可以采用特征降维、交叉验证、剪枝优化等技术手段。在实际应用中,决策树预测模型已经广泛应用于社交媒体分析、客户服务、市场调研等领域。
数据获取
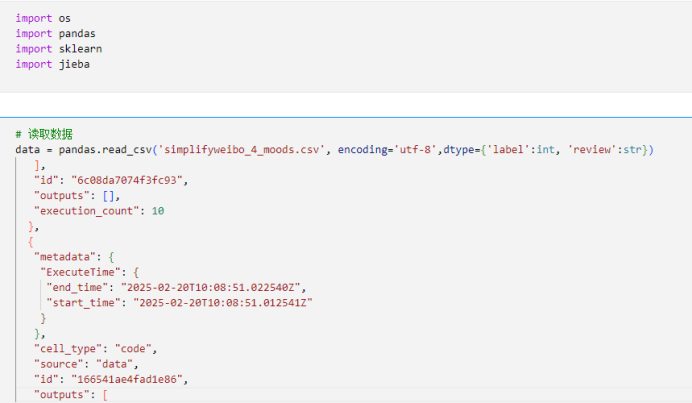
在系统中,为了建立决策树模型进行预测,首先需要获取相关的数据。首先,通过导入必要的库(如os、pandas、sklearn和jieba),为后续的数据读取和处理做好准备。接着,使用pandas库的read_csv函数读取名为’simplifyblbl_4_moods.csv’的CSV文件,该文件包含了文本及其对应的预测。在读取数据时,指定了编码为’utf-8’以确保正确处理中文字符,并通过dtype参数明确了’label’字段为整数类型,'review’字段为字符串类型,以保证数据的准确性和一致性。读取完成后,数据被存储在名为data的DataFrame对象中,便于后续的数据清洗、特征提取和模型训练。此过程为系统的预测任务提供了坚实的数据基础,确保了后续分析的有效性和准确性。
数据分析
在系统的数据处理环节,为了准备适合决策树模型训练的特征,本段代码实现了停用词加载、文本分词以及分词结果的存储。首先,通过读取’hz_stopwords.txt’文件,加载了停用词列表,这些停用词将在后续的分词过程中被过滤掉,以减少噪声并提高特征的有效性。接着,定义了一个名为cut_text的函数,该函数使用jieba库对输入的文本进行分词,并去除分词结果中的停用词,最后将剩余的词用空格连接成字符串返回。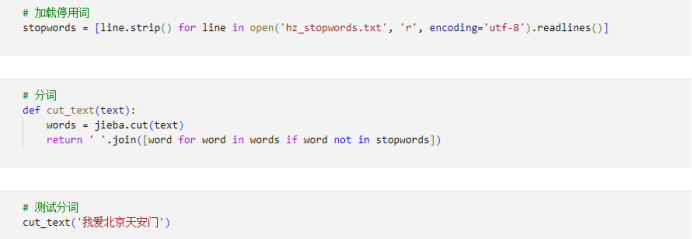
划分数据集
在运动员数据分析中,为了使用决策树模型进行预测,数据集的合理划分是至关重要的一步,利用sklearn.model_selection模块中的train_test_split函数来划分数据集。
首先,通过导入train_test_split函数,为后续的数据集划分做好准备。接着,使用该函数将预处理后的数据集data中的cut_review列(即分词后的文本)作为特征集X,label列(即预测)作为目标集y进行划分。在划分过程中,指定了测试集的比例为0.2,即20%的数据将被用作测试集,剩余80%的数据用作训练集。同时,通过设置random_state=42确保了划分的随机性可复现,这对于后续的实验对比和结果分析具有重要意义。
划分完成后,得到了训练集X_train、y_train和测试集X_test、y_test。训练集将用于决策树模型的训练,而测试集则用于评估模型的性能。通过合理的数据集划分,可以确保模型在训练过程中充分学习数据的特征,并在测试过程中准确评估模型的泛化能力。这一步骤为系统的预测任务提供了可靠的数据基础,确保了后续模型训练和评估的有效性和准确性。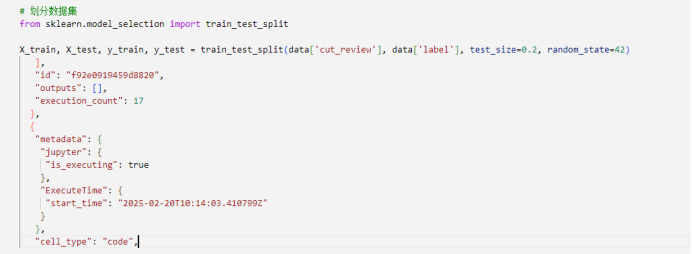
训练模型
在运动员数据分析中,训练模型是关键步骤之一,通过导入CountVectorizer、TfidfTransformer和make_pipeline等模块,为构建文本特征提取和分类的流水线做好准备。CountVectorizer用于将文本数据转换为词频矩阵,TfidfTransformer则进一步将词频矩阵转换为TF-IDF特征矩阵,以捕捉文本中的重要词汇信息。接着,使用make_pipeline函数将这两个特征提取步骤与DecisionTreeClassifier决策树分类器组合成一个流水线模型。
在模型构建完成后,使用fit方法对训练集X_train和y_train进行训练。训练过程中,流水线模型首先利用CountVectorizer和TfidfTransformer对训练集中的文本数据进行特征提取,然后将提取的特征输入到DecisionTreeClassifier中进行分类模型的训练。通过这一系列的步骤,模型能够学习到文本特征与预测之间的映射关系,为后续的预测任务奠定基础。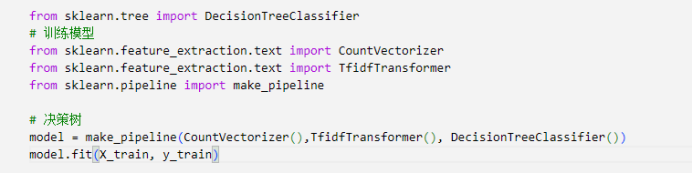
结 论
本系统旨在为足球产业从业者提供一个全面、高效的足球运动员身价影响因素分析及预测平台。技术层面,系统融合了Python、决策树、MySQL、Vue和Flask等多种先进技术,确保了数据的处理能力、分析的深度以及界面的友好性。Python作为核心编程语言,驱动了统计分析、回归分析及决策树模型的构建与运行;MySQL数据库则保障了用户数据及球员数据的存储安全与快速检索;Vue和Flask的结合,为用户带来了响应迅速、交互自然的网页体验。
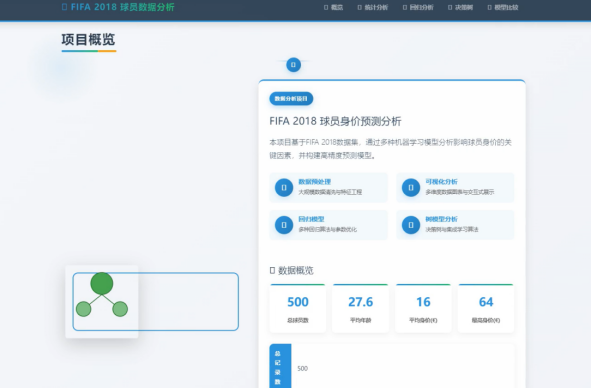
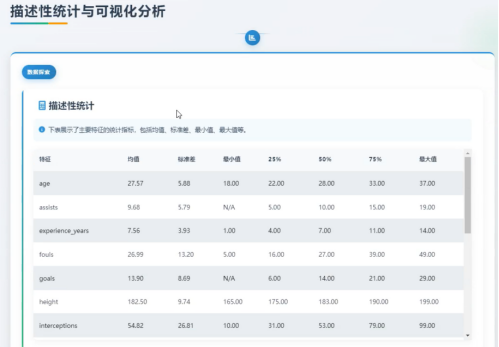
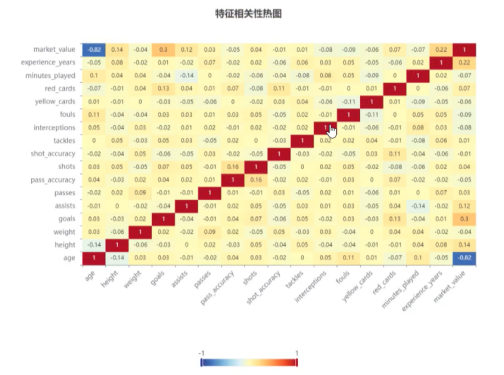
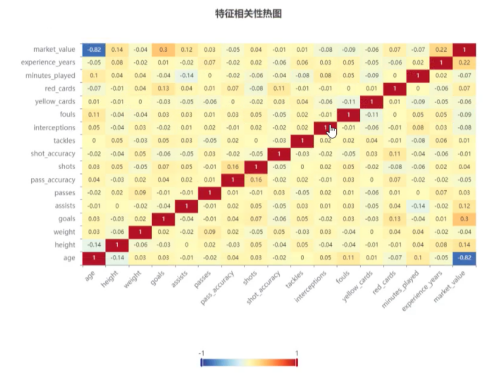
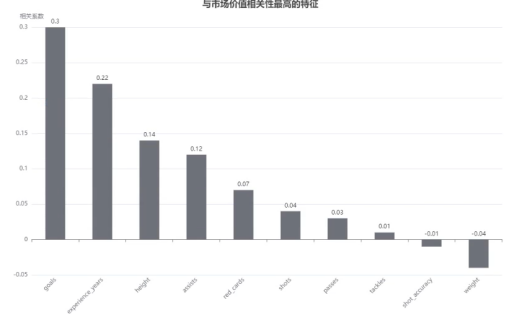
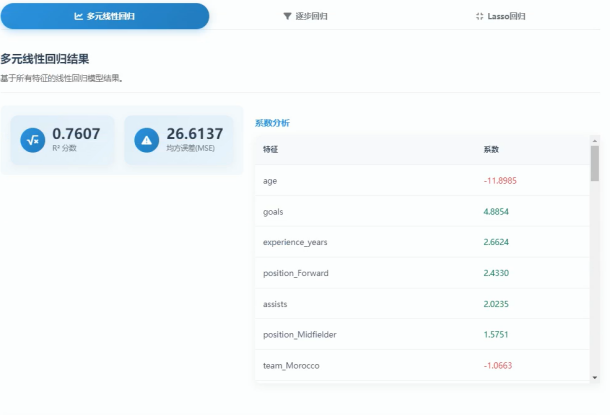
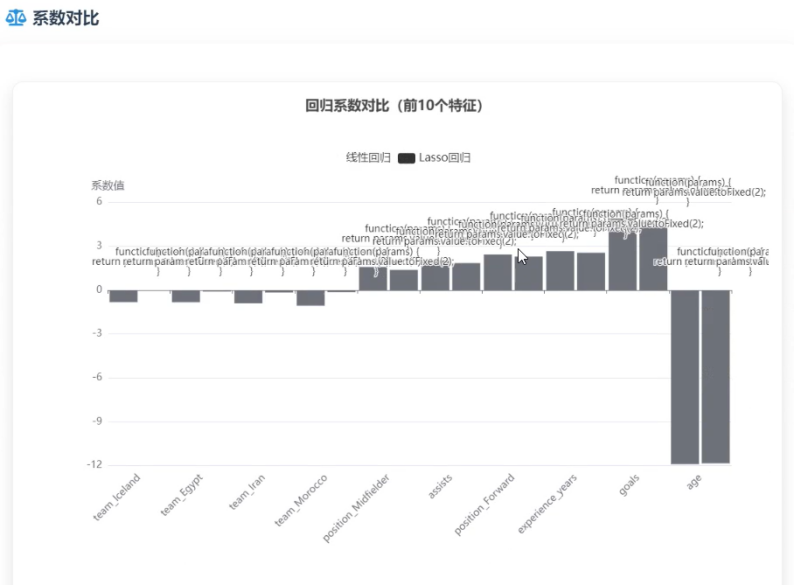
功能模块上,系统划分为概览、统计分析、回归分析、决策树和模型比较五大板块。用户登录后,首先映入眼帘的是概览页面,这里以图表和关键指标的形式展示了足球运动员身价的整体分布和趋势。深入统计分析板块,用户可以探索各类特征变量与球员身价之间的相关性,为后续分析提供数据支撑。回归分析板块则提供了多元线性回归、逐步回归等多种分析方法,帮助用户量化各特征对身价的影响程度。决策树模块则以直观的树形结构展示了球员身价决策的路径和规则。最后,模型比较板块允许用户对比不同模型的预测效果,选择最合适的模型进行身价预测。
总体而言,本系统不仅实现了足球运动员身价影响因素的深入分析,还提供了精准的预测功能,为足球俱乐部的球员引进、培养和转会决策提供了有力的数据支持。系统的易用性和全面性使得即使是非技术人员也能轻松上手,进行复杂的数据分析和模型应用。未来将继续优化系统功能,引入更多先进算法,提升预测准确性,为足球产业的科学发展贡献更多力量。



评论前必须登录!
注册