 网硕互联帮助中心
让原子模型学会分工:专家路由如何提升势能预测
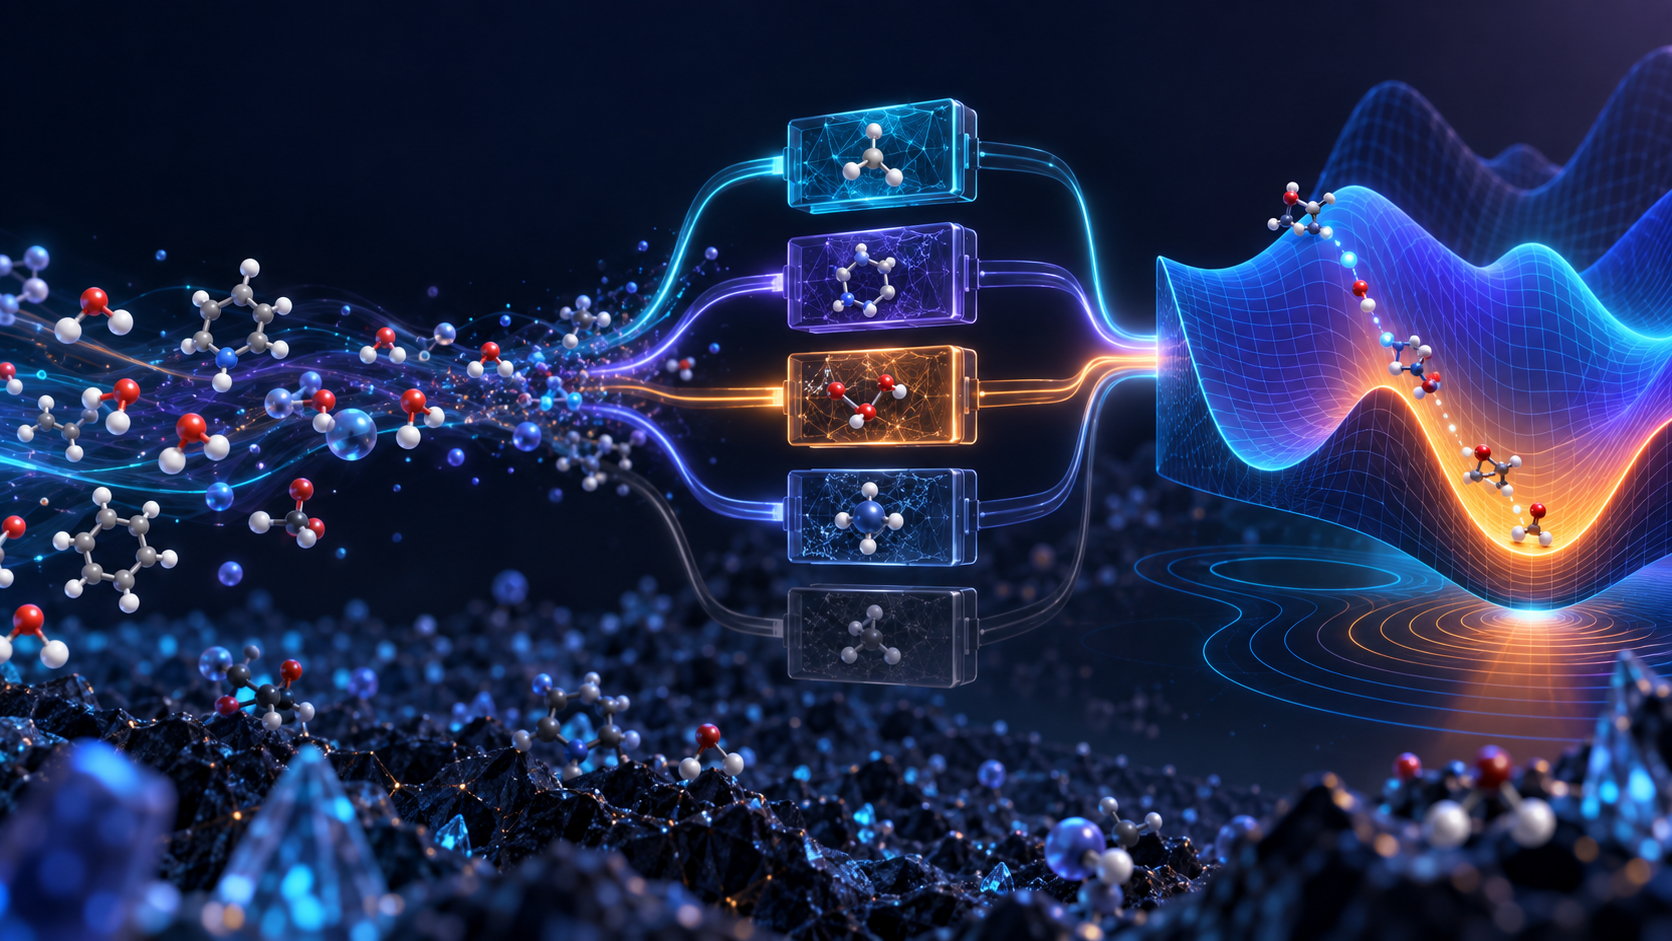
机器学习原子势的目标很诱人:用接近量子力学的精度预测原子间能量和力,再把它放进大规模分子动力学模拟。难点在于,化学体系太多、构型太复杂,一个模型要同时处理分子、固体、催化表面和不同元素组合,表达能力与计算成本很容易发生冲突。
我最近关注到一种自然的解决方式:不要让每个参数都服务所有化学环境,而是准备多个专家,让路由器根据局部元素和结构选择少数合适的专家。这就是把 Mixture of Experts(MoE)引入机器学习原子势。
一,专家模型的关键不在“多”,而在“怎么分工”
这组实验在 DPA3 框架内比较了非线性 MoE 和线性专家 MoLE,还系统测试了共享专家、元素级路由和全局路由。
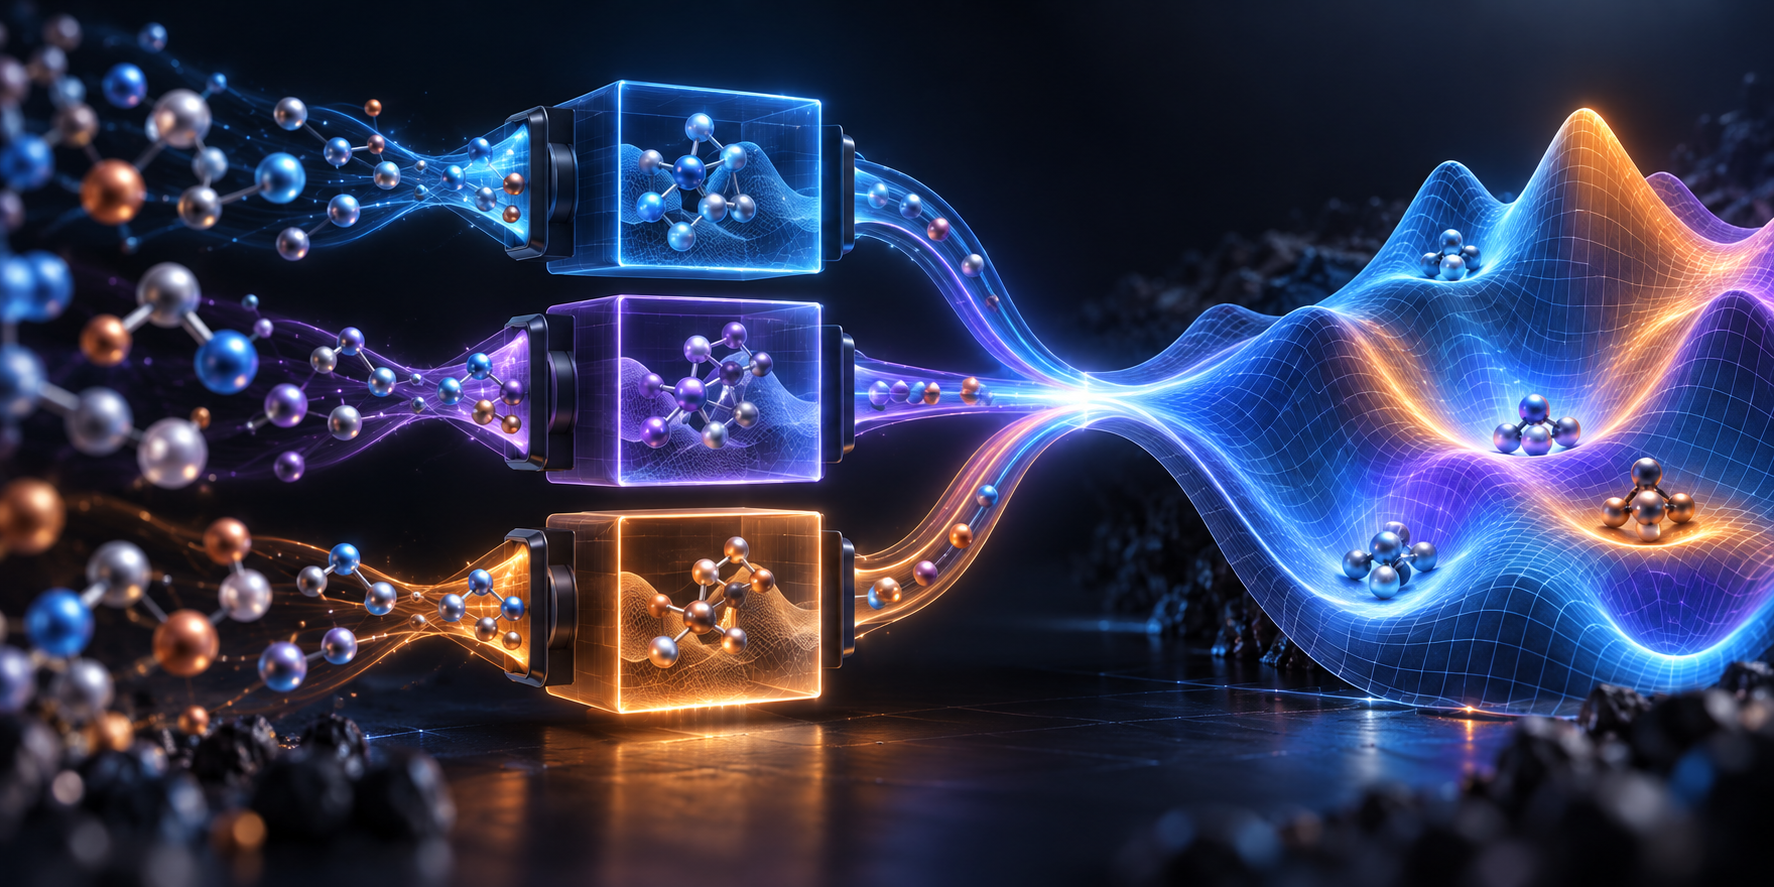
两种路由方式的区别很关键:元素级路由可以让不同元素或局部原子选择不同专家;全局路由则更像对整个构型做一次统一选择。化学相互作用往往具有局部差异,因此元素级路由更符合“一个分子里不同原子需要不同处理”的直觉。
实验还发现,共享专家很重要。它们提供所有元素都能使用的通用能力,再由专门专家补充化学特异性。如果每个专家都完全独立,模型可能重复学习基础规律,参数多了,稳定性却未必更好。
二,非线性专家为什么胜过线性混合
MoLE 用线性组合混合专家输出,结构更简单;MoE 则保留非线性专家,让不同专家真正学习不同的局部函数。共享专家加入后,非线性 MoE 的优势更明显,说明元素级化学差异并不只是几个线性权重能表达的。
在 OMol25、OMat24 和 OC20M 三个基准上,元素级 MoE 持续优于 DPA3 基线。对 OMol25 和 OC20M,能量 MAE 大约降低 25%–30%,力 MAE 降低约 20%–25%;OMat24 的提升较温和,能量误差约降 10%–15%,力误差低于 10%。在相近参数量的比较中,专家模型也能超过加宽的密集模型。
我尤其喜欢路由模式的可解释性:不同专家对元素的使用呈现与周期表趋势相呼应的分工。这不代表模型自动学到了完整化学理论,但至少可以检查它是否在按元素和局部环境形成稳定偏好。
三,全局路由为何容易不稳
全局 MoE 路由在 OMol25 上经常出现数值不稳定,部分变体甚至无法给出可靠结果;而元素级路由的 MoLE 通常比全局版本低约 5%–10% 的能量和力误差。我的理解是,全局路由把一个复杂构型压成单一选择,容易让不同元素和局部环境争夺同一组专家,优化过程也更难保持平滑。
但专家数量并非越多越好。实验显示,增加激活专家通常会改善误差,直到容量和路由稳定性之间出现新的平衡;专家太多时,能量误差可能反而上升。稀疏激活节省了计算,却把路由质量变成了新的核心问题。
四,我会关注的部署边界
三个数据集覆盖分子、材料和催化场景,但它们并不能代表所有元素、温度、压力和反应路径。专家路由在训练分布之外是否仍然稳定,需要更多跨体系验证。另一个现实问题是分子动力学要求能量、力和对称性保持一致,专家切换如果不够平滑,可能给轨迹带来不连续扰动。
因此我不会只看单次 MAE。还应检查能量面平滑性、力的守恒关系、长时间动力学稳定性,以及不同专家在边界构型上的切换行为。
五,结论
MoE 给机器学习原子势的最大启发,不是把模型简单做大,而是让模型把化学环境分开处理。元素级路由、共享专家和非线性专门化结合起来,能在参数效率与表达能力之间找到更好的平衡。
当模型开始“知道自己该找哪个专家”,原子势就不再只是一个统一黑盒,而更像一组可以检查、扩展和诊断的化学局部模型。
参考资料:Liu, Y., Zhang, D., Peng, A. et al. Mixture of experts architectures for machine learning interatomic potentials. npj Artif. Intell. (2026).


评论前必须登录!
注册