 网硕互联帮助中心
前言
9 月 30 日,DeepSeek 放出重磅生态动作:正式开源面向华为昇腾算力平台的全套基础设施组件,覆盖编译工具、计算库、通信库三大核心模块,与英伟达 CUDA 生态工具链一一对应。
这不是一次普通的代码开源,而是国产 AI「模型 – 算力 – 生态」全链路闭环的关键一步。此前大家聊国产算力,总说「芯片性能够,但生态难用」,DeepSeek 这次直接把自己跑通万亿级模型的工程经验全部开放,相当于给整个行业递了一套开箱即用的国运算力工具箱。
本文就完整拆解这次开源的核心内容、技术价值、万亿模型进展、政务落地现状,以及对整个行业格局的影响。
一、事件核心:开源昇腾全栈基础组件,到底是什么
1.1 三大核心开源组件
这次 DeepSeek 开源的不是模型本身,而是大模型训练与推理的底层基础设施,完整对标英伟达 CUDA 生态下的核心工具链:
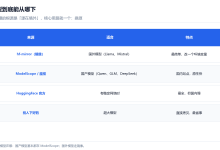
| 编译工具 | 算子编译与优化工具链 | NVCC + 算子编译器 | 实现模型算子在昇腾芯片上的高效编译与优化 |
| 计算库 | 基础数学计算、张量运算核心库 | cuBLAS / cuDNN | 提供大模型训练推理所需的基础运算能力 |
| 通信库 | 分布式训练多卡通信组件 | NCCL | 支撑多机多卡分布式训练的高效数据通信 |
简单说:之前开发者把模型迁移到昇腾平台,很多底层算子要自己写、工具要自己适配,踩坑无数;现在 DeepSeek 把自己踩过坑、打磨好的全套工具直接开源,开发者可以直接复用,迁移成本大幅降低。
1.2 为什么这一步至关重要
国产算力长期面临的痛点,从来不是「芯片算力不够」,而是「软件生态不好用」:
- 英伟达 CUDA 生态发展二十余年,算子、工具、库一应俱全,开发者开箱即用
- 昇腾等国产芯片算力指标已经达标,但上层软件生态不完善,工程化门槛高
DeepSeek 这次开源,相当于把自己在昇腾平台跑通万亿级模型的工程经验普惠全行业,直接补齐了国产算力软件生态的关键短板。这不是某一家公司的进步,而是整个国产 AI 行业的基础设施升级。
二、深层价值:国运算子落地的三层核心意义
很多人只看到「开源了几个工具」,但背后其实是三层战略级的价值落地:
第一层:技术自主,摆脱供应链卡脖子
大模型的底层是算力,算力的底层是算子和软件生态。如果只做上层模型、不掌握底层算子工具,就永远要依赖国外生态。 DeepSeek + 昇腾的组合,目前已经实现了芯片 → 算子 → 框架 → 模型 → 应用的全链路自主可控,就算外部供应链受限,也能独立迭代升级。
第二层:成本下降,大模型落地门槛进一步降低
英伟达 GPU 价格高、供货受限,是国内大模型落地的最大成本瓶颈。 国运算子生态完善后,昇腾芯片的工程可用性大幅提升,大模型训练和推理的整体成本可以进一步下降。对于政务、中小企业等对成本敏感的场景,意味着 AI 落地的门槛进一步降低。
第三层:生态开放,带动全行业共同升级
DeepSeek 没有把这套工具攥在自己手里独享,而是选择开源,相当于给整个国产 AI 行业递了一套趁手的工具。 所有大模型厂商、开发者都可以基于这套组件,快速把自己的模型迁移到国产算力平台上,不用再重复造轮子。最终受益的是整个国产 AI 产业。
三、万亿参数赛道:DeepSeek 的规模追赶路线
DeepSeek 过去留给行业最深的标签是「极致效率」:2024 年底的 R1 模型,以 6710 亿总参数、仅 557.6 万美元的训练成本,证明了前沿模型不需要无限堆 GPU。
而进入 2026 年,DeepSeek 主动加入了万亿参数竞赛,技术路线延续高效风格:
全网万亿参数模型横向对比
目前头部厂商都已进入万亿参数时代,各有侧重:
| DeepSeek | 2 万亿训练中,远期 8 万亿 | MoE 高效路线 | 昇腾 + 英伟达双栈 | 成本控制、国产适配 |
| 字节跳动 | 最高 10 万亿预训练中 | 稠密 + MoE 结合 | 英伟达为主 | 数据场景、多模态 |
| 阿里通义 | 5-10 万亿规划中 | MoE 架构 | 阿里云算力 | 企业服务、云生态 |
| 月之暗面 | 2.8 万亿已发布 | MoE 架构 | 英伟达为主 | 长上下文、推理性能 |
| Anthropic | 约 8 万亿业内预估 | 稠密路线 | 英伟达 | 安全合规、企业市场 |
核心差异:DeepSeek 是目前头部厂商里,唯一把万亿级模型全栈跑通国产算力平台的玩家,这也是它在政务、国央企市场的核心竞争力。
四、政务落地:国产模型 + 国产算力的全栈闭环
政务是对「自主可控」要求最高的场景,也是 DeepSeek 国产生态落地最成熟的领域。目前全国多个城市已经完成 DeepSeek 大模型的政务部署,且全部基于国产算力底座。
4.1 典型落地城市案例
- 深圳龙岗:部署 DeepSeek-R1 全尺寸模型(6710 亿参数),上线「龙 i 企」企业服务小程序,提供政策解读、政务咨询、企业开办服务
- 南京:全省率先在政务外网完成 DeepSeek-V4 私有化部署,通过政务大模型 MaaS 平台向全市各部门开放,支撑政策咨询、公文处理、数据分析
- 南通:基于全栈国产化算力底座,完成 DeepSeek V4 本地化适配,覆盖政务服务、民生保障、城市治理等领域,区县业务覆盖率达 70%
- 中山:部署 DeepSeek-R1 多版本模型,接入协同办公、党政办公系统,落地公共资源交易文件稽核、政策智能解读等场景
- 克拉玛依:全疆首个全栈国产化政务智能平台,基于华为昇腾算力部署 DeepSeek-R1,实现「国产模型 + 国产算力 + 本地政务数据」全链条整合
4.2 政务场景的核心优势
五、行业影响:大模型战争进入下半场
5.1 竞争焦点已经转移
这次开源释放了一个明确的信号:大模型行业的竞争,已经从「卷模型参数」进入了「卷生态落地」的下半场。
- 上半场:比谁的模型参数大、跑分高、回答准
- 下半场:比谁的生态全、落地多、成本低、自主可控
对于政务、国央企等核心场景,模型参数多几百亿、少几百亿已经不是核心矛盾,能不能全栈国产化、能不能合规落地、能不能低成本运维,才是真正的决策标准。
5.2 接下来的两个趋势
六、落地建议与总结
6.1 不同角色的行动建议
- 开发者:可以关注这套昇腾算子组件,提前学习国产算力平台的模型适配,未来国产生态的岗位需求会快速增长。
- 企业用户:如果对数据安全、自主可控有强需求,可以开始评估 DeepSeek + 昇腾的私有化方案,成本优势会越来越明显。
- 政务 / 国央企:优先选择全栈国产化的方案,从底层芯片到上层模型全部自主可控,规避供应链和合规风险。


评论前必须登录!
注册