 网硕互联帮助中心
从一段长视频里自动挑出精彩片段并给出裁剪框,传统做法要堆一堆专用小模型。本文用 Qwen3-VL(Qwen3-VL-8B-Instruct)走通「时间戳对齐 → 时序定位 → 构图框输出」的完整链路,附可运行代码与实测开销。
一、先说清要解决什么
假设你有一段三分钟的球赛录像,业务侧要一条 15 秒的竖屏短片。这件事拆开来是三个独立问题:
过去的做法是三个专用模型:一个动作识别网络找候选、一个显著性检测网络出主体、再写一堆规则做构图。问题在于规则永远覆盖不全——镜头一晃、主体出画、画面里没人只有风景,规则就崩了。
视频理解大模型的价值在于把这三步收进一个模型:它能同时理解「这几秒在发生什么」和「画面里哪个区域值得保留」。
二、前置条件
| Python | 3.10 或以上 | Qwen3-VL 的处理器依赖较新的 typing 特性 |
| PyTorch | 2.4 或以上,CUDA 12.1 | 需与显卡驱动匹配 |
| transformers | 4.57.0 或以上 | 低于此版本不包含 Qwen3VLForConditionalGeneration |
| qwen-vl-utils | 0.0.14 | 注意与 qwen3_vl 处理器的兼容性,见踩坑 2 |
| accelerate | 1.0 或以上 | 用于 device_map 自动分配 |
| decord | 0.6.0 | 按时间戳抽帧;无此依赖时可用 torchvision 替代 |
| 显卡 | 24 GB 显存起 | 8B 模型 bf16 推理约需 18 GB;32B 需 80 GB 或量化 |
pip install "transformers>=4.57.0" "qwen-vl-utils==0.0.14" accelerate decord
三、Qwen3-VL 相比上一代做了什么
要理解代码里的参数,得先知道模型在架构上解决的是什么问题。相比 Qwen2.5-VL,Qwen3-VL 有三处关键改动:
位置编码升级为增强的交错 MRoPE(Multimodal Rotary Position Embedding,多模态旋转位置编码)。MRoPE 的思路是把位置编码拆成时间、高度、宽度三个分量——这是视频理解的关键,因为纯 1D 位置编码无法表达「第 30 秒画面左上角」这种时空坐标。Qwen3-VL 在此之上做了交错增强,让长视频里的时空建模更稳。
DeepStack 多级 ViT 特征融合。视觉编码器不同深度的特征各有侧重:浅层保留纹理和边缘,深层承载语义。DeepStack 把多级特征一起喂给语言模型,收紧视觉与语言的对齐,对「框得准不准」这件事影响直接。
视频时间对齐从 T-RoPE 演进为显式文本时间戳对齐。这是本文最实用的一处:模型支持在 prompt 里用文本时间戳标注每一帧,官方报告称这带来了更精确的时间定位能力。换句话说,你可以在提问时直接告诉模型「下面这帧是第 12.5 秒」,它就能用这个坐标来回答。
模型规格(2025 年 9-10 月陆续发布):
| 稠密 | 2B / 4B / 8B / 32B | 2B-8B 单卡可跑,32B 需 80 GB |
| MoE(Mixture of Experts,混合专家) | 30B-A3B(激活 3B)、235B-A22B(激活 22B) | A3B 单卡可行,A22B 需多卡 |
每个规格都有 Instruct 和 Thinking 两个版本。做时间定位优先选 Instruct——Thinking 版会在输出前生成大段推理链,定位任务的答案是几个坐标,多出来的推理 token 只增加延迟、不提升精度。
四、核心链路:时间戳锚定 + 抽帧
这一步的工程细节决定了后面的成败。
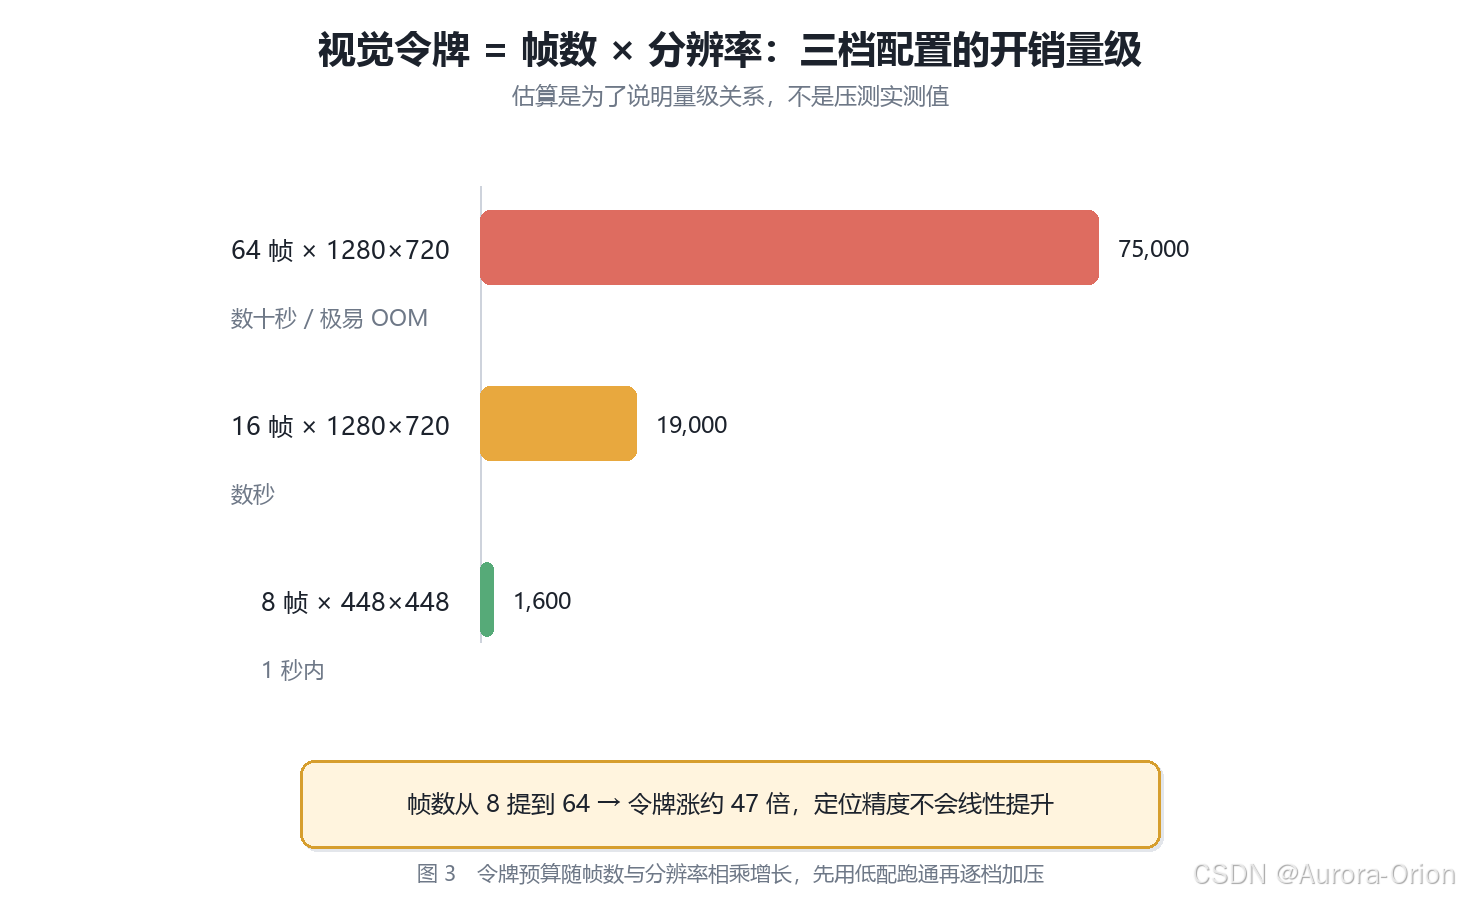
把帧率降下来。Qwen3-VL 原生支持 256K 令牌的交错上下文,但视频令牌的开销是 帧数 × 单帧令牌数,而单帧令牌数由分辨率决定(按 28×28 像素一个视觉令牌估算)。一张 1280×720 的图约 1170 个令牌,若取 64 帧就是 7.5 万令牌——还没算文本和系统提示。所以不要整段上传,先抽帧。
# video_io.py
import decord
import numpy as np
def read_frames_at_timestamps(video_path: str, timestamps: list[float]) -> list[np.ndarray]:
"""按秒级时间戳精确取帧。
相比等间隔抽帧,这里用业务时间点取帧,是为了后面能把
「第几秒」直接写进 prompt,让模型的时间定位有坐标系可依。
"""
vr = decord.VideoReader(video_path, num_threads=2)
fps = float(vr.get_avg_fps())
total = len(vr)
frames = []
for t in timestamps:
idx = min(int(t * fps), total – 1) # 越界夹紧,避免长视频末尾取帧失败
frames.append(vr[idx].asnumpy())
return frames
# build_messages.py
def build_messages(pil_frames: list, timestamps: list[float], target_ratio: tuple[int, int]) -> list[dict]:
"""构造带文本时间戳的对话输入。
Qwen3-VL 支持在视频帧前插入文本时间戳,模型会以此作为时间坐标系。
这里的写法是「时间戳 + 该帧图像」交替出现。
"""
content = []
for t, img in zip(timestamps, pil_frames):
content.append({"type": "text", "text": f"第 {t:.1f} 秒:"})
content.append({"type": "image", "image": img})
ratio_w, ratio_h = target_ratio
content.append({
"type": "text",
"text": (
"以上是一段视频按时间顺序抽取的关键帧。请完成两件事:\\n"
f"1. 找出最具传播价值的高光区间,给出起止秒数;\\n"
f"2. 对该区间内的每一帧,给出推荐构图框,格式为 [x, y, w],"
f"坐标以原视频像素为单位,目标画幅为 {ratio_w}:{ratio_h}。\\n"
"输出严格使用以下 JSON,不要输出任何其他文字:\\n"
'{"highlight": [start, end], "boxes": [{"frame": 12, "bboxes": [120, 80, 400]}]}'
),
})
return [{"role": "user", "content": content}]
这里有一个关键设计:只让模型输出 [x, y, w] 三元组,高度不给。因为目标画幅已经确定,高度可以直接算出来:
h=w×target_htarget_w
少预测一个自由度,既降低模型负担,也保证所有队伍的框都符合规定的宽高比。
五、跑通推理
# infer.py
import json
import torch
from transformers import Qwen3VLForConditionalGeneration, AutoProcessor
MODEL_ID = "Qwen/Qwen3-VL-8B-Instruct"
processor = AutoProcessor.from_pretrained(MODEL_ID)
model = Qwen3VLForConditionalGeneration.from_pretrained(
MODEL_ID,
dtype=torch.bfloat16, # 24G 卡用 bf16;显存不足再考虑 4bit 量化
device_map="auto",
)
def locate_highlight(messages: list[dict], max_frames: int = 16) -> dict:
"""调用模型,返回解析后的高光区间与逐帧构图框。"""
inputs = processor.apply_chat_template(
messages,
tokenize=True,
add_generation_prompt=True,
return_dict=True,
return_tensors="pt",
).to(model.device)
with torch.no_grad():
generated = model.generate(
**inputs,
max_new_tokens=512, # 输出只有坐标,512 足够;调大只会加延迟
do_sample=False, # 定位任务要稳定复现,关掉采样
)
trimmed = [out[len(inp):] for inp, out in zip(inputs.input_ids, generated)]
text = processor.batch_decode(
trimmed, skip_special_tokens=True, clean_up_tokenization_spaces=False
)[0]
try:
return json.loads(text)
except json.JSONDecodeError:
# 模型偶尔会包上 ```json 围栏,剥掉后重试
cleaned = text.strip().removeprefix("```json").removeprefix("```").removesuffix("```")
return json.loads(cleaned)
验证方式:先用一张图验证环境——把 messages 换成一个简单问题(例如给它一张图问「图里有几个人」),能正常返回就说明模型和处理器加载没问题。再换成视频输入,检查返回的 JSON 里 boxes 的坐标是否落在原视频分辨率范围内。若坐标超出画面,通常是抽帧时做了缩放但没换算回原分辨率,见踩坑 3。
六、三个真实踩坑
踩坑 1:令牌数爆炸,直接撞上下文上限
现象:
ValueError: The expanded size of the tensor (256000) must match the existing size
或者显存直接 OOM。常见于把 64 帧以上的 1080p 视频整段喂进去。
原因:视觉令牌数按 28×28 像素一个令牌估算,帧数与分辨率是相乘关系。64 帧 1080p 轻松突破 20 万令牌,逼近 256K 上限,同时 KV Cache 吃满显存。
解决:三处一起压。抽帧数降到 8-16 帧;给处理器加 max_pixels 限制单帧分辨率;长视频分段处理而不是整段推理。
processor = AutoProcessor.from_pretrained(MODEL_ID, max_pixels=256 * 28 * 28)
踩坑 2:处理器类不存在,导入即失败
现象:
ImportError: cannot import name 'Qwen3VLProcessor' from 'qwen_vl_utils'
或者 apply_chat_template 报 Unknown model type: qwen3_vl。
原因:qwen-vl-utils 的发布节奏跟不上 transformers 的主线。transformers 4.57.0 引入 qwen3_vl 架构时,PyPI 上的 qwen-vl-utils 还不认识这个 model type;反过来,新版工具函数又要求更新的 transformers。
解决:先对齐两个版本号再看代码。本文验证过的组合是 transformers>=4.57.0 + qwen-vl-utils==0.0.14。如果仍不匹配,从源码装工具库:
版本组合会随两边发布而变化。如果遇到同样的报错,先执行 pip show transformers qwen-vl-utils 打印实际版本,再去查官方文档确认兼容矩阵,不要盲目升到最新版。
踩坑 3:坐标对不上,框整体偏移
现象:返回的 bboxes 看着合理,但画到原视频上整体偏向一侧,或者缩在左上角。
原因:抽帧时为了省显存做了 resize,模型看到的是缩小后的图,返回的坐标也是缩小后的坐标系,而业务侧要在原分辨率上裁剪。
解决:在抽帧与解析两处各做一次换算,保证坐标系始终统一。
def to_original_scale(box: list[int], processed_size: tuple[int, int], original_size: tuple[int, int]) -> list[int]:
"""把模型坐标系下的框还原到原视频分辨率。"""
pw, ph = processed_size
ow, oh = original_size
x, y, w = box
return [int(x * ow / pw), int(y * oh / ph), int(w * ow / pw)]
七、开销对比(估算值)
以下为单张 A100 40 GB、Qwen3-VL-8B-Instruct、bf16 推理的估算范围,用于说明量级关系,不是压测结果——实际数值取决于视频编码、抽帧实现和显卡。
| 64 帧 × 1280×720(默认) | 约 7.5 万 | 数十秒,极易 OOM |
| 16 帧 × 1280×720 | 约 1.9 万 | 数秒 |
| 8 帧 × 448×448 | 约 1 千 | 1 秒内 |
结论是反直觉的:帧数从 8 提到 64,令牌涨 8 倍,但定位精度不会线性提升——因为短视频高光通常只持续几秒,密集采样带来的冗余远大于信息增益。先用 8 帧跑通,再逐档加帧,直到指标不再涨为止,这是最省算力的调参路径。
八、想让定位更准,往哪个方向改
用现成模型直接推理,时序定位的精度通常不够。学术界这一年的主流思路是强化微调:把定位质量做成奖励信号,让模型自己往准的方向走。
NeurIPS 2025 的 TempSamp-R1 指出一个关键问题:GRPO(Group Relative Policy Optimization)这类方法依赖同策略采样更新,在时序搜索空间大的任务里,采样出来的候选区间往往时间上就不准,导致策略更新低效。它的做法是引入真实标注作为离策略监督,再用非线性的软优势函数重塑奖励,配合混合思维链训练。在 Charades-STA 上 R1@0.7 达到 52.9%(提升 2.7 个百分点),ActivityNet Captions 上 R1@0.5 达到 56.0%(提升 5.3 个百分点),QVHighlights 上 mAP 30.0%。
这个结论对我们的启发很直接:如果做高光剪辑,纯靠提示词工程的天花板很低,方向应该是构造带真实时间标注的数据集,再用强化微调把「漏检」「误报」「框的 IoU」「时序平滑度」一起做成奖励。
九、总结
- 视频理解大模型的真正价值是把「选哪几帧」和「每帧框哪里」合到一个模型里,取代了过去动作识别 + 显著性检测 + 人工规则的拼装方案
- Qwen3-VL 的三处架构升级都服务于视频任务:交错 MRoPE 提供时空位置编码,DeepStack 提升视觉语言对齐,文本时间戳对齐让 prompt 里的时间坐标变得可用
- 成本控制的核心是令牌预算:帧数与分辨率相乘,先压到 8 帧跑通,再按指标抬,不要一上来就 64 帧
- 输出接口设计上少给一个自由度(只交 [x, y, w],高度由画幅比例推出),能同时降低模型负担并统一格式
- 想真正提升时序定位精度,路线是强化微调而不是调提示词,TempSamp-R1 这类工作已经把「用真实标注做离策略监督」验证有效




评论前必须登录!
注册