 网硕互联帮助中心
目录
一、前言:Demo 正常,上线即崩的隐性陷阱
二、消息泛滥现象与真实业务案例
案例 1:文档解析多智能体业务
案例 2:消息环路死循环
消息泛滥底层根因
三、四类多智能体通信模式对比
1.广播模式
2.点对点模式
3.消息总线模式
4.事件订阅模式
四、消息总线核心能力设计
五、工程落地权衡思考
六、结尾
摘要:多数开发者实现 Master‑Worker 多智能体架构之后,本地 Demo 运行一切正常,接入线上并发业务却遇到 Token 暴涨、上下文窗口持续膨胀、显存占用飙升、系统内部自发无限循环等隐性故障。很多人把问题归咎于大模型本身,而真实根因往往来自多智能体通信层缺少工程约束。本文分析消息泛滥现象与成因,对比四类通信模式,介绍消息总线生产级设计思路,并给出极简工程示例代码,面向 Agent 开发者、大模型应用工程师、B 端 AI 架构师。
硬核工程向|建议收藏
一、前言:Demo 正常,上线即崩的隐性陷阱
前面专栏文章讨论过 Agent 从 Demo 走向生产的各类翻车问题,也解析过指挥官‑Worker 多智能体架构。不少团队照搬这套架构完成开发,单任务测试环境表现良好;一旦提升并发规模,系统性能出现断崖式退化。
查看内部日志可以观察一类诡异现象:各个智能体之间持续互发消息,大量无效报文来回流转,上下文不断膨胀,Token 消耗成倍放大;极端场景产生消息环路,外部没有新请求,系统内部仍在不停调用大模型。业内将该类现象称之为多智能体消息泛滥。
Demo 环境很难复现该问题,原因在于 Demo 大多是单任务、少量 Agent 实例,整体消息总量有限,资源消耗问题被掩盖。进入生产并发场景之后,缺陷被彻底暴露。
二、消息泛滥现象与真实业务案例
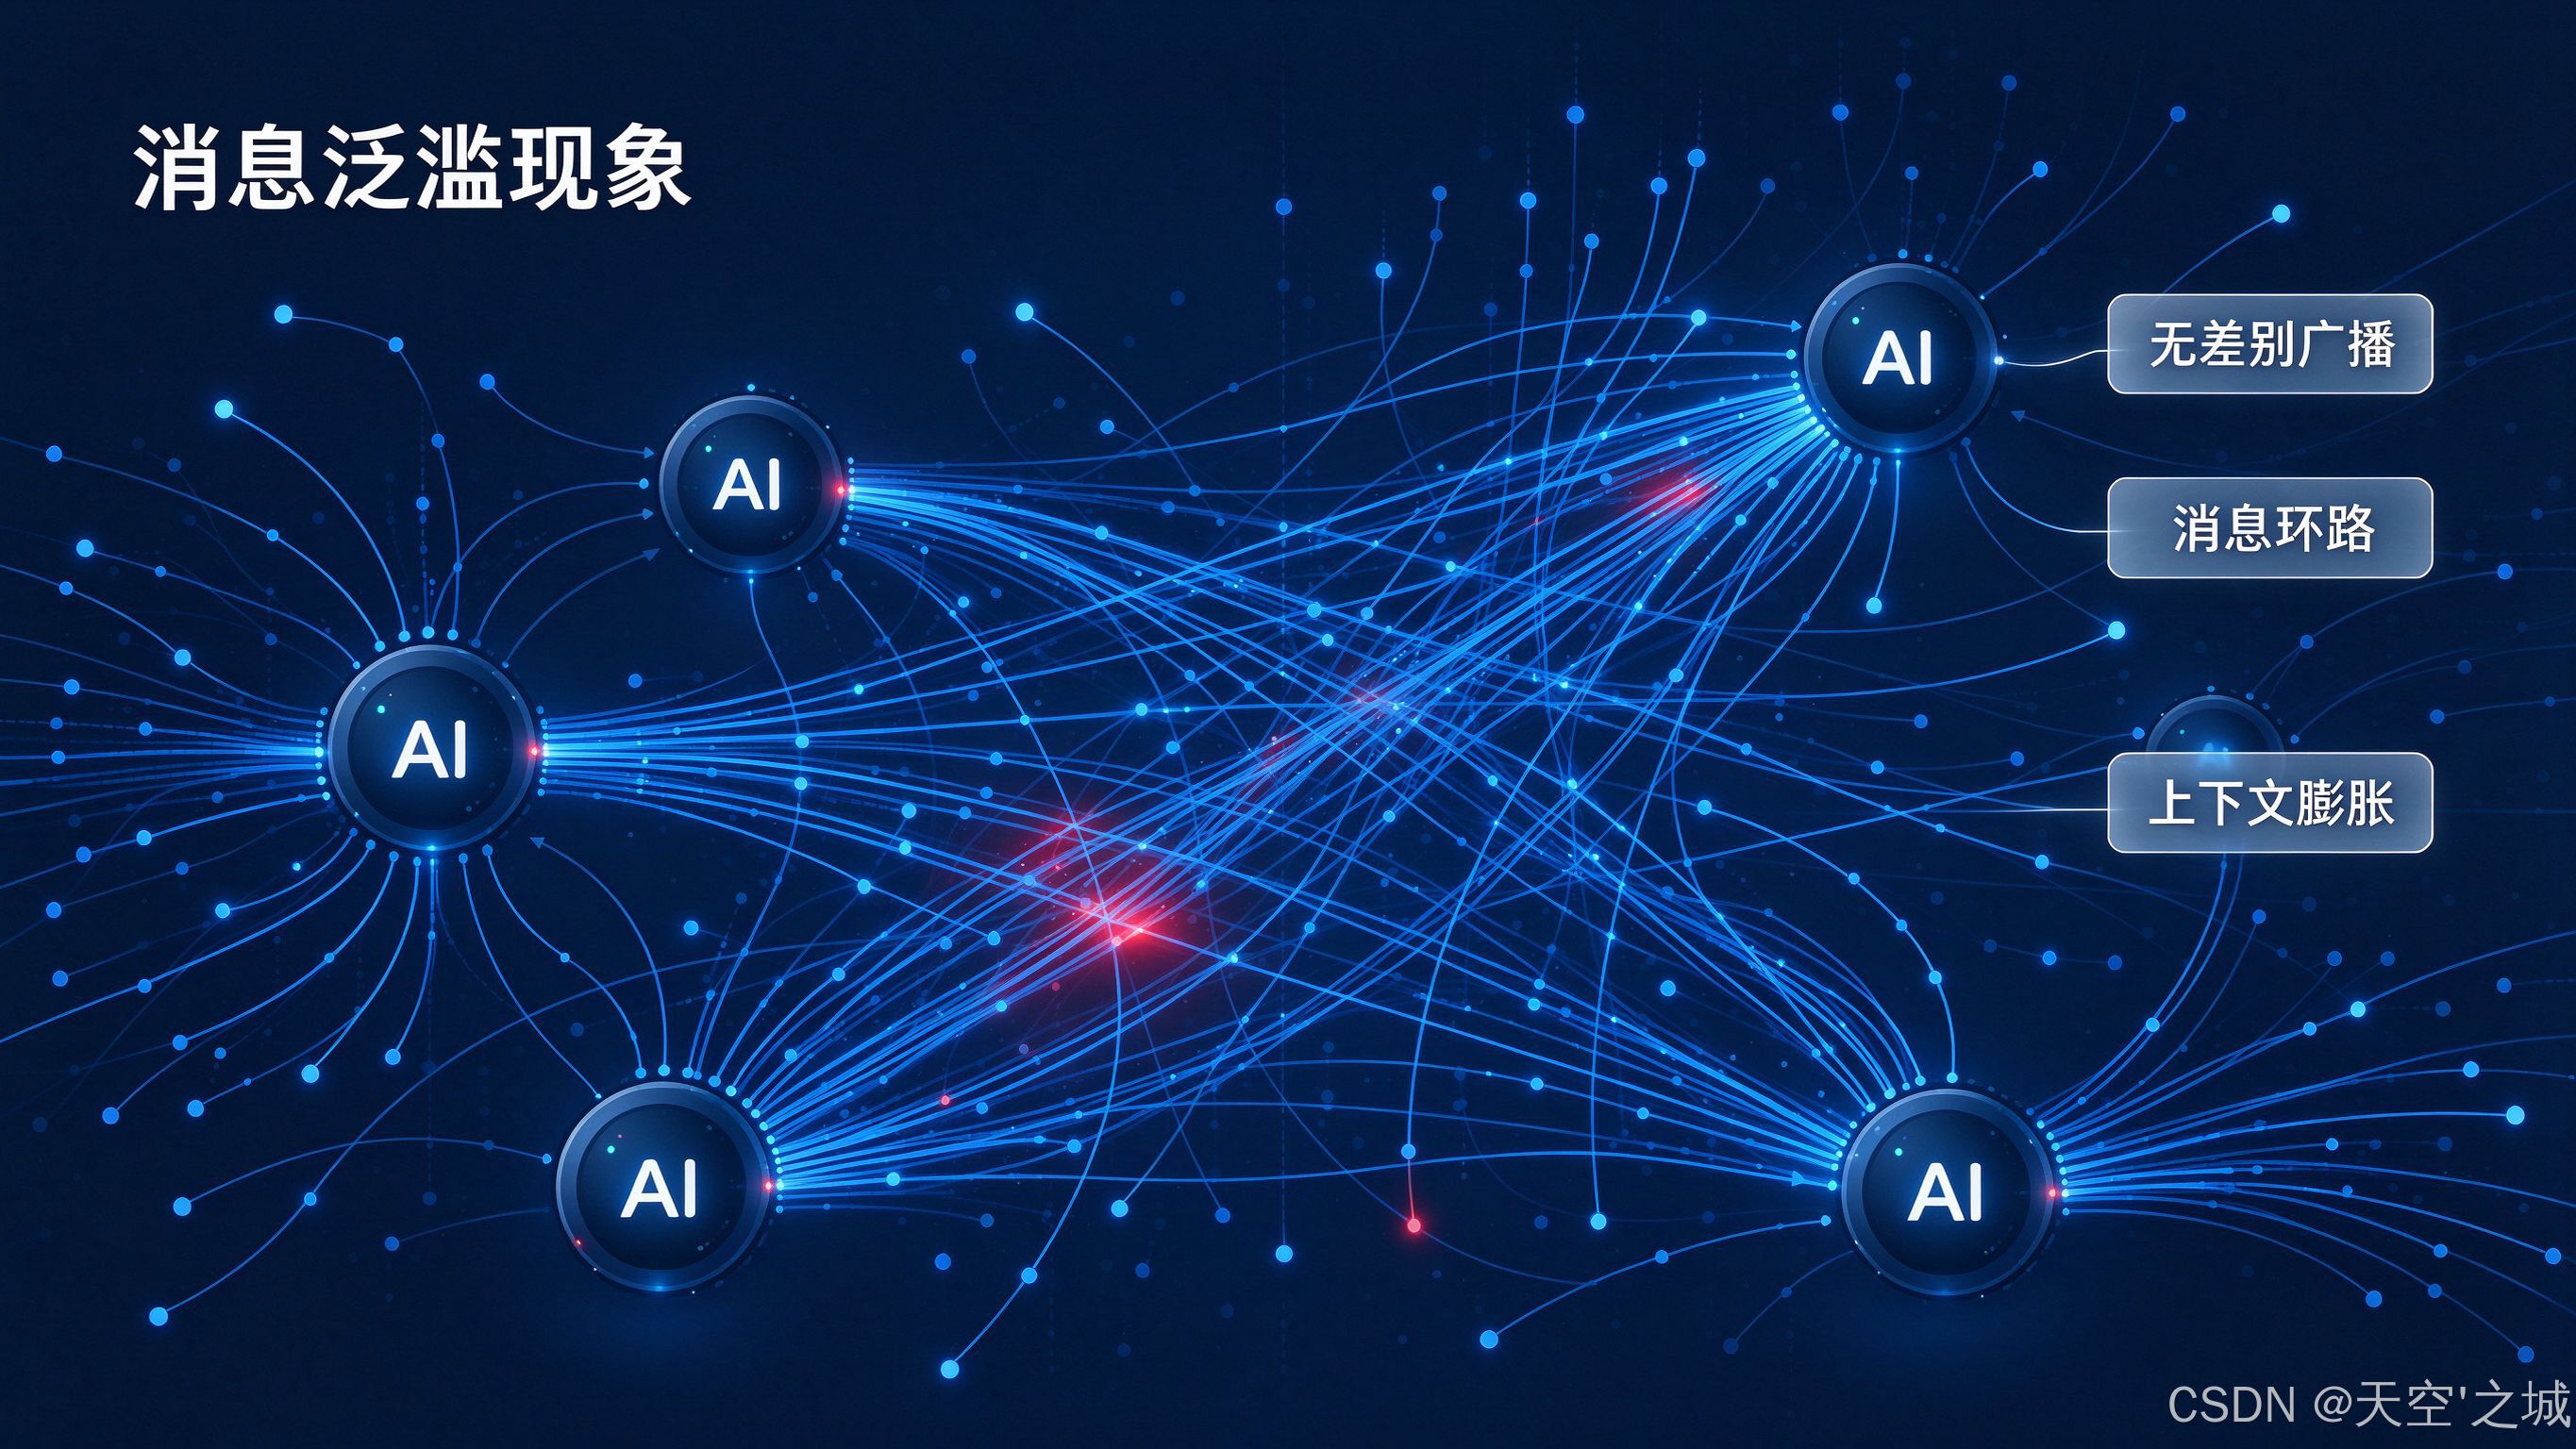
消息泛滥主要分为三类典型表现:无差别广播扩散、消息环路死循环、消息无过期累积。
案例 1:文档解析多智能体业务
Master 指挥官负责任务拆分,多个 Worker 智能体分别完成文档片段解析。简易实现中 Worker 处理完子任务后将结果广播给到全部 Agent 实例。Worker 数量较少时看不出开销;当 Worker 扩容至 8‑12 个,每一条子任务结果复制推送至所有 Agent,上下文持续堆积,整体 Token 消耗数倍上涨。
案例 2:消息环路死循环
Master 下发查询指令,Worker 返回异常报文。缺少路由管控逻辑,异常消息被广播回 Master;Master 误识别为全新业务请求,再次发起一轮调度任务,形成闭环自循环。业务侧没有新输入,大模型调用持续不断。
消息泛滥底层根因
三、四类多智能体通信模式对比
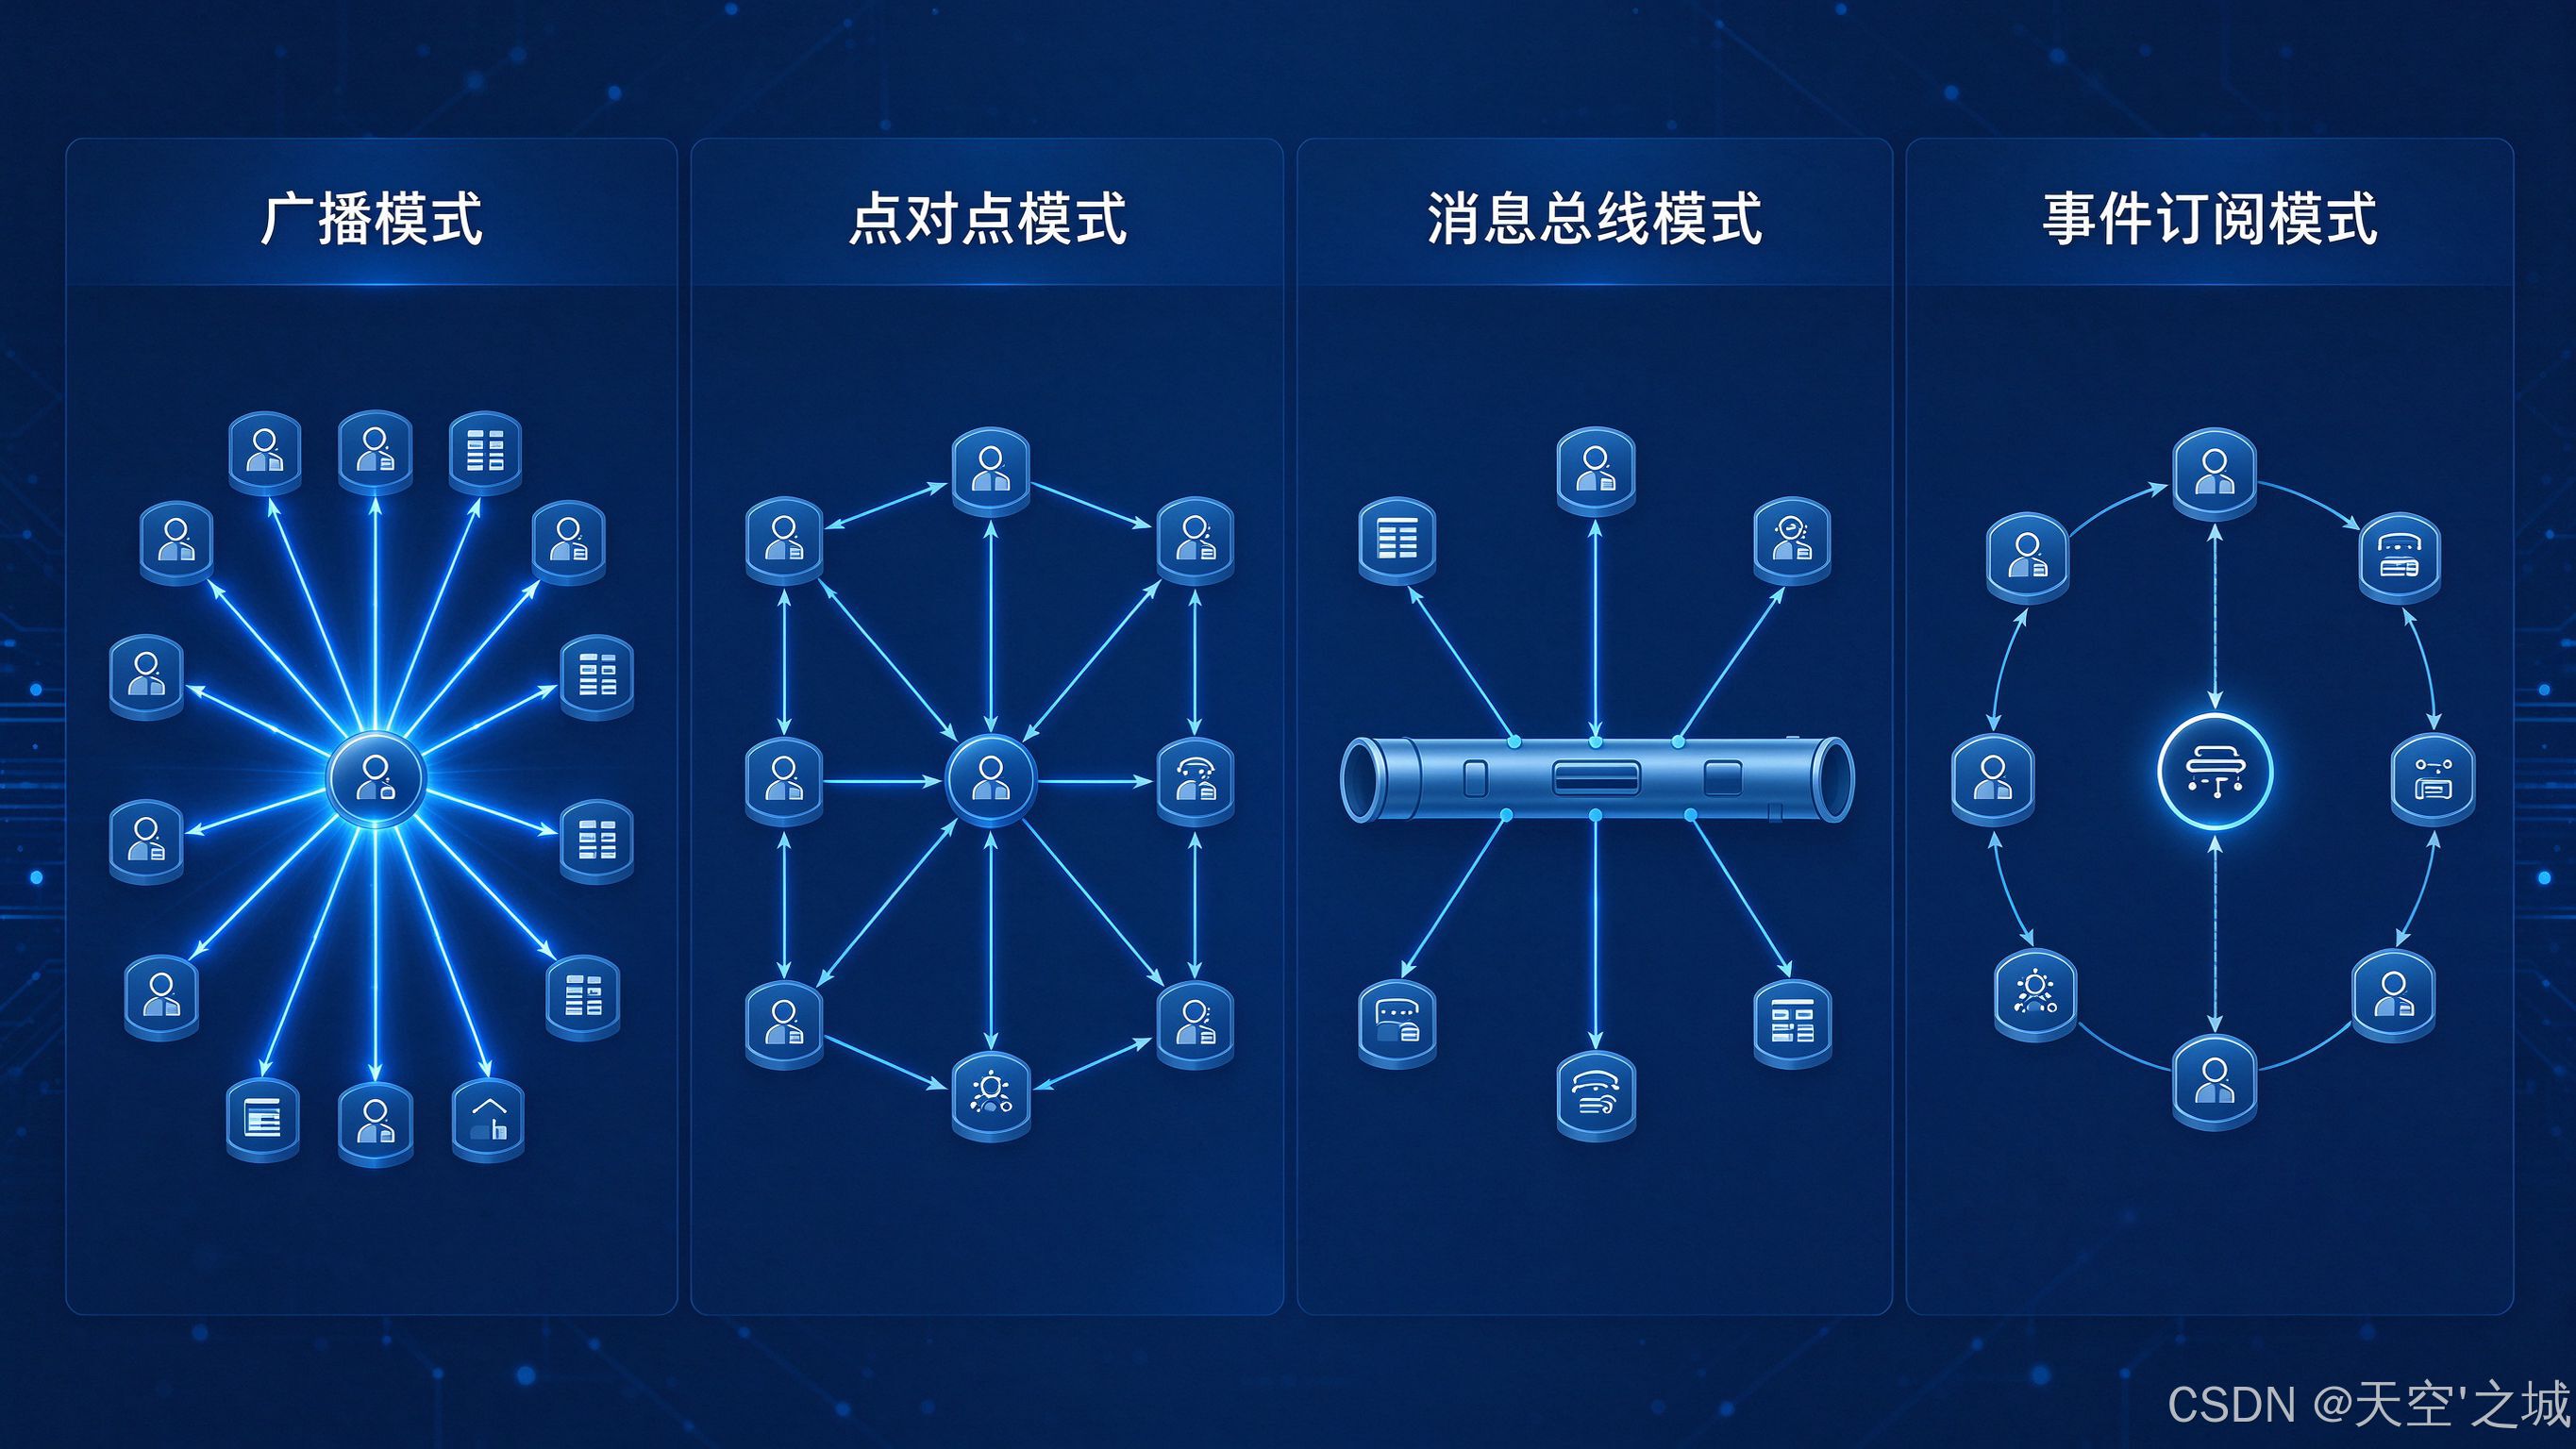
1.广播模式
- 所有消息推送全部 Agent 实例。
- ✅优点:实现简单,适合快速写 Demo
- ❌缺点:极易诱发消息泛滥,并发场景资源爆炸,生产环境尽量禁用无条件广播
2.点对点模式
- 消息明确指定发送方与接收方,一对一定向投递。
- ✅优点:减少无关消息流转
- ❌缺点:Agent 实例规模变大之后,维护对象关系复杂度提升;一对多场景需要循环发送
3.消息总线模式
- 所有 Agent 不再直接互相通信,全部消息投递至独立消息总线组件;总线统一完成路由分发、过滤、去重、TTL 管控、熔断保护。
- ✅优点:通信逻辑解耦收敛,业务 Agent 聚焦业务逻辑,便于增加监控统计
- ❌缺点:引入新组件,增加一部分开发工作量
4.事件订阅模式
- Agent 根据事件类型完成订阅,总线按照事件类型分发消息,而非基于 Agent 实例 ID 分发。
- ✅优点:事件驱动,新增 Agent 无需修改路由配置
- ❌缺点:前期需要完整梳理事件体系,设计成本较高
工程实践结论:基于 Master‑Worker 架构做业务落地,优先引入消息总线作为通信管控层。
四、消息总线核心能力设计
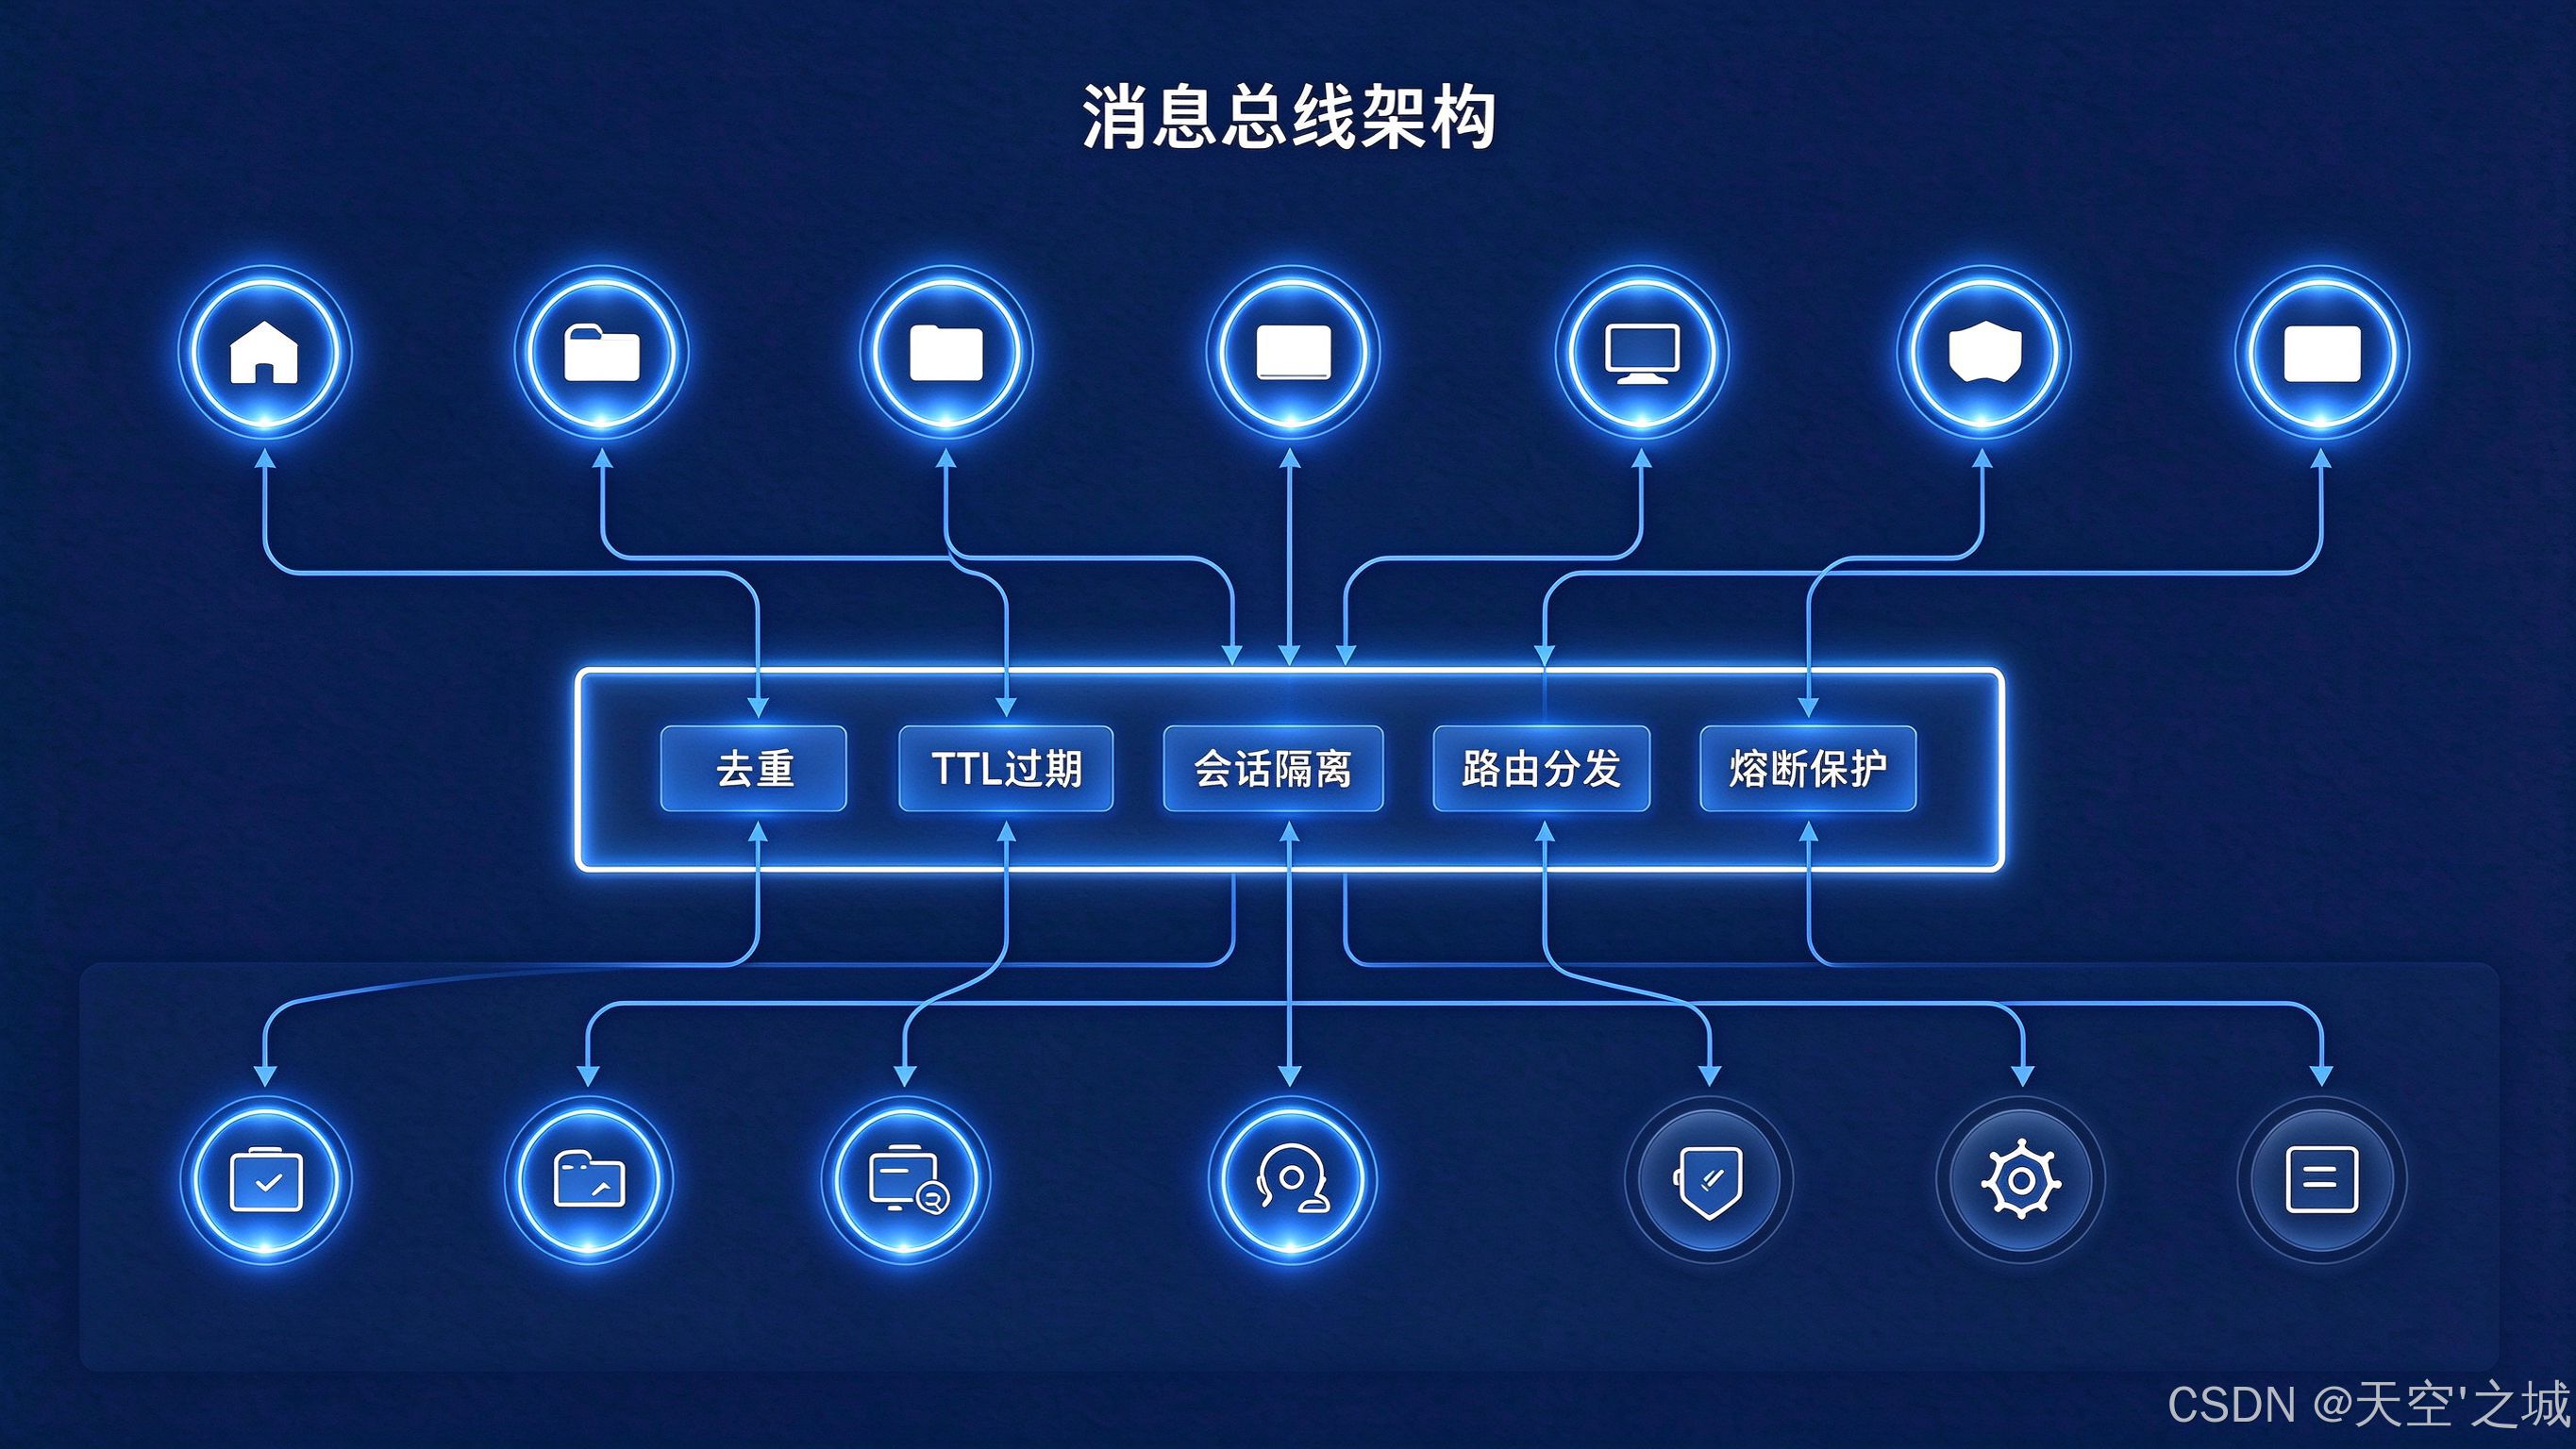
面向多智能体场景,消息总线需要具备核心能力:
import time
class AgentMessage:
def __init__(self, message_id, session_id, sender, target_ids, event_type, payload, ttl=10):
self.message_id = message_id
self.session_id = session_id
self.sender = sender
self.target_ids = target_ids
self.event_type = event_type
self.payload = payload
self.ttl = ttl
self.create_ts = time.time()
class MessageBus:
def __init__(self):
self.msg_store = {}
self.session_msg_counter = {}
self.max_session_msg = 50
def is_expire(self, msg:AgentMessage):
return time.time() – msg.create_ts > msg.ttl
def is_duplicate(self, msg_id):
return msg_id in self.msg_store
def publish(self, msg:AgentMessage):
if self.is_duplicate(msg.message_id):
return []
cnt = self.session_msg_counter.get(msg.session_id, 0)
if cnt >= self.max_session_msg:
return []
self.session_msg_counter[msg.session_id] = cnt + 1
self.msg_store[msg.message_id] = msg
if self.is_expire(msg):
return []
return self.dispatch(msg)
def dispatch(self, msg:AgentMessage):
deliver = []
for tid in msg.target_ids:
deliver.append((tid, msg))
return deliver
提示:以上为内存版演示代码,不可直接用于线上生产。真实业务场景建议替换 MQ 中间件,补充持久化、告警、监控指标。业务层禁止 target_ids 为空实现全局广播逻辑。
五、工程落地权衡思考
六、结尾
绝大多数多智能体优化工作,开发者会把重心放在业务逻辑、提示词调优。通信层往往属于容易被忽略的短板。Demo 阶段可以随意广播,上线生产环境,消息泛滥、消息环路会持续消耗 Token 与显存资源。想要 Master‑Worker 架构稳定运行,消息总线通信管控是必不可少的防护组件。


评论前必须登录!
注册