 网硕互联帮助中心
RRSI 的核心贡献不在于"让 harness 演化得更强",而在于把 harness 演化从"在演化集上刷分"改成"在分布外仍成立的机制搜索"。最硬的证据来自 agentic workspace:OOD 均分由 H0 的 39.7 提升至 43.6,而各基线均值约 39.4;表 2 同时显示,去掉任一侧正则都会抬高演化集分数却压低 OOD 表现。代价也清楚:最终 harness 为 2.42M policy tokens/trial,低于无正则演化的 3.80M,但仍高于 H0 的 1.56M。
这份结论的成立边界同样重要:
它只覆盖主干模型冻结、有限留一域基准与受控搜索预算,不能据此推断为通用长期自主 RSI。
一句话本质:RRSI 把经典 ML 的"训练/测试分离 + 正则化"第一次系统搬到了 harness 进化这个外层循环上——它发现 harness 进化本质是"在有限 evolve 集上反复做经验优化",必然过拟合,于是不限制"能改什么",只在提出端控预算、选择端控准入。
最该记住的 3 件事:
批判(对架构师视角):
- 这是经验/系统论文,不是理论论文——L0/L1/L2 是定性类比,无泛化界;
- 全程无置信区间,主实验单一策略族(Claude Opus 4.8),超参对 domain 很敏感;
- critic 只能拦"写死任务名/答案"这类显式泄漏,隐式过拟合难根除;
- 复现门槛是算力:每个候选要在 evolve 集上跑多次真实 agent rollout。
对你做 Agent 平台的迁移价值:选择端四道闸 ≈ agent 自改进的控制面/变更治理层(可审计、非补偿准入、可回滚),和 Palantir 式决策门同构;可直接抄的 pattern 是:余弦退火编辑预算、给每个 diff 结构化记账 (组件,假设,ΔS,ΔC,是否采纳)、窗口化无贡献组件剪枝、成本-增益线性闸门 ΔC ≤ β0+β1·ΔS。
完整论证链、消融数字、失效条件和复现路径都在报告里。
DeepThink 是你的开源免费自由使用的私有 AI 操作系统 (AI OS),在安全隔离的沙箱环境中,自主执行代码、管理文件、完成超复杂长程任务。自托管的多用户本地 AI Agent Loop Engineering 系统 (支持桌面端+浏览器+移动端) —— 让 DeepThink 成为你的全能数字助手。 —— Powered By AI Genius Institute & 光剑AI
DeepThink 项目开源代码(如果你觉得好玩,就一起来玩, Star 一下): Gitcode: https://gitcode.com/AIGeniusInstitute/deepthink Github: https://github.com/AIGeniusInstitute/deepthink
- DeepThink v1.5.0 — Agent 群组协作(Swarm)执行链路贯通
把 v1.4.0 交付的 Agent 群组协作(Swarm)从"能看"变成"能跑": 群组消息真正驱动图谱执行,席位回复逐字流式回传并归属到席位, 席位继承本轮的技能 / MCP 工具 / 知识库。
- 群组消息零执行 → swarm 即 graph_definition,消息触发图谱运行
- 席位级流式输出(前端从只认 group_message_created 改为 group_message_delta)
- 席位挂载能力与普通对话对齐(复用同一 workspace 挂载 store / selectedMounts)
- 执行模式继承(不再静默回落 container)+ 冷启动不再吞掉新工作区首条消息
- 图谱引擎仅新增两个可选 Hook(onNodeSettled / onNodeStream), 未接线时为 no-op;无新增引擎 / 中间件 / 依赖
Schema v70 → v70(无变更) · 发布说明见 docs/release_notes/v1.5.0.md
- DeepThink v1.4.0 — 分布式能力落地与企业协作工作负载
将 v1.3.0 打下的 K8s 云原生基座真正落到业务面:配置全量迁 PostgreSQL、 工作区文件入 MinIO/S3、分布式 agent-runner 调度闭环、跨 Pod 挂载上下文修复; 并在此之上交付四大企业级能力——数字员工协作工作台、AgentNet 网盘、 评测中心、Agent 群组协作(Swarm)。
Schema v60 → v70 · 发布说明见 docs/release_notes/v1.4.0.md
- DeepThink v1.3.0 — 云原生与协作
v1.3.0 是一个云原生与协作版本:从单机多智能体编排跃迁到 K8s 全量无状态化 + 横向多 Pod 扩缩容 + 多人协作工作 + 平台能力深化。
核心交付:
- 云原生:K8s 云端部署 → 横向多 Pod 无状态化(Redis 事件总线 + 分布式选主 + PostgreSQL 同步桥)→ Agent IPC Redis + Agent Runner 独立 Service → Phase 3 生产化(pgvector/对象存储/Litestream 灾备) → 全量无状态化缺口审计闭环 + 共享并发计数器
- 多人协作工作能力(编排者-工作者 / 对等 / 批评对抗 3 模式 + 群共享工作区)
- 平台能力深化(全过程 Trace / 校验节点与 Hooks / 测试评测 / Skills 版本管理)
- 企业级工具治理与最小权限基线(副作用分级 / 幂等键 / 审计 / 限流 / 凭据加密)
- PG INTEGER→BIGINT 时间戳溢出修复 + 本机持久化存储栈
- 一级导航简化至 7 项
发布说明:docs/release_notes/v1.3.0.md
文章目录
- 《RRSI:智能体 Harness 的正则化递归自我改进》深度精读
-
- 0. 一句话本质
- 1. 结论速览(先给判断)
- 2. 研究故事:它到底在解决什么问题
- 3. 方法机制:两端六道闸
- 4. 关键证据:数字背后真正在说什么
-
- 4.1 核心交换:主动牺牲 evolve 分,买 OOD(表 1)
- 4.2 消融:正则化确实在做 "反直觉" 的事(表 2)
- 4.3 可迁移性:机制不属于某个模型(表 3 / 表 4)
- 4.4 成本(图 4)
- 5. 反直觉结果与失效条件(主动找问题)
- 6. 可信边界、局限与复现风险
- 7. 对你(AI Agent 架构视角)的可迁移洞察
- 8. 阅读范围与信息边界
- RRSI:智能体 Harness 的正则化递归自我改进
-
- 摘要
- 1. 引言
- 2. 预备知识
- 3. RRSI
-
- 3.1 Harness 进化的正则化视角
- 3.2 正则化提出分布
- 3.3 正则化候选选择
- 4. 实验
-
- 4.1 实验设置
- 4.2 主要结果
- 4.3 分析
- 5. 相关工作
- 6. 结论
-
- 局限性
- 参考文献
- 附录
-
- A. 评估
- B. 基线方法
- C. 方法细节
- D. 实验
- E. 定性案例研究
《RRSI:智能体 Harness 的正则化递归自我改进》深度精读
原文:
RRSI: Regularized Recursive Self-Improvement of Agent Harnesses
,Peng Xia 等,Google Cloud AI Research / UNC / Stanford / WUSTL,arXiv:2609.24972v1,2026-09-22。 代码:
github.com/google-research/rrsi
・ 主页:
regularized-rsi.com
0. 一句话本质
RRSI 把经典机器学习里 “训练 / 测试分离 + 正则化” 这套方法论,第一次系统地搬到了 “harness 进化” 这个外层优化循环上。 它指出:harness 进化不是在 “造更好的智能体”,而是在一个高表达力搜索空间里、对一个有限的 evolve 集反复做经验优化—— 这个动作本身就会过拟合;于是它不限制 “harness 能改什么”,只在提出端怎么花预算和选择端什么改动能永久保留两处加正则,用主动牺牲少量 evolve 集分数,换来真实的分布外迁移和更低的 token 成本。
1. 结论速览(先给判断)
| 真正贡献 | 不是新模型 / 新数据,而是诊断 + 一套进化外层治理规则:把 harness 过拟合形式化,并给出可工程化的 propose/select 正则化器 |
| 最可信发现 | 正则化不仅没牺牲泛化,反而主动买到了泛化:RRSI 在 evolve 集上只涨 1.1 分(所有被进化 harness 里最小),OOD 均值却从 39.7 升到 43.6(唯一显著超过 𝐻₀ 一分以上的),同时 token 从 3.80M 降到 2.42M |
| 最强证据 | 跨骨干迁移(表 3/4):用 Gemini 3.5 Flash 进化出的 harness,原封不动拿到从未参与搜索的 Gemini 3.1 Flash Lite 上,仍从 11.2→14.6。这证明学到的是 “可复用机制” 而非 “对某个策略的拟合” |
| 论文类型 | 经验性 / 系统论文(empirical),不是理论论文——L0/L1/L2 是定性类比,作者自己明确承认无泛化界、无 regret bound |
| 最大软肋 | 全程无置信区间 / 显著性检验;主实验单一策略族(Claude Opus 4.8);超参对 domain 敏感;“隐式泄漏” 能否被 critic 根除存疑 |
| 值不值得跟进 | 值得作为 baseline 复现(代码开源),但搜索成本极高(每个候选要在 evolve 集上跑多次 agent rollout) |
2. 研究故事:它到底在解决什么问题
把论文从 “逐节摘要” 还原成一条论证链:
现代 LLM 智能体 = 冻结骨干 + Harness(提示词/控制流/工具/记忆/上下文管理)
│
▼
近期进展大多来自 Harness 工程,而非新权重;但这靠人工读失败轨迹,天花板低
│
▼
于是大家用 LLM 自动进化 harness:proposer 改 → 在 evolve 集上打分 → 分高就留下
│
▼ 【论文的核心观察】
这个循环在统计上有个致命性质:evolve 集被跨轮次反复复用。
第 t 轮提出的候选,依赖第 t-1 轮在同一批任务上测到的结果。
── 这就是 Dwork et al. (2015) 的 "adaptive data analysis / holdout reuse":
每多看一眼有限数据,有效样本量就被"消耗"一次。
│
▼
后果(图 1a 实证):evolve 集分数虚高,但 OOD 不涨甚至低于初始 harness 𝐻₀。
四种此前方法里,最强的 Meta-Harness 在 OOD 均值上只 +0.9,TTHE 反而 -1.7。
"gain does not transfer" —— 提升是拟合,不是能力。
│
▼
【洞察】过拟合不是来自某个组件写错,而是三种耦合行为:
① benchmark-specific fitting(编码任务/实体/答案进了提示词)
② noise chasing(把随机波动当信号)
③ complexity accumulation(堆无用复杂度换 evolve 分)
│
▼
【方法】RRSI 不限制编辑空间 Ω(H)(提示词/控制流/工具/记忆/子智能体全开),
只对"搜索轨迹"加正则:提出端控预算,选择端控准入。
关键洞察(最该带走的一句):harness 进化的过拟合,和神经网络在小数据集上过拟合是同构问题—— 区别只在于,这里的 “参数” 是一段可编辑的程序(harness),“训练集” 是一个 evolve benchmark。所以经典 ML 的正则化武器库可以整体平移过来。
3. 方法机制:两端六道闸
RRSI 的精妙在于把正则化拆到进化循环的两端,而不是塞进 harness 内部。
┌─────────────── 提出端 Proposal(怎么花搜索预算)───────────────┐
│ A 退火更新稀疏性 b\\_t 余弦退火:早期允许捆绑多改动,后期强制稀疏可归因 (≈L0)│
│ B 证据感知信用分配:每个 diff 绑定 组件+假设+ΔS+ΔC+是否被接受; │
│ 已证伪的假设不再重复烧预算 │
│ C 结构化探索:进展停滞(连续 w 轮落在噪声带 δ 内)时, │
│ 把预算拨给从未被试过的组件类型 (≈熵/多样性正则) │
└──────────────────────────────┬───────────────────────────────────┘
▼ 候选 H'
┌─────────────── 选择端 Selection(什么能成为永久状态)──────────┐
│ D 泄漏筛查 critic:完整评估前,拒绝写死任务名/实体/答案/特定逻辑 │
│ E 噪声调整底线:Ŝ(H') ≥ S★ − δ(不许沿一串小退步下坡走) │
│ F 复杂度感知接受:ΔC ≤ β0 + β1·ΔS(成本必须被增益背书,≈Ridge L2) │
│ G 结构化剪枝:n\\_prune 窗口内无正贡献的组件,标记为删除目标 (≈Lasso L1)│
│ + 领域守卫:工程设计里 valid-output 暴跌/无提交率飙升则一票否决 │
└──────────────────────────────────────────────────────────────────┘
为什么是 “非补偿性 (non-compensatory)” 四道闸? 这是设计的灵魂:一个候选先过 D(无泄漏)→ 再过 E(过噪声底线)→ 再过 F(成本合理)→ 再过 G / 领域守卫,任何一道不过就直接淘汰,不允许用一方面的高分补偿另一方面的不及格。这从结构上杜绝了 “靠堆复杂度在 evolve 集多拿几分、却把泄漏 / 退步 / 高成本藏起来”。
每个模块解决什么困难(删掉会怎样):
-
A 退火预算:不做的话,proposer 会把一堆无关改动捆进一个候选,有效容量爆炸,且任何测得变化都无法归因。删掉后 = 表 2 里 “未正则化进化”。
-
E 噪声底线 δ:不做的话,选择器会把随机赢家固化成永久状态 —— 这正是 “在同一 evolve 集上反复评估” 的统计代价。
-
F 成本 – 增益权衡 (β0+β1ΔS):不做的话,无约束的 “解的整体幅度” 会膨胀(对应 harness 的 token 占用)。这就是为什么 RRSI 反而更便宜。
-
G 结构化剪枝:不做的话,只增不减,harness 越来越臃肿;L1 的对应物就是 “无贡献组件整体删除”。
4. 关键证据:数字背后真正在说什么
4.1 核心交换:主动牺牲 evolve 分,买 OOD(表 1)
| 𝐻₀(不进化) | 89.4 | 39.7 |
| Meta-Harness(evolve 分最高) | 93.0 | 40.6(仅 +0.9) |
| AHE | 90.7 | 38.8(−0.9) |
| TTHE | 91.1 | 37.9(−1.7,低于起点) |
| HarnessX | 91.8 | 39.0(≈回到起点) |
| RRSI | 90.5(evolve 涨得最少) | 43.6(+3.9,唯一真正迁移) |
解读
:这张表是全文的题眼。所有 prior 方法都在 evolve 集上 “考得好”,但一到 OOD 就露馅 —— 有的原地踏步,有的比不进化还差。RRSI 故意把 evolve 分压到最低,却换来了唯一可迁移的提升。
这正是正则化在监督学习里的标准故事:放弃一部分训练拟合,换测试集泛化。
4.2 消融:正则化确实在做 “反直觉” 的事(表 2)
| 未正则化进化 | 92.8(最高) | 40.3(≈𝐻₀) | 3.80M(最贵) |
| 去掉接受端正则 | 91.5 | 41.0 | 3.59M |
| 去掉提出端正则 | 90.7 | 41.9 | 2.69M |
| 完整 RRSI | 90.5 | 43.6 | 2.42M(最便宜) |
解读
:去掉任何一组正则,evolve 分都涨、OOD 都跌、token 都涨。两端都去掉时,evolve 分冲到全场最高 92.8,OOD 却几乎回到原点 ——
铁证:evolve 分和泛化在这里是对立指标
。
4.3 可迁移性:机制不属于某个模型(表 3 / 表 4)
-
换策略:Claude Opus 4.8 与 Gemini 3.5 Flash 各自独立进化,OOD 都涨(+1.8 / +2.2)。
-
换从未参与搜索的更弱骨干:Gemini 3.5 Flash 进化的 harness,拿到 Gemini 3.1 Flash Lite 上,11.2→14.6(相对 +30.4%)。
解读
:这是 “harness 是程序、不是权重” 的直接实验证据。一个只对搜索时所用策略有帮助的机制,是该策略的过拟合产物;而 RRSI 的改进能跨骨干存活,说明它装的是真机制。
对做 Agent 平台的人,这条意味着 harness 进化能力应沉淀为独立于具体模型的一层资产。
4.4 成本(图 4)
RRSI 每次试验 2.42M token / 26.3 步;prior 方法 2.69–3.82M token / 27.3–34.6 步。AHE 比 RRSI 多花 58% token,OOD 反而低 4.4 分。正则化不是花钱买泛化,而是靠删无用复杂度,既买了泛化又省了钱。
5. 反直觉结果与失效条件(主动找问题)
evolve 分越低越好:这与 “进化分数 = 进步” 的直觉相反,是全文最该被记住的反直觉点。
未进化的 𝐻₀ 常常 OOD 更稳:TTHE/AHE 进化后 OOD 反而跌 —— 说明盲目进化是负收益。
迁移不是裁判打分的假象:作者特意用工程设计(确定性仿真、无裁判模型)复现了同样的增益,堵死了 “靠讨裁判喜欢提分” 这条解释。
仍存在的失效:evolve 集提升越大,OOD 留存率越低(图 1a 的 1:1 虚线);RRSI 自己也只做到约 4.3% OOD / 2.5% evolve,远没到 “完全迁移”。
案例研究(表 6)暴露边界:编码 R8-B 那个候选把任务指令钉进完成门,成本降 13.6%,但因性能 −2.81 仍被底线拒绝 ——单靠省钱不能兜底;而工程 R2 那个小的控制流修正(+1.6% token)却被保留,因为它是小而可复用的机制。
6. 可信边界、局限与复现风险
作者明确承认的局限:
-
只做冻结骨干下的 harness 级 RSI,不涉及进化中更新模型权重;
-
仍依赖有限 evolve 集和若干正则超参,效果依赖反馈质量与搜索预算;
-
跨 domain/benchmark/ 策略做了迁移,但未验证差异巨大的 agent 架构、工具生态和更长时程的自改进。
我根据证据推断的局限(更要紧):
无统计显著性:每任务仅 k=2~4 次试验,全文无置信区间 / 误差棒。OOD +1.8~4.7 分是否稳健,无法从论文判断。
超参对 domain 敏感:β1 在三个 domain 取 44.5 / 35.4 / 24.4,δ 取 0.017 / 0.004 / 0.020,差异很大。换 domain 必须重新校准,“开箱即用” 性存疑。
“正则化” 是工程规则不是证明:L0/L1/L2 是定性类比,无泛化界。这是一篇经验系统论文,别当理论论文引用。
critic 只能抓显式泄漏:D 闸靠一个 LLM critic 读 diff,只能拦 “写死任务名 / 答案” 这类显式过拟合;提示词里藏进 benchmark 风格线索这类隐式过拟合,critic 很难识别。
搜索成本极高:每个候选要在整个 evolve 集上跑 k 次真实 agent rollout,20–40 轮 × 多候选 —— 复现的主要门槛是钱和算力,不是算法。
进化时程短:20–40 轮离 “长时程、成百上千轮的递归自我改进” 还很远,δ 在长程下是否仍然合理未验证。
复现第一批动作:① 跑通开源 repo 的 coding 单域(Terminal-Bench + SWE-bench OOD);② 复现表 2 消融,确认 “去正则→evolve 涨 / OOD 跌 /token 涨” 的方向;③ 给关键 OOD 数字补多次重复,估计置信区间。
7. 对你(AI Agent 架构视角)的可迁移洞察
把 evolve 集看作 “训练缓存”,反复读就会污染。 这和你把 Context Window 类比缓存层级是对偶的:δ(噪声底线)本质是 “读穿缓存后,必须停止把波动当信号”。任何 “用固定反馈集反复改进 agent” 的系统,都该内置一个 “有效样本量消耗” 的概念。
Harness 是程序资产,可跨模型沉淀。 表 4 给了实验支撑:harness 层的机制改进不绑定具体骨干。这意味着你做 Agent OS / 平台时,harness 进化与治理应作为独立于具体模型版本的一层,而不是每次发模型重写一遍。
选择端四道闸 = Agent 的 “控制面 / 变更治理层”。 critic(泄漏审查)→ noise floor(稳定性)→ cost-gate(性价比)→ domain guard(领域红线),和企业级 AI OS 需要的可审计变更治理、非补偿性准入同构。这正是 Palantir 式 “决策门 / Ontology” 在 agent 自改进场景的对应物:每个对生产 harness 的改动都要留痕、过闸、可回滚。
可直接工程化的 pattern:
-
余弦退火编辑预算 b_t = b_min + (b_max−b_min)·½(1+cos(πt/T));
-
给每个 diff 结构化记账:(组件ℓ, 假设h, diff, ΔS, ΔC, 是否被接受),作为 proposer 的条件上下文;
-
固定窗口 n_prune 内无正贡献的组件→删除目标;
-
成本 – 增益线性闸门 ΔC ≤ β0 + β1·ΔS,防止 token 占用无约束膨胀。
8. 阅读范围与信息边界
-
本解读基于用户提供的完整 24 页 PDF(正文 + 附录 A–E + 算法 1/2 + 表 1–6),非仅凭摘要。
-
数字均出自原文表 / 图;第 6 节 “推断局限” 为分析者判断,非论文原文。
-
未联网核对 repo 实际实现与超参代码;复现可行性以作者公开材料为准。
RRSI:智能体 Harness 的正则化递归自我改进
RRSI: Regularized Recursive Self-Improvement of Agent Harnesses
Peng Xia¹·²*, Rujun Han¹, Zifeng Wang¹, Yanfei Chen¹, Yufan Zhang¹, Yoonho Lee³, Chengsong Huang⁴, Han Yu¹, Zhongying CuiZhu¹, Yifei Ming¹, Huaxiu Yao², Burak Gokturk¹, Tomas Pfister¹, Chen-Yu Lee¹
¹ Google Cloud AI Research(谷歌云 AI 研究院);² UNC-Chapel Hill(北卡罗来纳大学教堂山分校);³ Stanford University(斯坦福大学);⁴ Washington University in St. Louis(圣路易斯华盛顿大学)
论文日期:2026-09-22 | arXiv:2609.24972v1 [cs.LG] 代码与主页:github.com/google-research/rrsi · regularized-rsi.com
摘要
LLM 智能体(agent)的能力,很大程度上是由其 harness(外壳/工作框架) 放大的——也就是包裹在冻结骨干模型之外的提示词(prompts)、控制流(control flow)、工具(tooling)、记忆(memory)与上下文管理(context management)。近期方法越来越多地通过迭代地提出并选择对 harness 的逐组件编辑,来自动化这一过程,实际上在"智能体系统"层面建立了一种递归自我改进(recursive self-improvement, RSI)。然而,这种递归式进化可能通过死记训练任务而过拟合:在分布内(in-distribution)基准上取得大幅提升,却在分布外(out-of-distribution, OOD)基准上缩水甚至消失。
我们提出 RRSI(Regularized Recursive Self-Improvement of Agent Harnesses,智能体 Harness 的正则化递归自我改进),通过约束进化候选的提出(proposal)与选择(selection),把正则化原则引入 harness 的自我改进。proposer(提出器)在一个随时间退火(temporally annealed)的预算下工作,限制单个候选能捆绑多少处编辑,并基于进化历史鼓励尚未探索过的路径;selector(选择器)则配备一个 critic(批评器)和一个 pruner(剪枝器):critic 过滤掉针对特定 benchmark 的提案,pruner 移除那些改动过小、成本过高或不再有用的变更。这些约束共同倾向于可复用的智能体机制,而非针对特定 benchmark 的改动、甚至噪声。
在横跨编码、智能体工作区(agentic workspace)与工程设计任务的八个 benchmark 上,RRSI 在其赖以进化的(evolve)数据集上最高提升 14.1 分,在五个分布外 benchmark 上最高提升 4.7 分;与此同时,其所产出 harness 消耗的策略 token 数量比未正则化的进化少 30%。
1. 引言
现代 LLM 智能体是"系统"而非孤立的模型(Lopopolo, 2026; Rajasekaran, 2026)。一个冻结的骨干模型被包裹在由提示词、控制流、工具接口、记忆与上下文管理构成的 harness 之中。harness 决定了同一个模型:在编辑文件前是否读对了文件、能否从失败的命令中恢复、能否高效地维护工作上下文、以及能否把发现写进交付物。近期智能体产品的许多进展来自 harness 工程,而非新的模型权重(Karten et al., 2026a; Weng, 2026; Zhang and Khattab, 2026)。然而这种工程依赖人工:人去检视失败的轨迹、手工调整脚手架(scaffold),进展受限于一个工程师能读多少条轨迹。
近期方法用 LLM 从任务反馈出发优化 harness 组件,从而自动化这个循环(Chen et al., 2026; Karten et al., 2026b; Lee et al., 2026a,b; Lin et al., 2026a; Lou et al., 2026; Nie et al., 2026; Niklaus, 2026; Zhang et al., 2026a,e)。这种迭代式的 harness 进化,在智能体系统层面提供了一种实用形式的递归自我改进(RSI)(RSI-Exam Team, 2026; Team et al., 2026; Wang et al., 2025; Zhang et al., 2026b):用当前系统的反馈去改进塑造其后续行为的 harness。然而,如图 1(a) 所示,测试期(test-time)harness 进化反复用一个有限的 evolve 数据集的反馈来提出并选择编辑,带来了"自适应过拟合"风险:evolve 集上的表现可能提升,却并未在未见任务上带来相应收益。近期研究观察到进化表现与留出(held-out)表现之间存在显著差距,并表明表面上的提升可能来自针对特定任务的拟合,或来自增加的测试期计算,而非可复用的机制(Ding et al., 2026; Lin et al., 2026b; Wang et al., 2026b)。相应地,近期工作显式地把进化任务与评估任务分开,以度量泛化能力(Huang et al., 2026d; Ke et al., 2026; Zhang et al., 2026d)。因此我们研究递归自我改进中的泛化问题,其定义为:进化后的 harness 能否迁移到任务描述、工具接口或验证器都不同的未见 benchmark 上。
我们的研究表明,过拟合会通过若干相互耦合的行为产生(Yang et al., 2026a; Zhang et al., 2026d):进化搜索可能编码特定 benchmark 的模式、推举被评估噪声偏爱的候选、或积累那些提高了 evolve 集分数却并未改进底层智能体机制的复杂度。这些"针对特定 benchmark 的拟合"“追逐噪声”"积累复杂度"都会拉大"进化—迁移"差距。受这些观察启发,我们的解决方案对"有限且带噪的反馈如何被用于递归式 harness 改进"加以正则化。
我们提出 RRSI,一个对智能体 harness 的 RSI 进行正则化的框架:它保持 harness 完全可编辑,同时约束有限的 evolve 集反馈如何引导搜索。如图 2 所示,RRSI 在进化循环的两端都施加正则化:在提出候选时鼓励更简单、更可复用的编辑;在选择时施加稳健的筛选标准,避免保留那些由特定 benchmark 信号、评估噪声或不必要复杂度驱动的"改进"。这样,RRSI 倾向于能迁移到 evolve 集之外的编辑,同时并不限制哪些 harness 组件可以被更新。
我们在横跨三个领域、任务类型/工具/验证器各异的八个 benchmark 上评估 RRSI。每个领域中,harness 只在一个套件(suite)上进化,然后原封不动地在留出 benchmark 上运行。如图 1(b–d) 所示,它在进化数据集上最高提升 14.1 分,并改进全部六个留出数据集,分布外最高提升 4.7 分,且消耗的策略 token 比未正则化进化更少。更重要的是,这些提升能泛化到进化所用环境之外:RRSI 在差异显著的任务与评估设置上都保留了改进,表明它学到的是广泛有用的 harness 改动。更重要的是,RRSI 在各留出环境上的泛化超过此前最佳基线平均值达 22.9%。
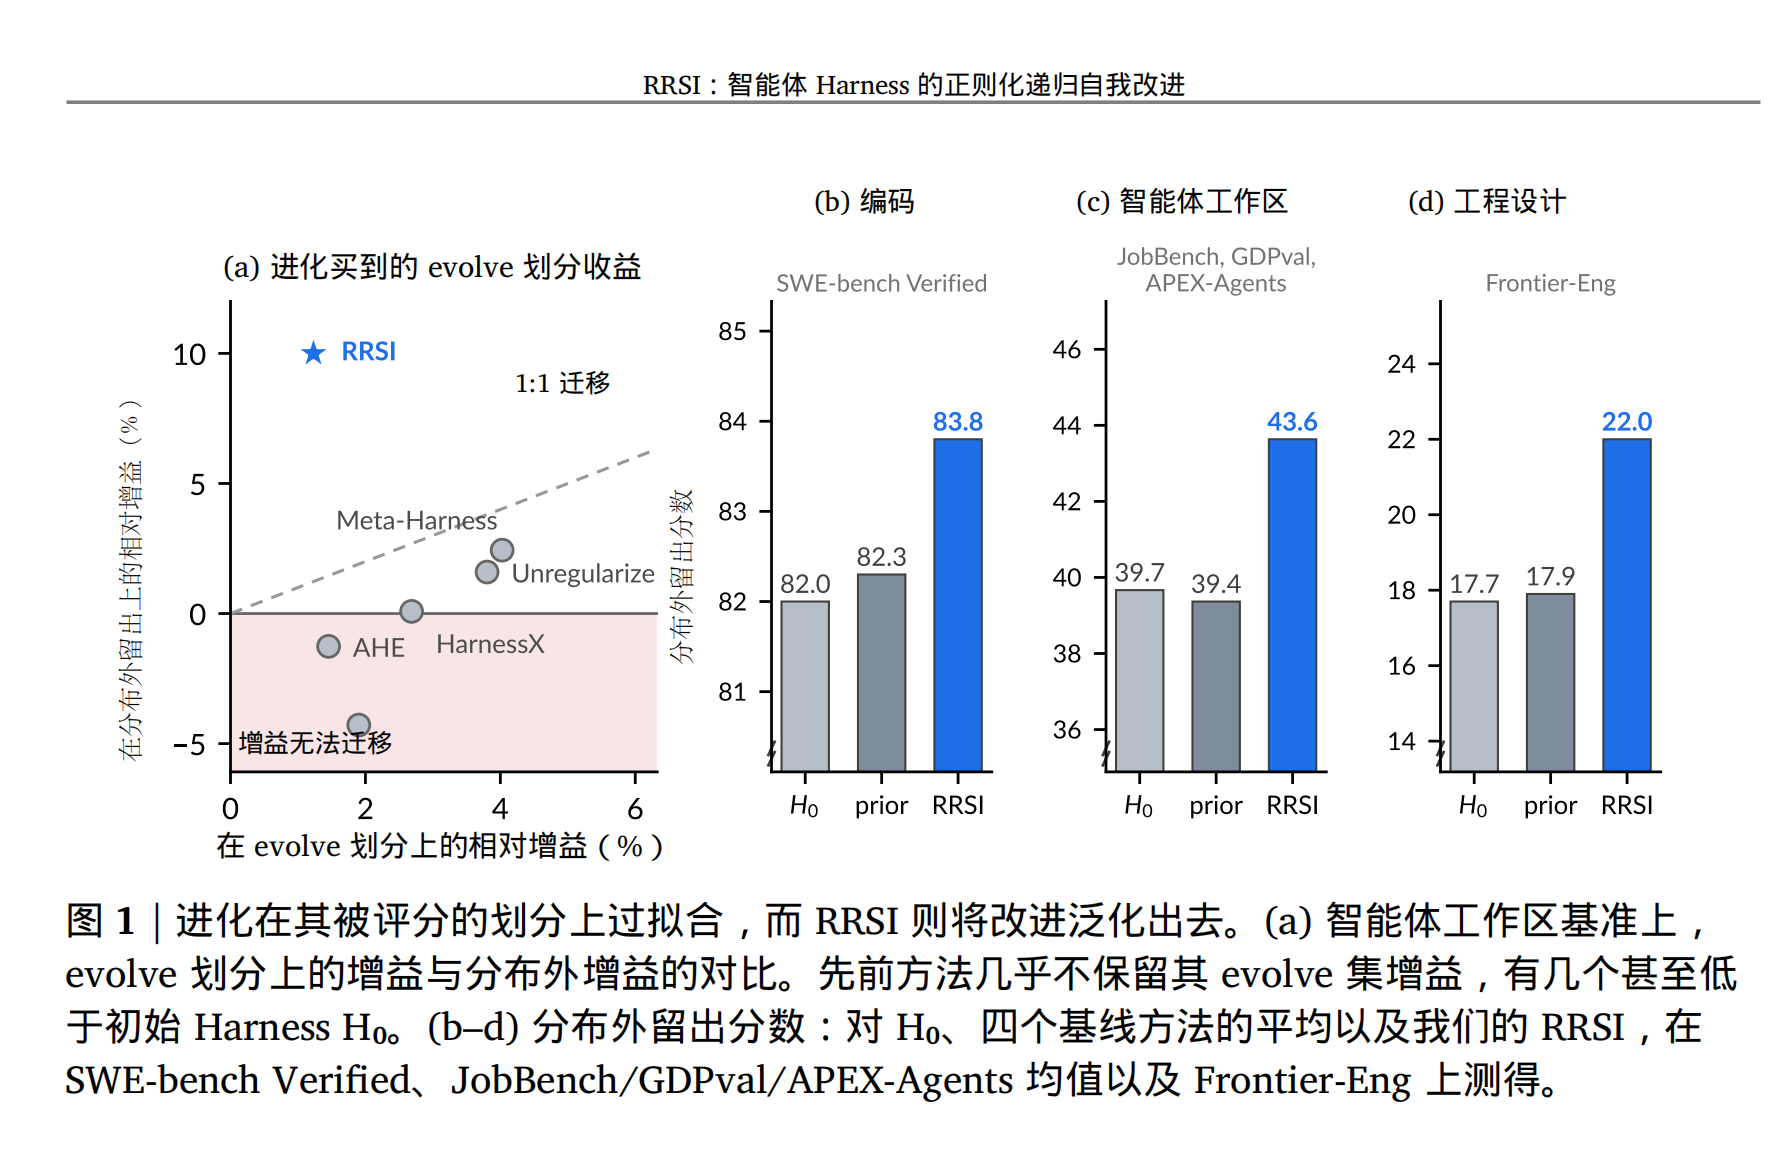
图 1|在"被打分的那个 split"上过拟合,而 RRSI 让改进得以泛化。 (a) 智能体工作区 benchmark 上,evolve split 上的提升 vs. 分布外提升。此前方法几乎留不住 evolve 集的提升,若干方法最终还低于初始 harness 𝐻₀。 (b–d) 𝐻₀、四种基线方法的平均、以及我们的 RRSI 在 SWE-bench Verified(编码)、JobBench/GDPval/APEX-Agents 三者均值(智能体工作区)、Frontier-Eng(工程设计)上的分布外留出分数。
核心信息:在 evolve split 上买来得越高的提升(横轴),分布外 held-out 提升(纵轴)却几乎传不过去——“gain does not transfer”。RRSI(蓝色星)在约 2.5% evolve 提升处换到了约 4.3% 的 OOD 提升,是唯一显著越过 1:1 transfer 虚线的方法。
我们的贡献有三:(1) 我们识别出 过拟合是 harness 式递归自我改进的关键挑战;(2) 我们提出 RRSI,在 harness 进化期间同时对"提出"与"选择"施加正则化,同时保持每个 harness 组件可编辑;(3) 在三个领域八个 benchmark 上,RRSI 同时提升了迁移能力与效率,证明了所提方法的有效性。
2. 预备知识
智能体与 Harness。 我们考虑一个由骨干策略 𝜋 与 harness 𝐻 构成的智能体 𝐴 = (𝜋, 𝐻)。harness 就是权重之外的一切(Lopopolo, 2026; Rajasekaran, 2026):系统提示词与任务提示词、决定智能体何时规划/行动/反思/停止的控制流、工具接口及其描述、智能体可查阅的记忆与技能文件、以及决定策略每一步能看到什么的上下文管理。给定任务 𝑥 及其环境,智能体产生一条轨迹 𝜏 ∼ 𝐴(· | 𝑥) 与一份交付物,由验证器打分 𝑟(𝑥, 𝜏) ∈ [0, 1]。验证器可以是编码环境中的单元测试套件,也可以是智能体工作区环境中的"LLM 当裁判"程序。对任务集 D,我们度量任务表现与策略 token 成本为:
𝑆(𝐻; D) = 𝔼_{𝑥∼D} 𝔼_{𝜏∼𝐴(·|𝑥)} [ 𝑟(𝑥, 𝜏) ], 𝐶(𝐻; D) = 𝔼_{𝑥∼D} 𝔼_{𝜏∼𝐴(·|𝑥)} [ 𝑐(𝜏) ] (1)
其中 𝑐(𝜏) 是该轨迹消耗的策略 token 数。
Harness 进化。 harness 进化把 𝐻 当作优化变量,同时固定骨干策略(Lee et al., 2026b)。多数方法实例化同一个通用循环:在第 𝑡 轮,用当前 harness 𝐻ₜ 在 evolve 集 D_evolve 上执行以获得轨迹;把这些轨迹汇总成反馈 Fₜ;由一个 proposer LLM 生成候选 harness;在同一个 evolve 集上评估候选;选出最佳候选作为下一任 incumbent(现任最佳)。抽象地:
𝐇ₜ = { 𝐻⁽¹⁾ₜ, …, 𝐻⁽ᵐᵗ⁾ₜ } ∼ 𝑃₀(· | 𝐻ₜ, Fₜ), 𝐻ₜ₊₁ = argmax_{𝐻′ ∈ 𝐇ₜ ∪ {𝐻ₜ}} Ŝ(𝐻′; D_evolve) (2)
其中 𝑃₀ 表示无约束的提出过程,Ŝ 是由有限次随机智能体运行得到的经验分数。每个任务跑 𝑘 次试验时:
Ŝ(𝐻) = 1/(𝑘|D_evolve|) Σ_{𝑥∈D_evolve} Σ_{𝑗=1…𝑘} 𝑟(𝑥, 𝜏⁽ˣ⁾,ⱼ), Ĉ(𝐻) = 1/(𝑘|D_evolve|) Σ_{𝑥∈D_evolve} Σ_{𝑗=1…𝑘} 𝑐(𝜏⁽ˣ⁾.ⱼ) (3)
与普通评估不同,这种对 D_evolve 的复用是自适应的:第 𝑡 轮提出的候选依赖于更早轮次在同一批任务上测得的结果。因此 harness 进化可视为在一个异常高表达力的搜索空间上做自适应经验优化。
3. RRSI
我们通过迭代式 harness 进化来研究 RSI:反复用当前智能体系统的反馈来提出并选择对 harness 的修改。RRSI 沿用这一递归改进过程、保持 harness 编辑空间开放,但对"搜索如何在该空间中移动"加以正则化。核心思想是把机器学习中的正则化原则迁移到自适应 harness 搜索中:稀疏更新限制一轮反馈能改动多少机制;证据感知的信用分配防止搜索反复把容量花在已被证伪的假设上;保守选择防止泄漏(leakage)、评估噪声或无依据的资源膨胀成为永久的 harness 状态。
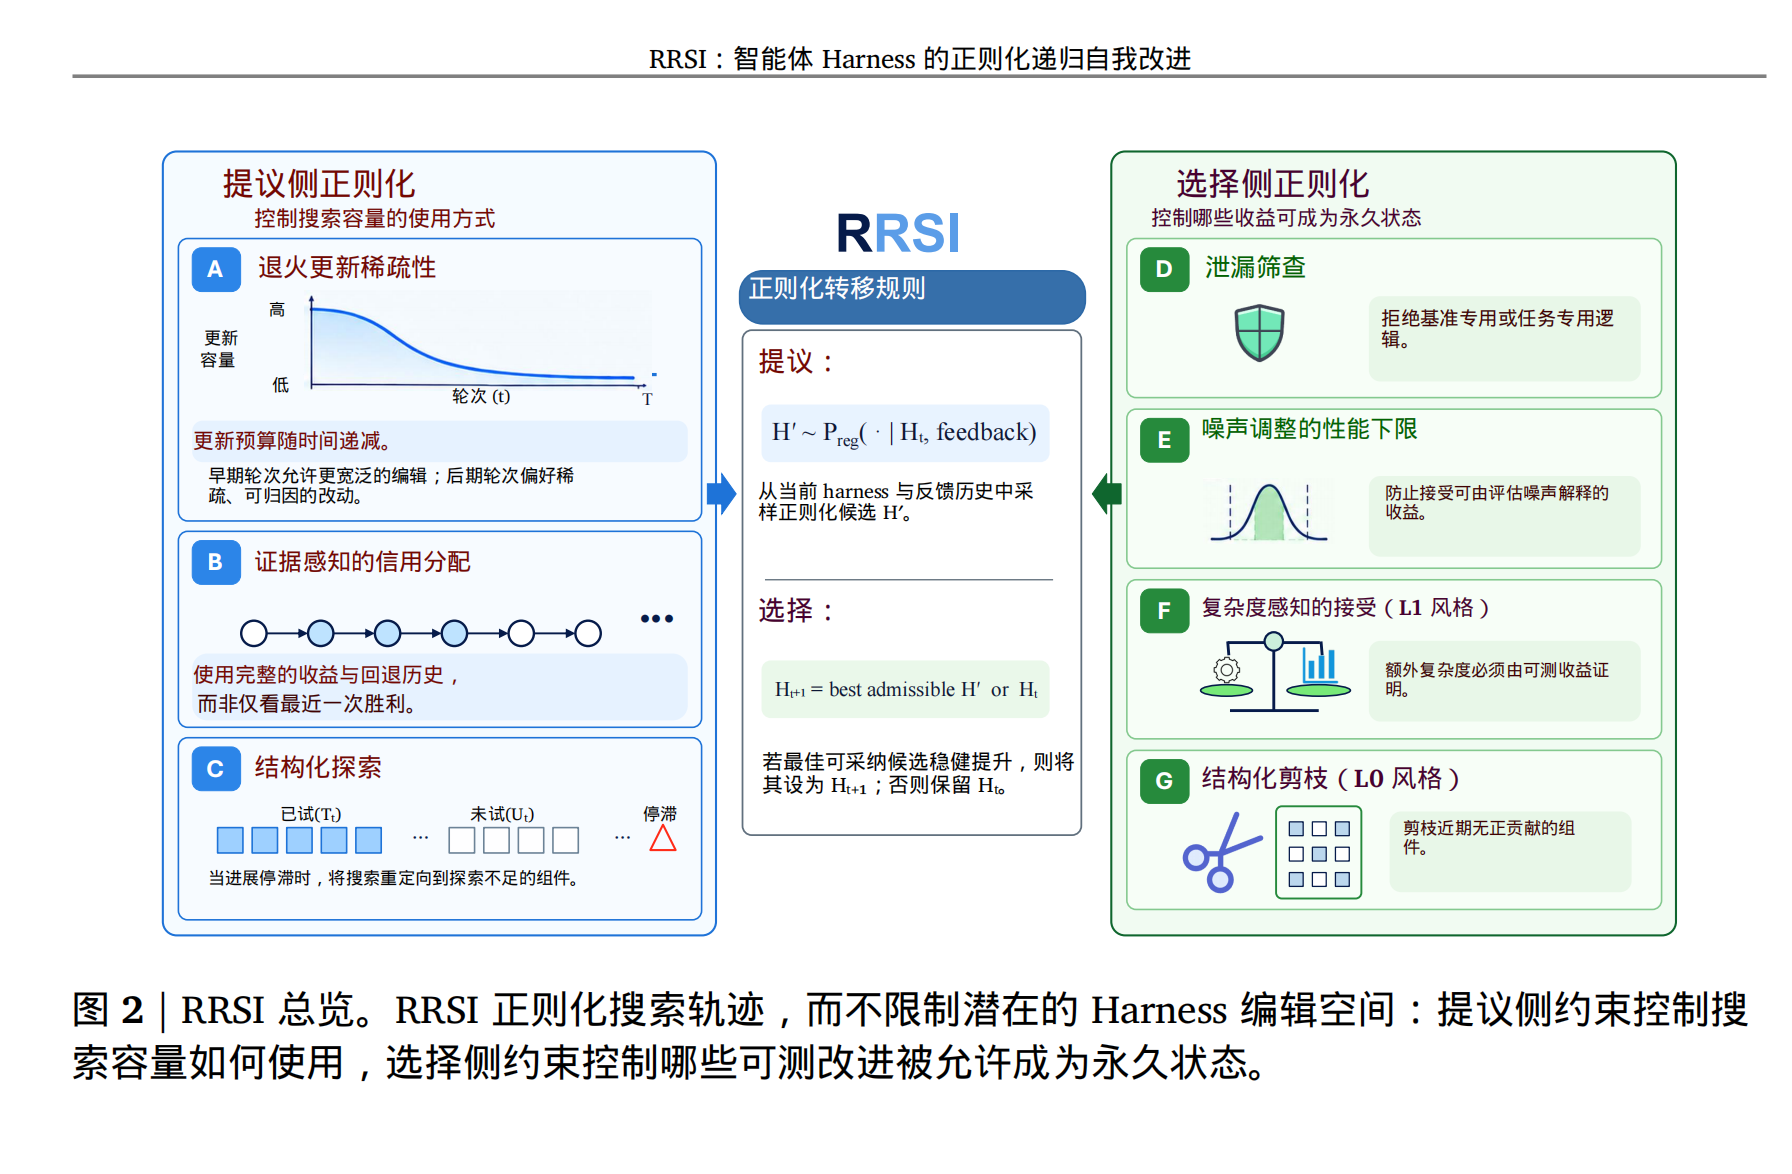
图 2|RRSI 总览。RRSI 正则化的是"搜索轨迹",而非限制潜在的 harness 编辑空间:提出侧约束控制搜索容量如何被使用;选择侧约束控制哪些"测得的改进"被允许成为永久状态。
- 提出侧正则化(Proposal-side)
- A 退火更新稀疏性(Annealed update sparsity):更新容量随轮次 𝑡 从高降到低。早期轮次允许更宽的编辑,后期轮次偏好稀疏、可归因的改动。
- B 证据感知信用分配(Evidence-aware credit assignment):使用增益与退步的完整历史,而不只是最近一次胜利。
- C 结构化探索(Structured exploration):当进展停滞时,把搜索重定向到未充分探索的组件(已试 𝑇ₜ / 未试 𝑈ₜ / 停滞)。
- 正则化转移规则(Regularized transition rule)
- 提出:𝐻′ ∼ P_reg(· | 𝐻ₜ, feedback)——从当前 harness 与反馈历史采样一个正则化候选。
- 选择:𝐻ₜ₊₁ = 最优可接受的 𝐻′ 或 𝐻ₜ——若某候选稳健地更好则取之,否则保留 𝐻ₜ。
- 选择侧正则化(Selection-side)
- D 泄漏筛查(Leakage screening):拒绝针对特定 benchmark 或特定任务的逻辑。
- E 噪声调整后的性能底线(Noise-adjusted performance floor):防止接受那些可由评估噪声解释的提升。
- F 复杂度感知接受(L1 式):额外复杂度必须有可测增益来背书。
- G 结构化剪枝(L0 式):剪除近期无正贡献的组件。
3.1 Harness 进化的正则化视角
记 Ω(𝐻) 为从 𝐻 经任意源码编辑可达的 harness 集合。RRSI 有意保持 Ω(𝐻) 开放:提示词、控制流、配置、上下文管理、工具、技能、记忆、子智能体都可以被修改、添加或删除。我们并不直接限制这个假设空间,而是正则化穿过它的搜索轨迹。每一轮 𝑡,proposer 用有限 evolve 集的反馈生成对当前 harness 𝐻ₜ 的候选编辑,selector 决定其中是否有(若有,哪个)应替换 incumbent。
这个视角区分两种互补的正则化。在提出侧,我们约束单轮能动用多少自适应容量、以及这容量花在哪里;在选择侧,我们约束哪些经验改进足够强、足够省、足够无泄漏,从而能存活下来。我们的复杂度控制框架借鉴三种经典正则化方法(Goodfellow et al., 2016; Hastie et al., 2009; Louizos et al., 2018),类比如下:编辑预算最接近 𝐿₀ 式基数约束,因为它直接限制一次更新中独立生效的编辑数;结构化剪枝类比 Lasso/𝐿₁ 式稀疏化,因为持续无产出的组件会从保留的 harness 中被移除,得到更稀疏的结构;复杂度感知接受类比 Ridge/𝐿₂ 式收缩,因为它抑制资源占用总量的无约束增长,而不要求剔除任何特定组件。详细算法见附录 C。
3.2 正则化提出分布
提出分布决定了搜索能多激进地响应 evolve 集反馈。RRSI 从三方面正则化它:退火单轮可动用的更新容量;让信用分配在整次运行中证据感知;以及结构化地安排这容量花在哪里。
𝐿₀ 式退火更新稀疏性。 无约束的 proposer 会把许多互不相关的修改捆进一个候选。这类候选有效容量很高:能拟合当前反馈更多的怪癖,而任何测得的变化都难以归因到某个具体机制。因此我们对一个提案中可独立归因的编辑数量设上限。在 𝑇 轮运行的第 𝑡 轮,该预算为:
𝑏ₜ = ⌈ 𝑏_min + (𝑏_max − 𝑏_min) · ½(1 + cos(𝜋𝑡/𝑇)) ⌉ (4)
该调度从 𝑏_max 降到 𝑏_min:早期轮次可以组合若干协同改动以发现新机制,后期轮次则越来越稀疏、越来越可归因。这是我们最直接的经典类比:若把候选中"可独立归因的编辑"用二值活动指示表示,预算就是对其基数的约束,即对更新施加的 𝐿₀ 式约束。该类比针对的是更新稀疏性,而非固定的模型参数向量:编辑池跨轮次会变化,我们也不优化一个带 𝐿₀ 惩罚的目标。
证据感知信用分配。 只约束更新大小,前提是搜索知道此前的更新确立了什么。每次评估都是对同一个有限 evolve 集的又一次自适应观察;反复检验早期轮次已经证伪过的假设,只会消耗搜索容量而不增加有用证据(Dwork et al., 2015)。因此 RRSI 为每个被评估的候选记录:它修改的组件、它检验的假设、源码 diff、由此产生的分数与成本变化、以及该候选是否被接受。proposer 在后续轮次以这段历史为条件:被拒绝的机制仍是负面证据,成功的机制保留明确信用。随着后期轮次允许每个候选包含更少编辑,识别"是哪一处改动导致了观测到的提升"也变得更容易。
结构化探索。 同一段历史也揭示 proposer 是否坍缩到了一个狭窄的编辑家族——例如反复重写提示词,却从不触碰智能体的结构机制。当过去 𝑤 轮的进展仍落在经验噪声带 𝛿 之内时,我们认为搜索停滞。停滞期间,一小部分提出预算被预留给本次运行中尚未动用过的组件。这起到类似多样性/熵正则化的作用:在不改变 harness 被允许包含哪些机制的前提下,把有限的提出容量重定向到探索不足的机制(Haarnoja et al., 2018)。
3.3 正则化候选选择
标准 harness 进化会推举测得分数最高的候选,哪怕该分数反映的是显式泄漏、随机波动或昂贵的膨胀。RRSI 保留同一个经验目标,但正则化"哪些候选被允许成为永久状态"。一个候选必须先满足若干**非补偿性(non-compensatory)**准则,它的分数才足以证明替换 incumbent 是合理的。
泄漏筛查(Leakage Screening)。 在完整评估之前,一个 critic 阅读每个候选 diff,拒绝那些显式编码任务名、实体名、任务特定取值、答案或其他 evolve benchmark 专属逻辑的编辑,以及那些添加无用机械结构(inert machinery)的编辑。筛查针对的是"特定 benchmark 的内容",而非特定 harness 组件:通用的提示词或工具描述改进仍是合法候选。在评估前筛查很重要,因为一个泄漏的候选永远拿不到那种会让它在后续轮次显得有吸引力的、被吹高的 evolve 集分数。
稳定性感知接受(Stability-Aware Acceptance)。 在带噪评估中反复选择,会把随机赢家固化为永久搜索状态。进化开始前,我们反复评估未改动的基座 harness,估计一个经验噪声带 𝛿。记 𝑆★ 为迄今观察到的最佳 evolve 集分数。候选必须满足噪声调整后的底线:
Ŝ(𝐻′) ≥ 𝑆★ − 𝛿 (5)
该底线防止搜索沿着一串各自都小到可被误认为噪声的退步一路向下走。更广义地,它让选择对"在同一 evolve 集上反复随机评估所引起的波动"保持保守(Dwork et al., 2015)。
Ridge/𝐿₂ 式复杂度感知接受。 对相对当前 harness 𝐻ₜ 的候选 𝐻′,令:
Δ𝑆 = Ŝ(𝐻′) − Ŝ(𝐻ₜ), Δ𝐶 = ( Ĉ(𝐻′) − Ĉ(𝐻ₜ) ) / Ĉ(𝐻ₜ) (6)
对提升超出噪声带(Δ𝑆 > 𝛿)的候选,我们要求:
Δ𝐶 ≤ 𝛽₀ + 𝛽₁·Δ𝑆 (7)
这里 𝛽₀ 设定了"可忽略的分数提升"所容忍的成本增加;𝛽₁ 则控制随着测得改进增大,允许追加多少额外成本。这些值在 evolve 集上选定,然后对所有迁移评估固定不变。于是,额外的推理成本必须由可测的性能改进来背书。这个过程类比 Ridge/𝐿₂ 式收缩:它抑制解整体幅度的无约束增长——在我们这里,解的幅度由 harness 的聚合资源占用表征。作为一种收缩方法,它不要求为了稀疏而剔除任何特定组件。我们用策略 token 成本作为该资源占用的统一可测代理。这是对 Ridge"非稀疏化复杂度控制"的类比。关于"测得变化落在噪声带内"的候选,其详细规则见附录 C.3。
Lasso/𝐿₁ 式结构化剪枝。 式 (4) 的退火预算稀疏化了每一次更新;剪枝则稀疏化被保留下来的 harness。RRSI 追踪近期动用过的组件在一个固定剪枝窗口内是否产生了严格为正的测得增益。始终无产出的组件会在后续轮次被报告给 proposer 作为删除目标。这个过程模仿 Lasso/𝐿₁ 式稀疏化:缺乏效用证据的机制被整体移除,于是保留的 harness 在结构上变得更稀疏,而不只是聚合上更便宜。这种对应同样是定性的:Lasso 通过 𝐿₁ 正则化减少参数数量,而我们的剪枝规则根据观察到的贡献删除离散的 harness 组件。共同直觉是"选择性稀疏化":一个机制必须持续挣得自己的位置,而不能因为"只看分数的进化没有动机删除它"就一直赖着不走(Hastie et al., 2009)。
4. 实验
我们在横跨三个领域的八个 benchmark 上评估 RRSI:编码领域为 Terminal-Bench 2.1 与 SWE-bench Verified;智能体工作区任务为 Harvey LAB、JobBench、GDPval、APEX-Agents;工程设计为 EngDesign 与 Frontier-Eng。实验回答以下问题:1) RRSI 与最先进的 harness 进化方法相比如何?2) 提升能否迁移到分布内留出任务,以及搜索从未见过的分布外 benchmark?3) 各组件的贡献如何?4) harness 在一次运行中如何演变?代价是多少 token?
4.1 实验设置
环境。 我们在三类任务上进化 harness:编码任务、智能体工作区任务、工程设计任务。
- 编码:Terminal-Bench 2.1(Merrill et al., 2026)是一套 89 个容器化终端任务,智能体驱动真实 shell,由任务自带的单元测试验证。
- 智能体工作区:Harvey LAB(Harvey AI, 2026)是横跨 25 个法律执业领域的法律工作 benchmark,划分为 120 个任务的固定 evolve 集与 40 个任务的干净分布内留出集。
- 工程设计:EngDesign(Guo et al., 2025)提供 61 个设计任务,每个由其自带的冻结模拟器(而非裁判模型)打分。
为测试泛化,我们额外在分布外(OOD)留出 benchmark 上评估:编码任务上用 SWE-bench Verified(Jimenez et al., 2024)做仓库级 bug 修复;智能体工作区上用 JobBench(Li et al., 2026)、GDPval(Patwardhan et al., 2026)、APEX-Agents(Vidgen et al., 2026);工程设计上用 Frontier-Eng(Chi et al., 2026)。
基线。 我们对比每个运行都从中出发的未进化基座 harness 𝐻₀,以及四种近期 harness 进化方法:Meta-Harness(Lee et al., 2026b)、AHE(Lin et al., 2026a)、TTHE(Nie et al., 2026)、HarnessX(Chen et al., 2026)。所有基线从同一个 𝐻₀ 出发,共享冻结策略、evolve 集与候选预算。基线细节见附录 B。
实现细节。 三个领域全程冻结的策略均为 Claude Opus 4.8(Anthropic, 2026a)。proposer、撰写跨轮失败反馈的 analyst、以及泄漏 critic 也都是 Claude Opus 4.8。所用基座 harness:编码为 Terminus-2(Merrill et al., 2026);在 MCP 工具网关上的 ReAct 循环(Yao et al., 2022);动态工具带(dynamic toolbelt, Vidgen et al., 2026);以及 ReSum 式上下文管理(用于 Harvey LAB 与 EngDesign)。其余超参见附录 D.1。
4.2 主要结果
RRSI 在三个领域中、对 evolve 集之外的每一个 split 都有提升。图 3 把每个数字都对照"同一时间窗内测得的未进化基座 harness 𝐻₀",因此没有任何提升可归因于评估基础设施的漂移。evolve 集提升为:Terminal-Bench 2.1 上 +6.0、EngDesign 上 +4.9、Harvey LAB 上 +1.1。真正要紧的是 harness 离开这些 split 之后还剩什么:SWE-bench Verified 提升 1.8 分(尽管仓库级 bug 修复从未被打分过);Harvey LAB 的分布内留出 split 提升 2.3;三个分布外智能体 benchmark 提升 3.5~4.7 分(7.2%~13.1%);Frontier-Eng 提升 4.3 个 Medal 分,相对提升 24.3%。没有任何留出 split 在任何地方退步——而退步正是"死记 harness"会产出的失败。
RRSI 在所有留出数据集上一致优于基线。表 1 让四种此前方法从同一个 𝐻₀ 出发、在同一个 evolve split 上、用相同候选预算运行。它们每一个在 evolve 集上都表现良好。分布内留出 split 上的表现也相当接近。分野出现在分布外,而那里的排名反转了:在 evolve split 上最强的基线 Meta-Harness,在分布外均值上只加了 0.9 分;HarnessX 回到基座水平;AHE 与 TTHE 则低于它们出发时的 harness,TTHE 低 1.7 分。RRSI 在所有被进化过的 harness 中 evolve 集提升最小,却是唯一一个把分布外均值拉高到超出 𝐻₀ 一分以上的——43.6 对 39.7,这正是正则化器被设计来达成的交换。
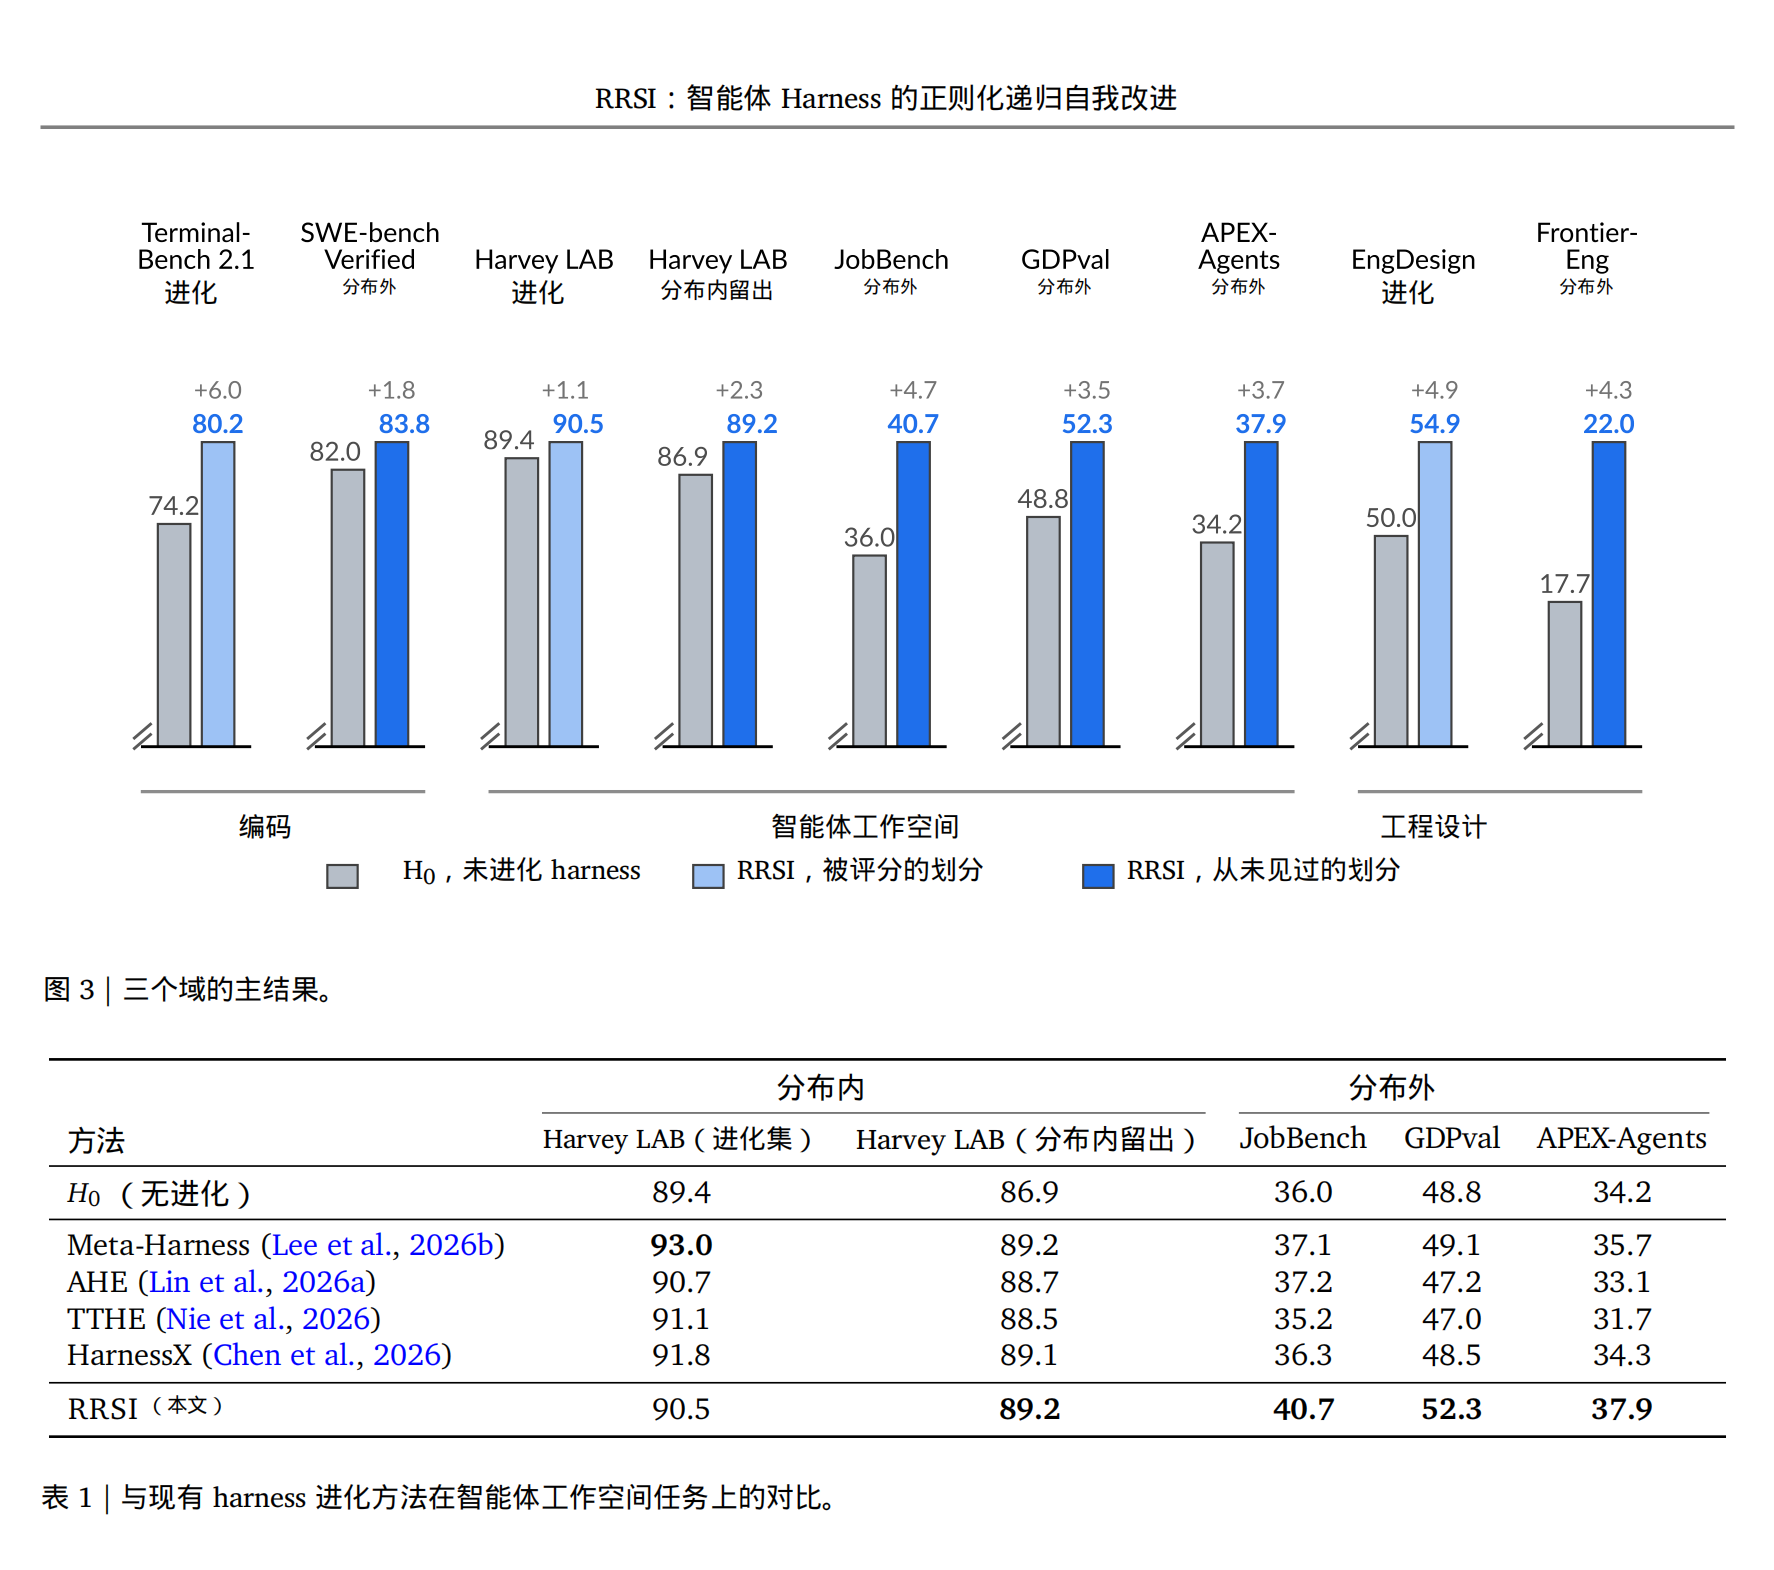
图 3|三个领域的主要结果。灰色为 𝐻₀(未进化 harness),浅蓝为 RRSI"被打分的 split",深蓝为 RRSI"从未见过的 split"。
| 𝐻₀ | 74.2 | 82.0 | 89.4 | 86.9 | 36.0 | 48.8 | 34.2 | 50.0 | 17.7 |
| RRSI | 80.2 (+6.0) | 83.8 (+1.8) | 90.5 (+1.1) | 89.2 (+2.3) | 40.7 (+4.7) | 52.3 (+3.5) | 37.9 (+3.7) | 54.9 (+4.9) | 22.0 (+4.3) |
表 1|在智能体工作区任务上与此前 harness 进化方法的对比。
| 𝐻₀(不进化) | 89.4 | 86.9 | 36.0 | 48.8 | 34.2 |
| Meta-Harness (Lee et al., 2026b) | 93.0 | 89.2 | 37.1 | 49.1 | 35.7 |
| AHE (Lin et al., 2026a) | 90.7 | 88.7 | 37.2 | 47.2 | 33.1 |
| TTHE (Nie et al., 2026) | 91.1 | 88.5 | 35.2 | 47.0 | 31.7 |
| HarnessX (Chen et al., 2026) | 91.8 | 89.1 | 36.3 | 48.5 | 34.3 |
| RRSI(本文) | 90.5 | 89.2 | 40.7 | 52.3 | 37.9 |
这种迁移不是"裁判打分"或"共享任务格式"造成的假象。Harvey LAB、JobBench、GDPval 都由裁判模型打分,因此原则上 harness 可以靠"写得讨裁判喜欢"而非"做出更好工作"来提分。工程设计实例堵死了这条路:每个 EngDesign 与 Frontier-Eng 任务都由其自带的仿真器/测试台打分,打分是确定性的——一个设计要么满足既定约束,要么不满足。提升在那里原样保留,而确定性打分也把裁判方差从测量中剔除了。
4.3 分析
主要结果确立了"进化后的 harness 能迁移";本节追问:是什么造就了这种性质?它是否依赖搜索所用的骨干?代价是什么?除非另作说明,下面每次运行都使用智能体工作区实例,并共享主实验的基座 harness、策略、evolve split、轮次数与候选预算,使各臂只在被研究的那个因子上不同。
消融分析。 我们消融两组正则化器:(i) 提出侧约束,(ii) 接受侧约束。如表 2,去掉任一组都会抬高 evolve 集分数、降低迁移。去掉接受约束时,evolve 集分数从 90.5 升到 91.5,而分布外均值从 43.6 跌到 41.0,token 成本上涨一半——说明无约束的选择规则把它接受的大多数编辑花在了噪声和上下文上,而非机制上。去掉提出约束,evolve split 只损失 0.2 分,分布外却损失 1.7 分——说明即使什么都不拒绝,引导"搜索往哪里看"也很要紧。最严重的退化来自两者都去掉:evolve 集分数升到所有臂中最高的 92.8,而分布外均值停在 40.3(只比未进化 harness 高不到一分),每次试验耗 380 万 token,而我们是 242 万。
表 2|在智能体工作区任务上对正则化器的消融。OOD Avg. 为 JobBench、GDPval、APEX-Agents 的均值。
| 𝐻₀(不进化) | 89.4 | 86.9 | 39.7 | 1.56 |
| 未正则化进化 | 92.8 | 88.9 | 40.3 | 3.80 |
| 去掉提出侧正则化 | 90.7 | 88.8 | 41.9 | 2.69 |
| 去掉接受侧正则化 | 91.5 | 88.7 | 41.0 | 3.59 |
| RRSI | 90.5 | 89.2 | 43.6 | 2.42 |
RRSI 不绑定某一个策略家族。 为检验正则化 harness 进化的提升是否依赖搜索时所用的策略,我们用两个不同家族的策略模型独立跑编码进化:Claude Opus 4.8 与 Gemini 3.5 Flash(Google, 2026b)。对每个策略,从同一个编码 harness 出发,只在 Terminal-Bench 2.1 上进化,然后在 evolve benchmark 与 SWE-bench Verified 上评估所得 harness。如表 3,在 Gemini 3.5 Flash 下,RRSI 把 Terminal-Bench 2.1 从 64.6 提到 78.7,并把 2.2 分的提升迁移到 SWE-bench Verified。在 Claude Opus 4.8 下模式相同:Terminal-Bench 2.1 从 74.2 到 80.2,SWE-bench Verified 从 82.0 到 83.8——尽管更强的策略一开始就更接近两个套件的天花板,提升空间更小。两种情况下,harness 都在从未被打分过的未见 benchmark 上改进了,说明 RRSI 的收益并非特定于某个骨干。
表 3|编码领域的策略鲁棒性。用每个冻结策略独立在 Terminal-Bench 上跑 harness 进化,然后原封不动地在 SWE-bench Verified 上评估。
| Claude Opus 4.8 | Terminal-Bench 2.1 (Evolve) | 74.2 | 80.2 | +6.0 |
| Claude Opus 4.8 | SWE-bench Verified (OOD) | 82.0 | 83.8 | +1.8 |
| Gemini 3.5 Flash | Terminal-Bench 2.1 (Evolve) | 64.6 | 78.7 | +14.1 |
| Gemini 3.5 Flash | SWE-bench Verified (OOD) | 76.8 | 79.0 | +2.2 |
进化后的 harness 在搜索从未用过的骨干下依然有帮助。 harness 是一个程序,不是一组权重;一个只对它所被搜索时所用策略有帮助的机制,是该策略的产物而非可复用机制。我们把用 Gemini 3.5 Flash 进化出的编码最终 harness,原封不动地用 Gemini 3.1 Flash Lite(一个从未参与搜索的更小模型)评估。如表 4,Terminal-Bench 2.1 准确率从 11.2 升到 14.6——相对提升 30.4%,而其基座分数还不到搜索策略的五分之一。因此这些机制并不依赖它们被搜索时所处的能力水平,尽管绝对提升更小,因为更弱的骨干把更少任务留在了任何 harness 够得着的范围内。
表 4|Terminal-Bench 2.1 上的跨模型迁移。以 Gemini 3.5 Flash 为冻结策略进化出的 harness,原封不动地用一个从未参与搜索的更弱骨干运行。
| Gemini 3.5 Flash(搜索策略) | 64.6 | 78.7 | +14.1 |
| Gemini 3.1 Flash Lite(未见) | 11.2 | 14.6 | +3.4 |
RRSI 产出了所有被进化 harness 中最轻量的一个。 两个正则化器直接作用于成本:𝐿₁ 式预算在"未被买单的增长"刚被提出时就拒绝它;剪枝规则则移除那些此后不再被买单的增长。此前没有任何方法带这两个约束,图 4(a) 显示了后果:四种方法全都落在 RRSI 支配的区域——每次试验花更多策略 token,却换得更低的分布外均值。AHE 是极端:每次试验 382 万 token,比我们多 58%,分布外却低 4.4 分。这一排序延续到图 4(b) 的轨迹长度:RRSI 每次试验 26.3 步,此前方法为 27.3~34.6 步。没有哪个被进化 harness 像 𝐻₀ 那样便宜(156 万 token、21.2 步),所以进化确实用测试期计算买来了一部分提升;而预算决定了买多少。
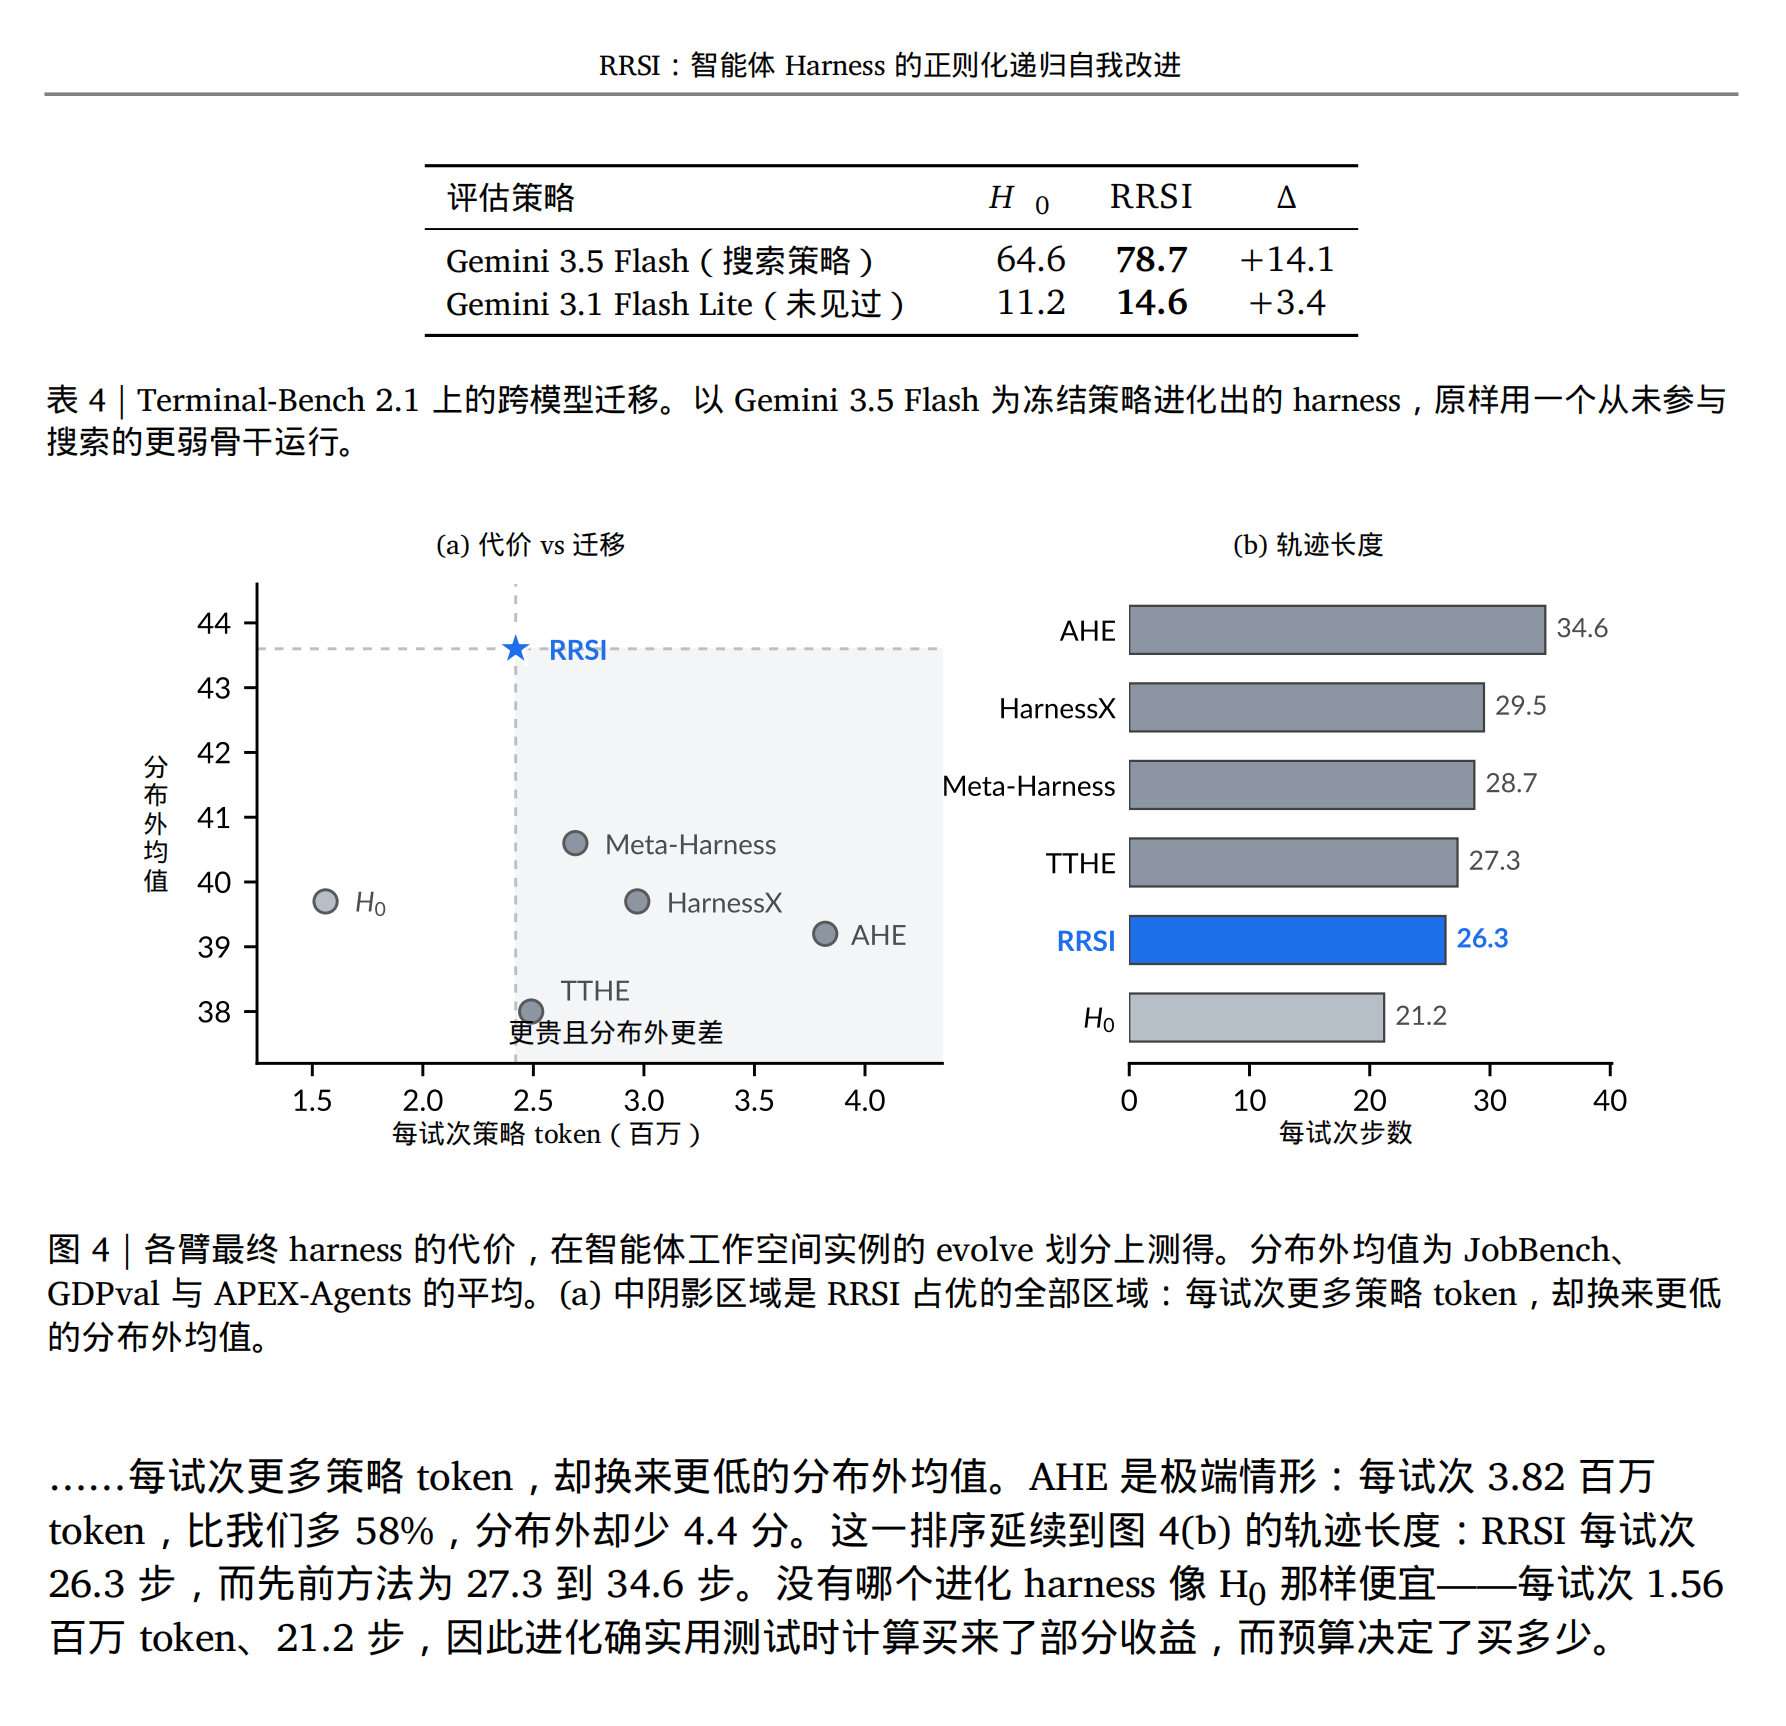
图 4|各臂最终 harness 的成本,在智能体工作区实例的 evolve split 上测得。OOD Avg. 为 JobBench、GDPval、APEX-Agents 均值。(a) 阴影区是 RRSI 支配的一切:每次试验花更多策略 token,分布外均值却更低。(b) 轨迹长度(步/试验):AHE 34.6、HarnessX 29.5、Meta-Harness 28.7、TTHE 27.3、RRSI 26.3、𝐻₀ 21.2。
5. 相关工作
智能体 harness。 决定一个智能体能做成什么的,不只是骨干模型,还有 harness:前沿实验室的工程报告描述了提示词结构、工具接口、上下文压缩与恢复逻辑如何决定一个长时间运行的智能体究竟能否完成任务(Lopopolo, 2026; Rajasekaran, 2026);近期分析主张 harness 自身就具备组合性与泛化能力(Wang et al., 2026a; Weng, 2026; Zhang and Khattab, 2026)。设计良好的 harness 甚至能替代规模,以小得多的成本恢复大骨干模型的大部分能力(Yang et al., 2026a)。这种工程 overwhelmingly 是手工的,而因为最佳 harness 绑定于特定骨干,每发一个新模型都要再付一遍这份成本(Huang et al., 2026b)。
Harness 进化。 最接近的一条工作线把这个循环自动化:由 LLM proposer 重写 harness,若编辑提升了 benchmark 分数就保留它(Chen et al., 2026; Karten et al., 2026b; Lee et al., 2026a,b; Lin et al., 2026a; Liu et al., 2026b; Nie et al., 2026; Zhang et al., 2026a);或是只进化单个组件,如技能(Xia et al., 2026a; Yang et al., 2026b)、记忆(Liu et al., 2026a; Ouyang et al., 2026; Tang et al., 2025; Wu et al., 2026)或对 rollout 的偏好信号(Pan et al., 2026)。这继承了"在经验适应度信号下搜索自身代码的自改进智能体"的机制与风险(Huang et al., 2026a,c; Wang et al., 2025; Xia et al., 2026b,c; Zhang et al., 2026b,c)。贯穿始终,搜索都由它所针对的套件分数驱动,没有任何项对应泛化;而代价并非假设性的:报告的提升常常在换套件后就不成立(Huang et al., 2026d; Wang et al., 2026b),delta 归因能把"安装了可复用机制"的编辑与"只是拟合了进化任务"的编辑区分开(Ding et al., 2026)。并发工作也直接针对泛化,要么把它作为搜索的显式目标(Zhang et al., 2026d),要么用一个保持多样性的候选 harness 档案(archive)替代贪心选择(Luo et al., 2026)。我们的贡献与"这些方法编辑什么"是正交的:我们保持同样开放的编辑空间,转而正则化搜索动态——在完整进化历史上分配信用、在打分前过滤任务特定逻辑、按噪声调整后的基线来决定接受——于是活下来的是机制,而不是对进化套件的拟合。
6. 结论
我们把迭代式 harness 进化视为智能体系统层面一种实用的递归自我改进,并表明:这个递归过程本身就需要正则化。因为一个有限 evolve 集被跨轮次自适应地复用,表面上的自我改进可能反映的是针对特定 benchmark 的拟合、评估噪声或不必要的复杂度,而非可迁移的进步。RRSI 通过在保持 harness 编辑空间开放的同时、对提出与选择两端都加以正则化来解决这个问题。在编码、智能体工作区与工程设计任务上,所得 harness 在留出与跨 benchmark 表现上都有提升,同时比未正则化进化消耗更少推理成本。这些结果提示:要通过递归自我改进让智能体系统越来越强,不仅要控制"什么可以改",还要控制"反复反馈如何被转化为持久改动"。
局限性
我们的研究聚焦于冻结骨干模型下的 harness 级递归自我改进,因此不讨论进化过程中更新模型权重的设置。此外,RRSI 仍依赖一个有限 evolve 集与若干正则化超参,其有效性可能依赖反馈信号质量与所选搜索预算。最后,尽管我们跨多个领域、benchmark 与策略模型评估了迁移,仍需要更广泛的验证,才能确定该方法对差异显著的智能体架构、工具生态系统以及更长时程的自我改进过程泛化得如何。
参考文献
参考文献按学术惯例保留原文(作者、机构、发表 venue、arXiv 编号与链接不译)。
- Anthropic. Introducing Claude Opus 4.8, 2026a. https://www.anthropic.com/news/claude-opus-4-8.
- Anthropic. Introducing Claude Sonnet 4.6, 2026b. https://www.anthropic.com/news/claude-sonnet-4-6.
- T. Chen et al. HarnessX: A composable, adaptive, and evolvable agent harness foundry. arXiv:2606.14249, 2026.
- Y. Chi et al. Frontier-Eng: Benchmarking self-evolving agents on real-world engineering tasks with generative optimization. arXiv:2604.12290, 2026.
- W. Ding et al. What evolves when we talk about harness evolution? wenwen-d.github.io, 2026.
- C. Dwork et al. Generalization in adaptive data analysis and holdout reuse. NeurIPS 28, 2015.
- I. Goodfellow, Y. Bengio, A. Courville. Deep Learning, vol. 1. MIT Press, 2016.
- Google. Gemini 3.1 Pro, 2026a. https://deepmind.google/models/gemini/pro/.
- Google. Gemini 3.5: frontier intelligence with action, 2026b.
- X. Guo et al. Toward engineering AGI: Benchmarking the engineering design capabilities of LLMs. NeurIPS, 2025.
- T. Haarnoja et al. Soft Actor-Critic. ICML, 2018.
- Harvey AI. Harvey LAB: The legal agent benchmark, 2026.
- T. Hastie, R. Tibshirani, J. Friedman. The Elements of Statistical Learning, vol. 2. Springer, 2009.
- C. Huang et al. G-Zero: Self-play for open-ended generation from zero data. arXiv:2605.09959, 2026a.
- C. Huang et al. EnvHarness: Awakening static worlds for agent learning. arXiv:2608.19880, 2026b.
- C. Huang et al. R-Zero: Self-evolving reasoning LLM from zero data. ICLR, 2026c.
- L. Huang et al. Evo-Bench: Can language models improve agent harness? arXiv:2608.09096, 2026d.
- C. E. Jimenez et al. SWE-bench: Can language models resolve real-world GitHub issues? ICLR, 2024.
- S. Karten et al. Prime Agent: A self-improving RLM harness. Prime Intellect Blog, 2026a.
- S. Karten et al. Continual Harness: Online adaptation for self-improving foundation agents. arXiv:2605.09998, 2026b.
- Z. Ke et al. EvoHarnessBench: Can your agents keep pace with an evolving harness? arXiv:2609.04280, 2026.
- H. Lee et al. Recursive harness self-improvement. arXiv:2607.15524, 2026a.
- Y. Lee et al. Meta-Harness: End-to-end optimization of model harnesses. CoLM, 2026b.
- Y. Li et al. JobBench: Aligning agent work with human will. arXiv:2605.26329, 2026.
- J. Lin et al. Agentic harness engineering: Observability-driven automatic evolution of coding-agent harnesses. arXiv:2604.25850, 2026a.
- M. Lin et al. Harness updating is not harness benefit: Disentangling evolution capabilities in self-evolving LLM agents. arXiv:2605.30621, 2026b.
- J. Liu et al. EvolveMem: Self-evolving memory architecture via auto-research for LLM agents. arXiv:2605.13941, 2026a.
- Z. Liu et al. Adaptive auto-harness: Sustained self-improvement for agentic system deployment on open-ended task streams. arXiv:2606.01770, 2026b.
- R. Lopopolo. Harness engineering: leveraging Codex in an agent-first world, 2026.
- X. Lou et al. AutoHarness: improving LLM agents by automatically synthesizing a code harness. arXiv:2603.03329, 2026.
- C. Louizos, M. Welling, D. P. Kingma. Learning sparse neural networks through L0 regularization. ICLR, 2018.
- X. Luo et al. Self-evolving agent harnesses via gated semantic quality-diversity. arXiv:2607.13683, 2026.
- M. Merrill et al. Terminal-Bench: Benchmarking agents on hard, realistic tasks in command line interfaces. ICLR, 2026.
- J. Nie et al. TTHE: Test-time harness evolution. arXiv:2607.08124, 2026.
- J. Niklaus. Don’t train the model, evolve the harness, 2026.
- S. Ouyang et al. ReasoningBank: Scaling agent self-evolving with reasoning memory. ICLR, 2026.
- W. Pan et al. Retrospective harness optimization: Improving LLM agents via self-preference over trajectory rollouts. arXiv:2606.05922, 2026.
- T. Patwardhan et al. GDPval: Evaluating AI model performance on real-world economically valuable tasks. ICLR, 2026.
- Qwen Team. Qwen3.6-Plus: Towards real world agents, 2026.
- P. Rajasekaran. Harness design for long-running application development, 2026.
- RSI-Exam Team. RSI-Exam: Benchmarking recursive self-improvement through executable research, 2026.
- X. Tang et al. Agent KB: Leveraging cross-domain experience for agentic problem solving. arXiv:2507.06229, 2025.
- N. Team et al. NeoHorses-1: Towards recursive self-improvement via agentic post-training with routing harness. arXiv:2609.08183, 2026.
- B. Vidgen et al. APEX-Agents. arXiv:2601.14242, 2026.
- R. Wang et al. Harness handbook: Making evolving agent harnesses readable, navigable, and editable. arXiv:2607.13285, 2026a.
- W. Wang et al. Huxley-Gödel machine: Human-level coding agent development by an approximation of the optimal self-improving machine. arXiv:2510.21614, 2025.
- Y. Wang et al. Rethinking the evaluation of harness evolution for agents. COLM 2026 Lifelong Agents Workshop, 2026b.
- L. Weng. Harness engineering for self-improvement. lilianweng.github.io, 2026.
- S. Wu et al. AutoMem: Automated learning of memory as a cognitive skill. arXiv:2607.01224, 2026.
- P. Xia et al. SkillRL: Evolving agents via recursive skill-augmented reinforcement learning. arXiv:2602.08234, 2026a.
- P. Xia et al. MetaClaw: Just talk–an agent that meta-learns and evolves in the wild. arXiv:2603.17187, 2026b.
- P. Xia et al. Agent0: Unleashing self-evolving agents from zero data via tool-integrated reasoning. CoLM, 2026c.
- C. Yang et al. Better harnesses, smaller models: Building 90% cheaper agents via automated harness adaptation. arXiv:2607.08938, 2026a.
- Y. Yang et al. SkillOpt: Executive strategy for self-evolving agent skills. arXiv:2605.23904, 2026b.
- S. Yao et al. ReAct: Synergizing reasoning and acting in language models. arXiv:2210.03629, 2022.
- A. Zhang, O. Khattab. Language model harnesses are compositional generalizers, 2026.
- H. Zhang et al. Self-Harness: Harnesses that improve themselves. arXiv:2606.09498, 2026a.
- J. Zhang et al. Darwin Gödel machine: open-ended evolution of self-improving agents. ICLR, 2026b.
- J. Zhang et al. HyperAgents. arXiv:2603.19461, 2026c.
- L. Zhang et al. HarnessCompass: Guiding automatic harness evolution toward generalizable and effective agent harnesses. arXiv:2608.01918, 2026d.
- Y. Zhang et al. DarwinX: Evolving agent harnesses through natural selection. arXiv:2608.07545, 2026e.
附录
A. 评估
此处说明每个环境如何运行与打分。一个 harness 与其基线始终在同一时间窗、同一工具环境、同一裁判、相同试验次数下评估。
A.1 Terminal-Bench 2.1 每个任务是一个容器镜像,含任务描述、工作目录与一组对智能体隐藏的单元测试(Merrill et al., 2026)。智能体通过 harness 驱动真实 shell;只有在智能体停止后该任务自带测试套件全部通过,任务才算解决——奖励是精确的,无法用一个"看起来合理"的答案蒙混。报告的准确率即以此方式解决的 89 个任务中的占比。各臂之间容器会被拆除重建,确保状态不从一次评估带到下一次。
A.2 SWE-bench Verified 每个实例是一个真实 GitHub issue,连同报告时的仓库快照(Jimenez et al., 2024)。智能体必须产出一个 patch,应用到快照上后检查:fail-to-pass 测试必须从失败变通过,pass-to-pass 测试必须保持通过。报告的解决率即同时满足两条件的实例占比。
A.3 Harvey LAB 每个任务提供一个含 Word/Excel/PDF 源文档的文件夹,要求智能体按精确指定的文件名产出交付文件(Harvey AI, 2026),再按严格的逐条标准(rubric)打分——每任务 20~100 个独立评判的标准,完整评估约 14000 条标准判定。每条标准由一个 LLM 裁判(Gemini-3.5-Flash)单独评判:它同时读到所产出交付物与那一条标准。一次运行的分数即所有任务中通过标准的比例,因此 rubric 长的任务贡献证据更多;缺失交付物会令其本应满足的每条标准都不通过,而不是被丢弃。160 个任务一次性划分为 120 个 evolve 任务与 40 个留出任务,划分在实验中固定。
A.4 JobBench 任务取自真实专业工作流(Li et al., 2026),每个附带输入文件文件夹与一个包装提示词,智能体本应查阅的参考资料被有意扣留,使一部分工作成为真正的检索。harness 暴露一个文件系统、一个用于产出 Office/PDF 交付物的代码执行工具、以及一个接地(grounded)网页搜索工具。交付物按 benchmark 自带的加权 rubric 打分,报告数字即被评估 split 上的加权 rubric 分。我们使用一个 LLM 裁判(Gemini-3.5-Flash 与 Claude Opus 4.8 的平均分)。
A.5 GDPval 对每个任务,把 harness 产出的交付物与 benchmark 自带的人类专家交付物并排放在一起(Patwardhan et al., 2026),一个由三位不同出身裁判组成的评审团选出两者中较好的一个,报告数字即对 185 个任务相对专家的胜率。评审团由一个本地部署的开源模型(Qwen3.6-35B-A3B)与两个来自不同厂商的专有模型(Claude Sonnet 4.6、Gemini-3.1 Pro)组成;每一对都按两种呈现顺序各判一次以消除位置偏差,一个任务的判定为三人多数票。因此每位裁判对每个 harness 出具 204 次比较;胜率高于 50% 意味着该 harness 比与之对比的人类专家更常产出受偏好的交付物。
A.6 APEX-Agents 每个任务把智能体放进一个带自有 MCP 工具面的沙盒世界,覆盖文件系统、PDF 阅读、电子表格、邮件、聊天、日历、文档与代码执行,横跨三个专业领域(Vidgen et al., 2026)。任务由一个逐任务 rubric、经 LLM 裁判(Gemini-3.5-Flash)评判打分;只有单次采样 rollout 上满足 rubric,该任务在 pass@1 下才算成功。我们评估全部 480 个任务,并始终在这个完整分母上报告——因基础设施故障而缺失 rollout 的任务计为失败而非被排除,以免一个在难世界上崩溃的 harness 看起来比一个敢于尝试的 harness 更好。
A.7 EngDesign 我们使用 EngDesign 的免许可子集(Guo et al., 2025),选取其中 61 个无需专有模拟器即可运行的任务。每个任务陈述一个设计目标及设计必须满足的物理约束,由其自带的冻结仿真器/测试台(而非裁判模型)打分,因此打分是确定性的,我们测得的每一分方差都来自策略。进化在全部 61 个任务上运行,不做分布内留出划分——套件太小,抽不出任务来做留出。
A.8 Frontier-Eng Frontier-Eng(Chi et al., 2026)从 26 个领域收集真实世界工程优化问题。每个任务要求智能体产出一个设计或程序,由一个冻结的、任务特定的仿真器/评估器在连续目标上打分——与 EngDesign 一样不涉及裁判模型、打分确定性。由于各任务目标不可公度,benchmark 报告 Medal Score(奖牌分):对每个任务,冻结 v1 快照中三个最佳可行结果分别作为金、银、铜阈值;提交达到任一阈值分别得 1、0.67、0.33;分数为 v1 集 47 个任务上的平均得分,以百分比报告。我们仅把 Frontier-Eng 当作分布外测试面。其中 EngDesign 领域复用了我们 evolve 集的任务,予以排除;评估环境无法在我们沙盒中搭建的任务,两臂都不得分。最终 47 个任务中 38 个贡献得分,两臂在完全相同的任务集合上打分。
B. 基线方法
简要总结实验所用四种 harness 进化基线。
- Meta-Harness(Lee et al., 2026b):把 harness 工程表述为对可执行 harness 代码的外循环优化问题。其智能体式 proposer 可访问先前候选的源码、评估分数与执行轨迹,利用这些积累经验提出改进 harness。
- Agentic Harness Engineering (AHE)(Lin et al., 2026a):为编码智能体 harness 使用一个可观测性驱动的进化循环。它把 harness 组件、执行经验与编辑结果组织成显式表示,使一个不断进化的智能体能够诊断失败、提出改动、并评估先前编辑的效果。
- Test-Time Harness Evolution (TTHE)(Nie et al., 2026):在测试期自适应期间进化可执行 harness,同时固定底层模型权重。它维护多个候选 harness,从执行轨迹提出修改,并用一个智能体裁判选出一个 harness 持久化到后续输入。
- HarnessX(Chen et al., 2026):把智能体 harness 表示为跨提示词、工具、记忆、控制流等组件的、模块化、带类型的原语组合。其轨迹驱动的自适应机制用执行反馈修改并选择 harness 配置,使运行时脚手架随时间演化。
C. 方法细节
本节给出第 3 节略去的轮次级形式化与实现细节,具体说明实验中使用的提出侧与选择侧正则化器。与正文一样,𝐿₀、Lasso/𝐿₁、Ridge/𝐿₂ 这些术语仅用于指示它们在复杂度控制中的类比角色;该过程并不优化对应的范数惩罚目标,异构的 harness 组件也不被当作某个共享连续参数向量的坐标。
C.1 轮次级形式化 记 Ω(𝐻) 为从 𝐻 经任意源码编辑可达的 harness 集合。RRSI 保持 Ω(𝐻) 开放,转而正则化穿过该空间的转移。一轮的形式为:
𝐇ₜ ∼ P_reg(· | 𝐻ₜ, Fₜ, Lₜ, 𝑏ₜ, Eₜ, Bₜ) ⊆ Ω(𝐻ₜ), 𝐻ₜ₊₁ = argmax_{𝐻′ ∈ 𝐇ₜ ∩ Aₜ} Ŝ(𝐻′) (8)
若没有候选可接受,则 𝐻ₜ₊₁ = 𝐻ₜ。其中 Fₜ 为本轮反馈,Lₜ 为编辑历史,𝑏ₜ 为式 (4) 的退火编辑预算,Eₜ 含探索指令,Bₜ 为从近期历史推断出的结构化剪枝目标,Aₜ 为被允许替换 incumbent 的候选集合。一次运行对 𝑡 = 0,…,𝑇−1 执行算法 1 与算法 2,从 𝐻₀ 出发,𝑆★ = Ŝ(𝐻₀)。进化开始前,反复评估未改动的基座 harness 以估计经验噪声容忍度 𝛿。
算法 1(RRSI,提出侧) 输入:𝐻ₜ、历史 Lₜ、第 𝑡 轮(共 𝑇 轮);𝑏_min、𝑏_max、停滞窗口 𝑤、噪声带 𝛿
算法 2(RRSI,选择侧) 输入:经筛查的 𝐇ₜ、(𝐻ₜ, Ŝₜ, Ĉₜ)、𝑆★、𝛿、𝑘;𝛽₀、𝛽₁、𝑤ₛ、𝑤_c、𝑤_n
C.2 提出侧簿记
原子编辑表示。 第 𝑡 轮,proposer 起草一个针对 𝐻ₜ 的原子编辑池 Eₜ,一个候选应用该池的一个子集。把该子集记为 𝑧ₜ ∈ {0,1}^|Eₜ|,𝑧ₜ,ⱼ = 1 表示编辑 𝑗 被纳入。编辑池每轮从开放空间 Ω(𝐻ₜ) 重新抽取,故 |Eₜ| 不必跨轮固定。式 (4) 的退火预算施加:
‖𝑧ₜ‖₀ ≤ 𝑏ₜ (9)
因此 𝑏ₜ 限制的是捆进单个候选的、可独立归因的编辑数,而非"最终可能被修改的组件集合"。这是我们最直接的经典类比:它是对更新的基数约束,而非对固定模型参数向量的 𝐿₀ 惩罚。
编辑历史与组件级摘要。 被评估候选中的每条原子编辑都标记一个组件 ℓ、一个假设 ℎ、以及候选源码 diff 𝑑。含多条编辑的候选按每条编辑贡献一条历史记录;该候选中所有编辑共享同一个测得的 Δ𝑆、Δ𝐶 与轮次结果。忽略那些在获得有效测量前就失败的候选,第 𝑡 轮之前的历史可写为:
Lₜ = { (𝑡ᵢ, ℓᵢ, ℎᵢ, 𝑑ᵢ, Δ𝑆ᵢ, Δ𝐶ᵢ, 𝑎ᵢ) : 𝑖 ≤ 𝑛ₜ }, 𝑎ᵢ ∈ {0,1} (10)
其中 𝑎ᵢ = 1 当且仅当携带编辑 𝑖 的候选被选为该轮胜者、从而进入被接受的进化路径。那些可接受但输给分数更高的可接受候选的,𝑎ᵢ = 0。
proposer 使用的两个摘要为:
Tₜ = { ℓᵢ : 𝑖 ≤ 𝑛ₜ }, 𝑔ₜ(ℓ) = max{ Δ𝑆ᵢ : ℓᵢ = ℓ, 𝑡 − 𝑡ᵢ ≤ 𝑛_prune },max ∅ = −∞ (11)
这里 Tₜ 是至少有过一次测得编辑的组件集合,𝑔ₜ(ℓ) 是剪枝窗口内与组件 ℓ 关联的最佳近期测得增益。由于捆绑编辑继承候选级测量,随着编辑预算退火趋近于一,这些证据也变得更可归因。
结构化探索状态。 记 K 为可编辑组件词表。实现中:
K = { prompt, control_flow, config, output_plumbing, context_mgmt, client_tool, skill, memory, subagent } (12)
探索指令为:
Eₜ = (𝜎ₜ, Uₜ, 𝑚_draft), 𝜎ₜ = 𝟙[ Ŝₜ − Ŝₜ₋𝑤 ≤ 𝛿 ], Uₜ = K \\ Tₜ (13)
其中 𝜎ₜ 表示过去 𝑤 轮的进展未超出经验噪声容忍度,Uₜ 含尚未被任何测得编辑动用过的组件,𝑚_draft 在搜索停滞时为探索性编辑预留候选名额。
结构化剪枝。 剪枝目标集为:
Bₜ = { ℓ ∈ Tₜ : 𝑔ₜ(ℓ) ≤ 0 } (14)
于是,一个组件若已被动用、但在近期剪枝窗口内未产生严格为正的测得增益,就被标记为无产出。proposer 收到 Bₜ 以及与这些组件关联的任何先前被接受的编辑,并被指示在后续提案中移除无产出的机械结构。这在角色上类比 Lasso/𝐿₁ 式稀疏化,因为该机制通过从保留的 harness 中删除离散结构来起作用;它不是一个 𝐿₁ 惩罚的连续优化问题。
C.3 选择侧簿记
噪声调整后的底线。 泄漏 critic 在完整评估之前施加。对每个进入选择的候选,第一个非补偿性性能要求是式 (5) 的稳定性底线:Ŝ(𝐻′) ≥ 𝑆★ − 𝛿。它允许在经验校准容忍度内的波动,同时防止搜索累积一连串小退步。
带内规则所用的新颖度。 塑形规则只对结构组件使用新颖度。令 K_str = { client_tool, skill, memory, subagent } (15),记 𝑁ₜ(ℓ) 为第 𝑡 轮之前、标记为组件 ℓ 的已接受编辑记录数。若 comp(𝐻′) 为候选 𝐻′ 触及的组件类型集合,实现计算:
𝜈ₜ(𝐻′) = Σ_{ℓ ∈ K_str} 𝟙[ ℓ ∈ comp(𝐻′) ∧ 𝑁ₜ(ℓ) = 0 ] (16)
因此 𝜈ₜ(𝐻′) 统计该候选触及的、此前从未出现在获胜编辑中的不同结构组件类型数。提示词、控制流、配置、输出管线与上下文管理类编辑不获得这一新颖度奖励。
增益超过噪声容忍度时的接受。 对 Δ𝑆 > 𝛿,选择器使用式 (7) 的增益相关成本条件:Δ𝐶 ≤ 𝛽₀ + 𝛽₁Δ𝑆。该规则只在伴随更大测得改进时才允许更多推理成本。这正是正文引出 Ridge/𝐿₂ 式类比的部分:它抑制聚合资源占用的无约束增长,而不要求剔除单个组件。类比是功能性的而非数学的:该规则不是一个平方范数惩罚。
增益未超过噪声容忍度时的接受。 对通过稳定性底线、但测得增益未超出经验容忍度(Δ𝑆 ≤ 𝛿)的候选,实现不使用式 (7),而施加塑形可接受条件:
𝑤ₛΔ𝑆 − 𝑤_cΔ𝐶 + 𝑤_n𝜈ₜ(𝐻′) > 0 (17)
其中 𝑤ₛ、𝑤_c、𝑤_n ≥ 0 分别控制测得分数变化、相对推理成本变化、以及此前未用过的结构组件类型的贡献。该分支的目的是避免把一个小的分数波动本身当作充分证据。在这一区域内,降低成本通过 −𝑤_cΔ𝐶 正向贡献;尝试一个从未进入过被接受进化路径的结构机制通过 𝑤_n𝜈ₜ(𝐻′) 贡献。依进化实例不同,带内分数变化也可能通过 𝑤ₛΔ𝑆 贡献。
编码实例设 𝑤ₛ = 0。因此一个仍落在 𝛿 内的分数提升,本身不能让一个编码候选变得可接受;候选必须转而从更低成本和/或结构新颖度获得足够信用。智能体工作区与工程设计实例使用正的 𝑤ₛ。三个权重对一个进化实例固定,列于表 5。式 (17) 是不确定性区域内部一个实现层面的决胜/可接受规则,本身不等同于某个 𝐿ₚ 惩罚。
领域特定的非补偿性守卫。 在稳定性与成本检查之后,实现可施加一个领域特定守卫 𝑔(𝐻ₜ, 𝐻′) ∈ {0,1}。编码与智能体工作区实例不使用额外守卫,故 𝑔 = 1。工程设计实例额外拒绝这样的候选:其有效输出率相对 incumbent 下降超过 0.03,或无提交率上升超过 0.02。这些守卫防止"主通过率目标上的一点提升"去补偿"基本执行有效性上的大幅退化"。
末轮选择。 一个候选只有同时满足噪声调整后的底线、复杂度感知规则的相应分支、以及所有激活的领域守卫,才算可接受。在可接受候选中,选择器选测得分数最高者;若无可接受候选,则保留 incumbent。随后更新运行最佳分数 𝑆★ ← max(𝑆★, Ŝ(𝐻ₜ₊₁))。
D. 实验
D.1 超参数设置 RRSI 引入少量超参,控制更新稀疏性、探索、剪枝以及成本—性能权衡。我们仅用进化环境与工程考虑来选这些参数;留出与 OOD benchmark 不用于调参。噪声容忍度 𝛿 由反复评估未改动基座 harness 校准。编辑预算参数 (𝑏_min, 𝑏_max) 决定单个候选能捆绑多少独立改动;𝑤 与 𝑚_draft 控制搜索何时、多强地探索使用不足的组件。剪枝窗口 𝑛_prune 决定一个组件要积累多少近期证据才被视为无产出。最后,(𝛽₀, 𝛽₁) 编码测得增益与额外推理成本之间允许的权衡。表 5 列出各实例所用值。分数 Ŝ 为 [0,1] 上的比例,Δ𝐶 为每次试验策略 token 的相对变化,故 𝛿 与 𝛽₁ 以这些单位表示:编码实例上 𝛿 对应 89×𝑘=178 次试验中的 3 次通过;智能体工作区实例上对应约 14100 条标准判定中的 60 条;工程设计实例上对应 61×𝑘=244 次试验中的 5 次通过。同理,𝛽₁ 对应:编码中每多一次通过允许 25% token;智能体工作区中每多 100 条标准;工程设计中每多一次通过允许 10%。
表 5|RRSI 在各进化设置中使用的超参数。所有选择均在不参考留出或 OOD benchmark 的情况下固定。
| 𝑇 | 进化轮次 | 20 | 20 | 40 |
| 𝑘 | 每次评估每任务试验数 | 2 | 2 | 4 |
| 𝛿 | 经验噪声容忍度 | 0.017 | 0.004 | 0.020 |
| 𝑏_min | 末轮编辑预算 | 1 | 1 | 1 |
| 𝑏_max | 初始编辑预算 | 4 | 3 | 4 |
| 𝑤 | 停滞检测窗口 | 3 | 3 | 3 |
| 𝑚_draft | 预留探索性提案数 | 1 | 1 | 1 |
| 𝑛_prune | 剪枝窗口 | 4 | 4 | 5 |
| 𝛽₀ | 基础成本许可 | 0.10 | 0.10 | 0.15 |
| 𝛽₁ | 增益相关成本许可 | 44.5 | 35.4 | 24.4 |
E. 定性案例研究
为补充聚合结果,我们检视 RRSI 进化过程中做出的代表性决策。表 6 总结了发布轨迹中的若干例子。完整的逐轮记录——包括提案、critic 判定、接受决策与精确 harness diff——见项目网站。
这些例子让我们更具体地看到正则化行为。特别是编码第 0 轮的两个候选表面上相似,但只有那个测得改进足够大的候选通过了成本感知选择规则。反之,第 8 轮的候选降低了推理成本,却仍被拒绝,因为其性能落在可接受底线之下。工程例子则展示了互补情形:一个小而可复用的控制流修正被保留下来,资源几乎没有增长。这些轨迹共同表明:RRSI 并不简单地累积一切能提高 evolve 集分数的编辑,而是选择性地保留那些"测得收益相对其复杂度足够稳健"的改动。
表 6|RRSI 中有代表性的 harness 进化决策。这些例子表明进化并非只由分数驱动:候选的特异性、评估稳定性与推理成本共同决定一处改动是否被保留。
| 编码,R0-A | 增加一个有界的"完成前验证审计",并对长时运行任务提供非阻塞轮询指引。 | 接受:evolve 集 +3.93 分。 | 当增益超过噪声阈值时,一个可复用的行为机制可以支撑一次相对宽泛的早期更新。 |
| 编码,R0-B | 增加类似的验证提醒与长时运行指引,但测得增益更小、额外推理成本更高。 | 被成本规则拒绝:+1.69 分,成本 +26.1%。 | 当表面改进落在噪声带内、且需要大量额外计算时,不会被自动保留。 |
| 编码,R8-B | 把原始任务指令钉死在"完成门"中,使策略在提交前重新核对字面规格。 | 被底线拒绝:−2.81 分,尽管成本 −13.6%。 | 对一个性能落在噪声调整后接受底线之下的候选,单靠更低成本无法补偿。 |
| 工程设计,R2 | 为反复出现的 “workdir must be an existing directory” 工具使用错误增加一个有界恢复提示。 | 接受:122/244 → 128/244 通过,token +1.6%。 | 搜索可以保留那些小而与任务无关、却以极少额外复杂度提升可靠性的控制流修正。 |
(全文完。原文共 24 页,含图 1–4 与表 1–6)


评论前必须登录!
注册