 网硕互联帮助中心
这篇是“生成式引擎可见性”笔记的第三篇。第一篇写怎么复测(怎么问、怎么记、怎么避免自欺),第二篇写能不能被读到(robots、渲染、访问前置条件),这篇写中间最容易忽略的一层——读到了,却没被摘走。
全文只讨论公开可验证的技术形态,不针对某一家引擎的实现细节下断言。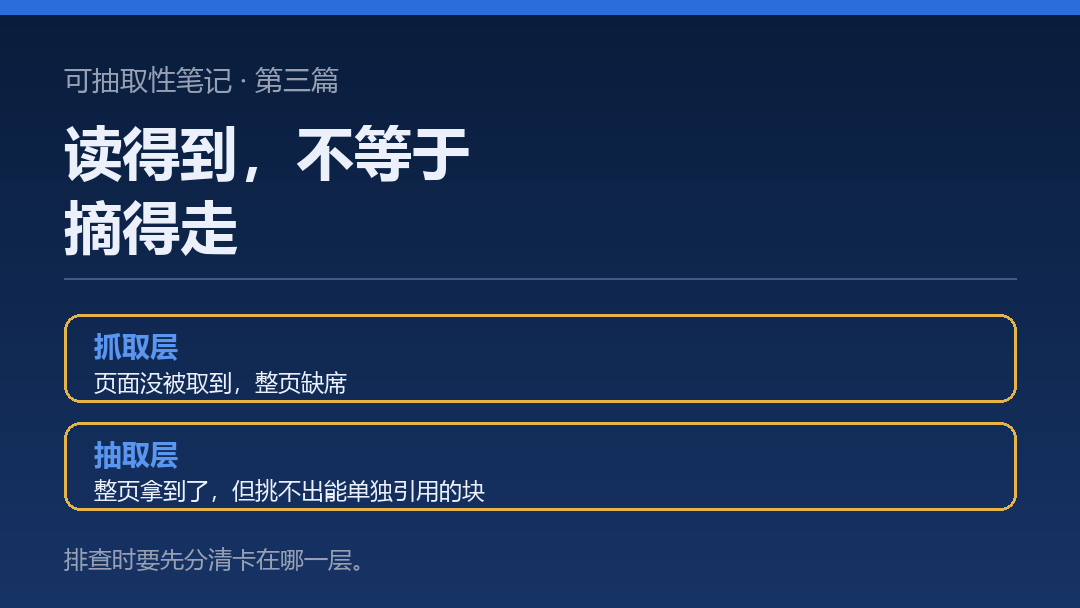
一、读得到,不等于摘得走
先把两类失败分开,这两种情况的处理动作完全不同:
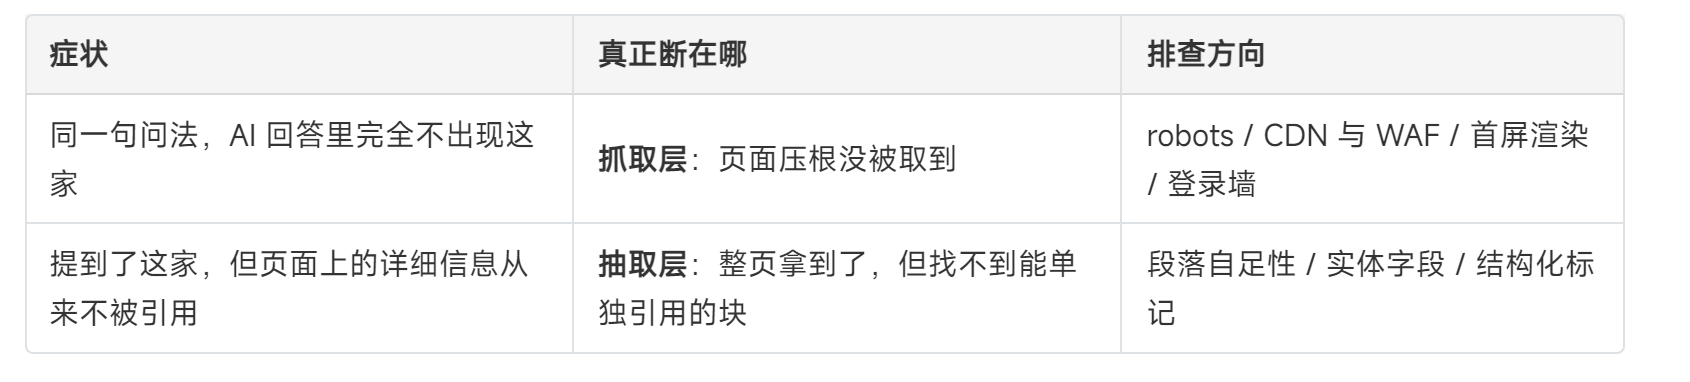
第二类的隐蔽之处在于:访问一切正常,日志里有爬虫请求,渲染也正常——它就是不被摘。排查时如果只盯第一层,很容易得出“我们没问题”的结论。
这一层要回答的是一个很具体的问题:什么样的文本块,能脱离原页面独立成立?
二、四条判据:一段话能不能被单独拿走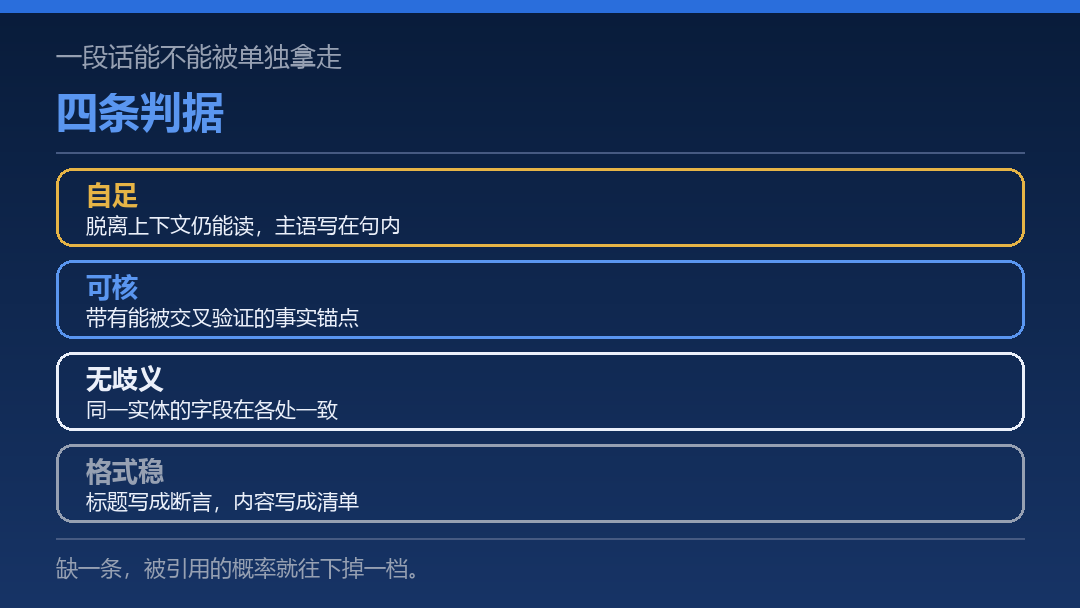
把这一层的标准摊开,其实是四条。前三条是内容形态,第四条是机器可读性。
1. 自足——脱离上下文还能读
这是最硬的一条。假设引擎把这一段从页面里抠出来,直接贴进回答里,读者能不能看懂?
反面:依赖上文
这使得我们的服务非常适合上述客户群体。
正面:自带主语、范围和条件
XX 公司的 XX 服务主要服务 XX 城市的中小企业客户,覆盖 XX 与 XX 两类场景。
反面那句离开原页面就是废话——“这”是谁、“上述”是哪些,都在上一段里。被引用率高的段落,通常把主语、范围、条件都写在句子内部。
2. 可核——句里有能被交叉验证的东西
一条和前文相通的规律:AI 敢照写的东西,是能被核对的东西。 段落里如果有具体事实——地名、资质类型、时间、数量区间、流程步骤——它被摘走时可以原样带上;如果只有“专业、领先、贴心”这类形容词,引擎只能用自己的话概括一遍,等于这段话没被真正引用。
这不是要求写流水账,而是每个结论旁边至少挂一个可核的事实锚点。
3. 无歧义——同一个实体的字段在各处一致
很多“名字提到了、细节没提到”的情况断在这里:名称、地址、联系号码、经营范围这几项,在不同页面上写法不一致。 对引擎来说,等于同一个实体存了多份互相打架的描述。稳妥的处理方式是放弃采信具体字段,只保留一个名字带过。
这套要求在本地检索领域有个现成的名字:NAP 一致性(Name / Address / Phone)。放到生成式场景里,范围要比三个字段更宽——还得加上营业时间、经营范围、所属行业这几项。
4. 格式稳定——标题写成断言,内容写成清单
结构上也有一条不成文的规矩:
- 小标题写成完整断言,不要写“服务介绍”“关于我们”这种目录式词组。断言能被整段抽走充当答案骨架,目录式标题抽出来没法用。
- 步骤与并列项用编号清单,别塞进长段落里的“第一、第二”。
- 别把答案锁在图片里。 走图像识别去取文字的成本与稳定性都远不如直接读文本,营业时间、价格口径、资质信息务必给文字版。
三、一个可以自己跑的自查脚本
把上面四条落成可执行的检查。下面这份脚本做三件事:检测段落自足度、检测可核事实密度、比对同一实体在不同页面的字段是否一致。
# -*- coding: utf-8 -*-
"""文本块可抽取性自查:自足度 / 可核密度 / 字段一致性。
只做静态检查,不发请求,不依赖任何第三方服务。
"""
import re
from collections import Counter
# 需要依赖上文的指代词:出现即说明这段离开上下文站不住
DEICTIC = ["这", "那", "其", "该公司", "本公司", "上述", "如下", "以上", "它"]
# 可核对事实的信号:数字、年份、地名后缀、资质与范围类词
FACT_HINT = [r"\\d", r"\\d{4}\\s*年", r"市|区|县|镇", r"资质|许可|认证|备案|标准|编号"]
def split_blocks(md: str):
"""按空行切块,跳过代码块与标题行。"""
# 围栏符号在运行时构造,避免示例代码自身被围栏截断
fence = chr(96) * 3
md = re.sub(fence + ".*?" + fence, "", md, flags=re.S)
blocks = []
for b in re.split(r"\\n\\s*\\n", md):
b = b.strip()
if not b or b.startswith("#"):
continue
blocks.append(b)
return blocks
def score_block(b: str) –> dict:
n = len(b)
hits = [w for w in DEICTIC if w in b]
fact = sum(len(re.findall(p, b)) for p in FACT_HINT)
# 自足:无指代词,且句子里出现了明确主语(简单用专名/名词信号近似)
self_contained = len(hits) == 0
return {
"len": n,
"deictic": hits,
"fact_hits": fact,
"self_contained": self_contained,
"ok": self_contained and fact >= 1 and 60 <= n <= 400,
}
def nap_consistency(pages: dict) –> dict:
"""pages: {页面名: 文本},比对各页面里出现的字段是否一致。"""
def grab(t, pat):
m = re.search(pat, t)
return m.group(1).strip() if m else None
out = {}
for field, pat in {
"号码": r"(?:联系方式|联系号)[:: ]*([\\d\\-+()]{7,})",
"地址中的城市": r"([一-龥]{2,6}市)",
}.items():
vals = {k: grab(v, pat) for k, v in pages.items()}
real = [v for v in vals.values() if v]
cnt = Counter(real)
out[field] = {
"取值": vals,
"一致": len(cnt) <= 1,
"提示": "各页面取值不一致,字段可能被忽略" if len(cnt) > 1 else "一致",
}
return out
if __name__ == "__main__":
import glob
files = sorted(glob.glob("pages/*.md"))
pages = {f: open(f, encoding="utf-8").read() for f in files}
print("== 字段一致性 ==")
for k, v in nap_consistency(pages).items():
print(f" {k}: {v['一致']} | {v['提示']} | {v['取值']}")
print("\\n== 段落可抽取性 ==")
for name, text in pages.items():
bad = 0
for b in split_blocks(text):
r = score_block(b)
if not r["ok"]:
bad += 1
print(f" [{name}] {r['len']}字 指代词={r['deictic']} 事实信号={r['fact_hits']}")
print(f" {b[:60]}…")
print(f" {name}: 待改段落 {bad} 段")
用法很朴素:把几个关键页面的文本丢进 pages/,跑一遍。“待改段落”多的那一页,通常就是详情信息长期不被引用的那一页。
这个脚本给的是提示,不是结论。self_contained 用的是词表近似,漏判难免;真正可靠的验证还是回到引擎里实际问一遍。
四、结构化标记:给引擎一份机器可读的底稿
文本形态之外,还有一层能让字段更容易被对齐:JSON-LD 结构化数据。
它的作用要说准——结构化数据不是排名开关,它是消歧辅助。它告诉引擎“这个字符串是一个企业名称、这串数字是联系号码、这几行是营业时间”,减少靠语义猜的成本。常见的两块:
<script type="application/ld+json">
{
"@context": "https://schema.org",
"@type": "LocalBusiness",
"@id": "https://example.com/#org",
"name": "示例企业名称",
"url": "https://example.com/",
"telephone": "+86-000-0000-0000",
"address": {
"@type": "PostalAddress",
"streetAddress": "示例街道 1 号",
"addressLocality": "示例市",
"addressRegion": "示例省",
"addressCountry": "CN"
},
"openingHoursSpecification": [{
"@type": "OpeningHoursSpecification",
"dayOfWeek": ["Monday", "Tuesday", "Wednesday", "Thursday", "Friday"],
"opens": "09:00",
"closes": "18:00"
}],
"sameAs": ["https://example.com/profile-a", "https://example.com/profile-b"]
}
</script>
页面上如果有问答块,再配一段 FAQPage,注意必须与页面可见内容一致——写了页面上看不到的问题,属于标记与内容不符,得不偿失:
<script type="application/ld+json">
{
"@context": "https://schema.org",
"@type": "FAQPage",
"mainEntity": [{
"@type": "Question",
"name": "示例问题?",
"acceptedAnswer": { "@type": "Answer", "text": "示例答案,与页面上这段文字保持一致。" }
}]
}
</script>
三点经验:
- @id 要用稳定地址。 同一个实体在多个页面出现时,稳定的 @id 能让引擎确认这些指的是同一个东西,这是最容易漏的一步。
- sameAs 把分散的官方主页串起来。 这是在显式声明“这些账号都是同一家”,比让引擎自己去猜要可靠。
- 必填项要齐。 LocalBusiness 至少需要 name 与 address;缺了必填字段,整块标记可能被整块忽略,等于白写。
五、三个高频误区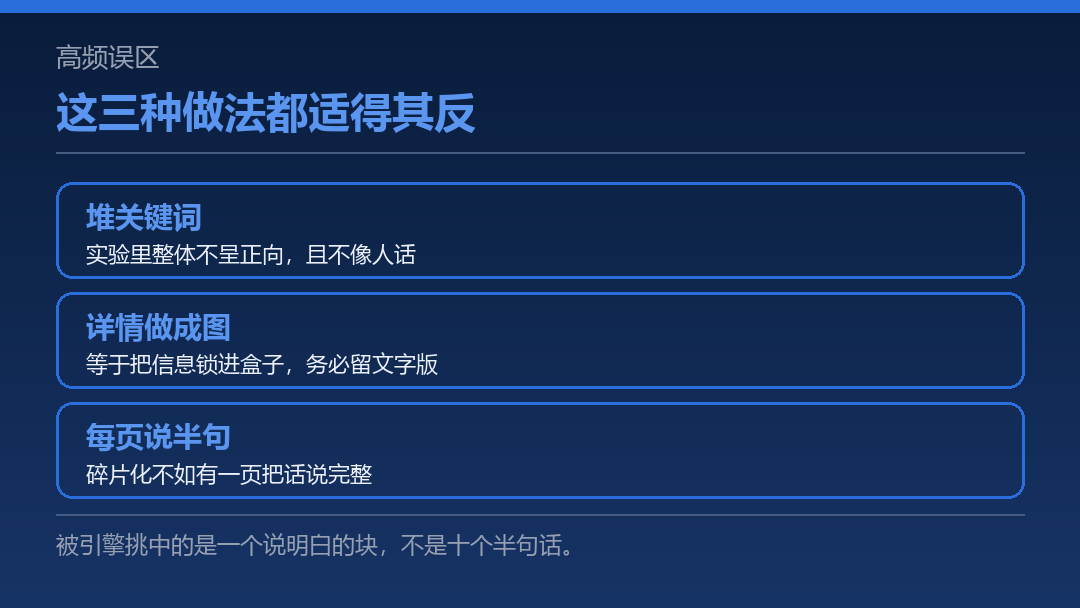
误区一:把关键词堆进去。 学界已有的实验结论是反直觉的——堆砌关键词在这类优化里往往不是正向手段。原因不难理解:关键词堆出来的句子不是人话,也就不是一段好的引文。它既不容易被引擎选中,读者也一眼看出不对劲。
误区二:把详情全做成图。 资质墙做成一张图、价格表做成一张图、流程做成一张图。视觉上漂亮,抓取侧等于把这些信息锁进了盒子里。图上有的,文字里必须再写一遍。
误区三:每页都说一点,没有一页说全。 十��页面各讲一句,不如有一页把某个话题讲完整。被引擎挑中的通常是一个能把话说明白的块,而不是十个半句话。 这是碎片化内容化最常见的坑。
六、边界
必须说清三条,不然这套东西容易被用过头:
能做的是什么?是把文本写得更自足、让事实更可核、把各处口径对齐、给机器一份干净的底稿。这些技术动作的终点其实很朴素:让真实发生过的事更容易被查到,也就是让认真做事的人被看见。剩下的部分,取决于引擎那一侧的检索策略与生成链路,不在我们的控制范围内。
FAQ
问:页面能正常访问,但详情从来不被引用,先查什么?
先看段落能不能脱离上下文成立。把页面上那段话单独抽出来读一遍,如果需要往上翻才知道说的是谁,问题就在这儿。
问:结构化数据必须写吗?
它不是入场开关,而是降低理解成本的手段。优先级排在“字段一致”与“段落自足”之后。前两项没做,只加标记效果有限。
问:NAP 一致到底要对齐哪些项?
至少:名称、地址、联系号码、经营范围、营业时间。前三项是传统本地检索的基本要求,放到生成式场景里,后两项同样会因为口径冲突而被整项忽略。
问:这段提到关键词堆砌是负向的,出处是?
生成式引擎优化方向的公开研究(普林斯顿大学、佐治亚理工学院、印度理工学院德里分校、艾伦人工智能研究院等机构发表于 KDD 2024 的工作)在受控实验里观察到这类手法整体不呈正向。注意两点:那是论文实验条件下的结论,不等于在你所选的平台上有同样的量级;实验环境也不含国内主流产品。
问:能不能跑几千次采样,然后算一个成功率出来?
能做,但先把用例固定下来。问法、使用的入口、时间窗口,任何一项变了,前后两次的数据就不可比。比起一次问很多次,更稳妥的做法是固定一组问法、定期复测、看趋势走向,而不是盯某一轮算出来的百分比。


评论前必须登录!
注册