 网硕互联帮助中心
高性能内存分配器内核:Jemalloc 与 TCMalloc 线程本地缓存(Thread Cache)、Size Class 与内存碎片治理
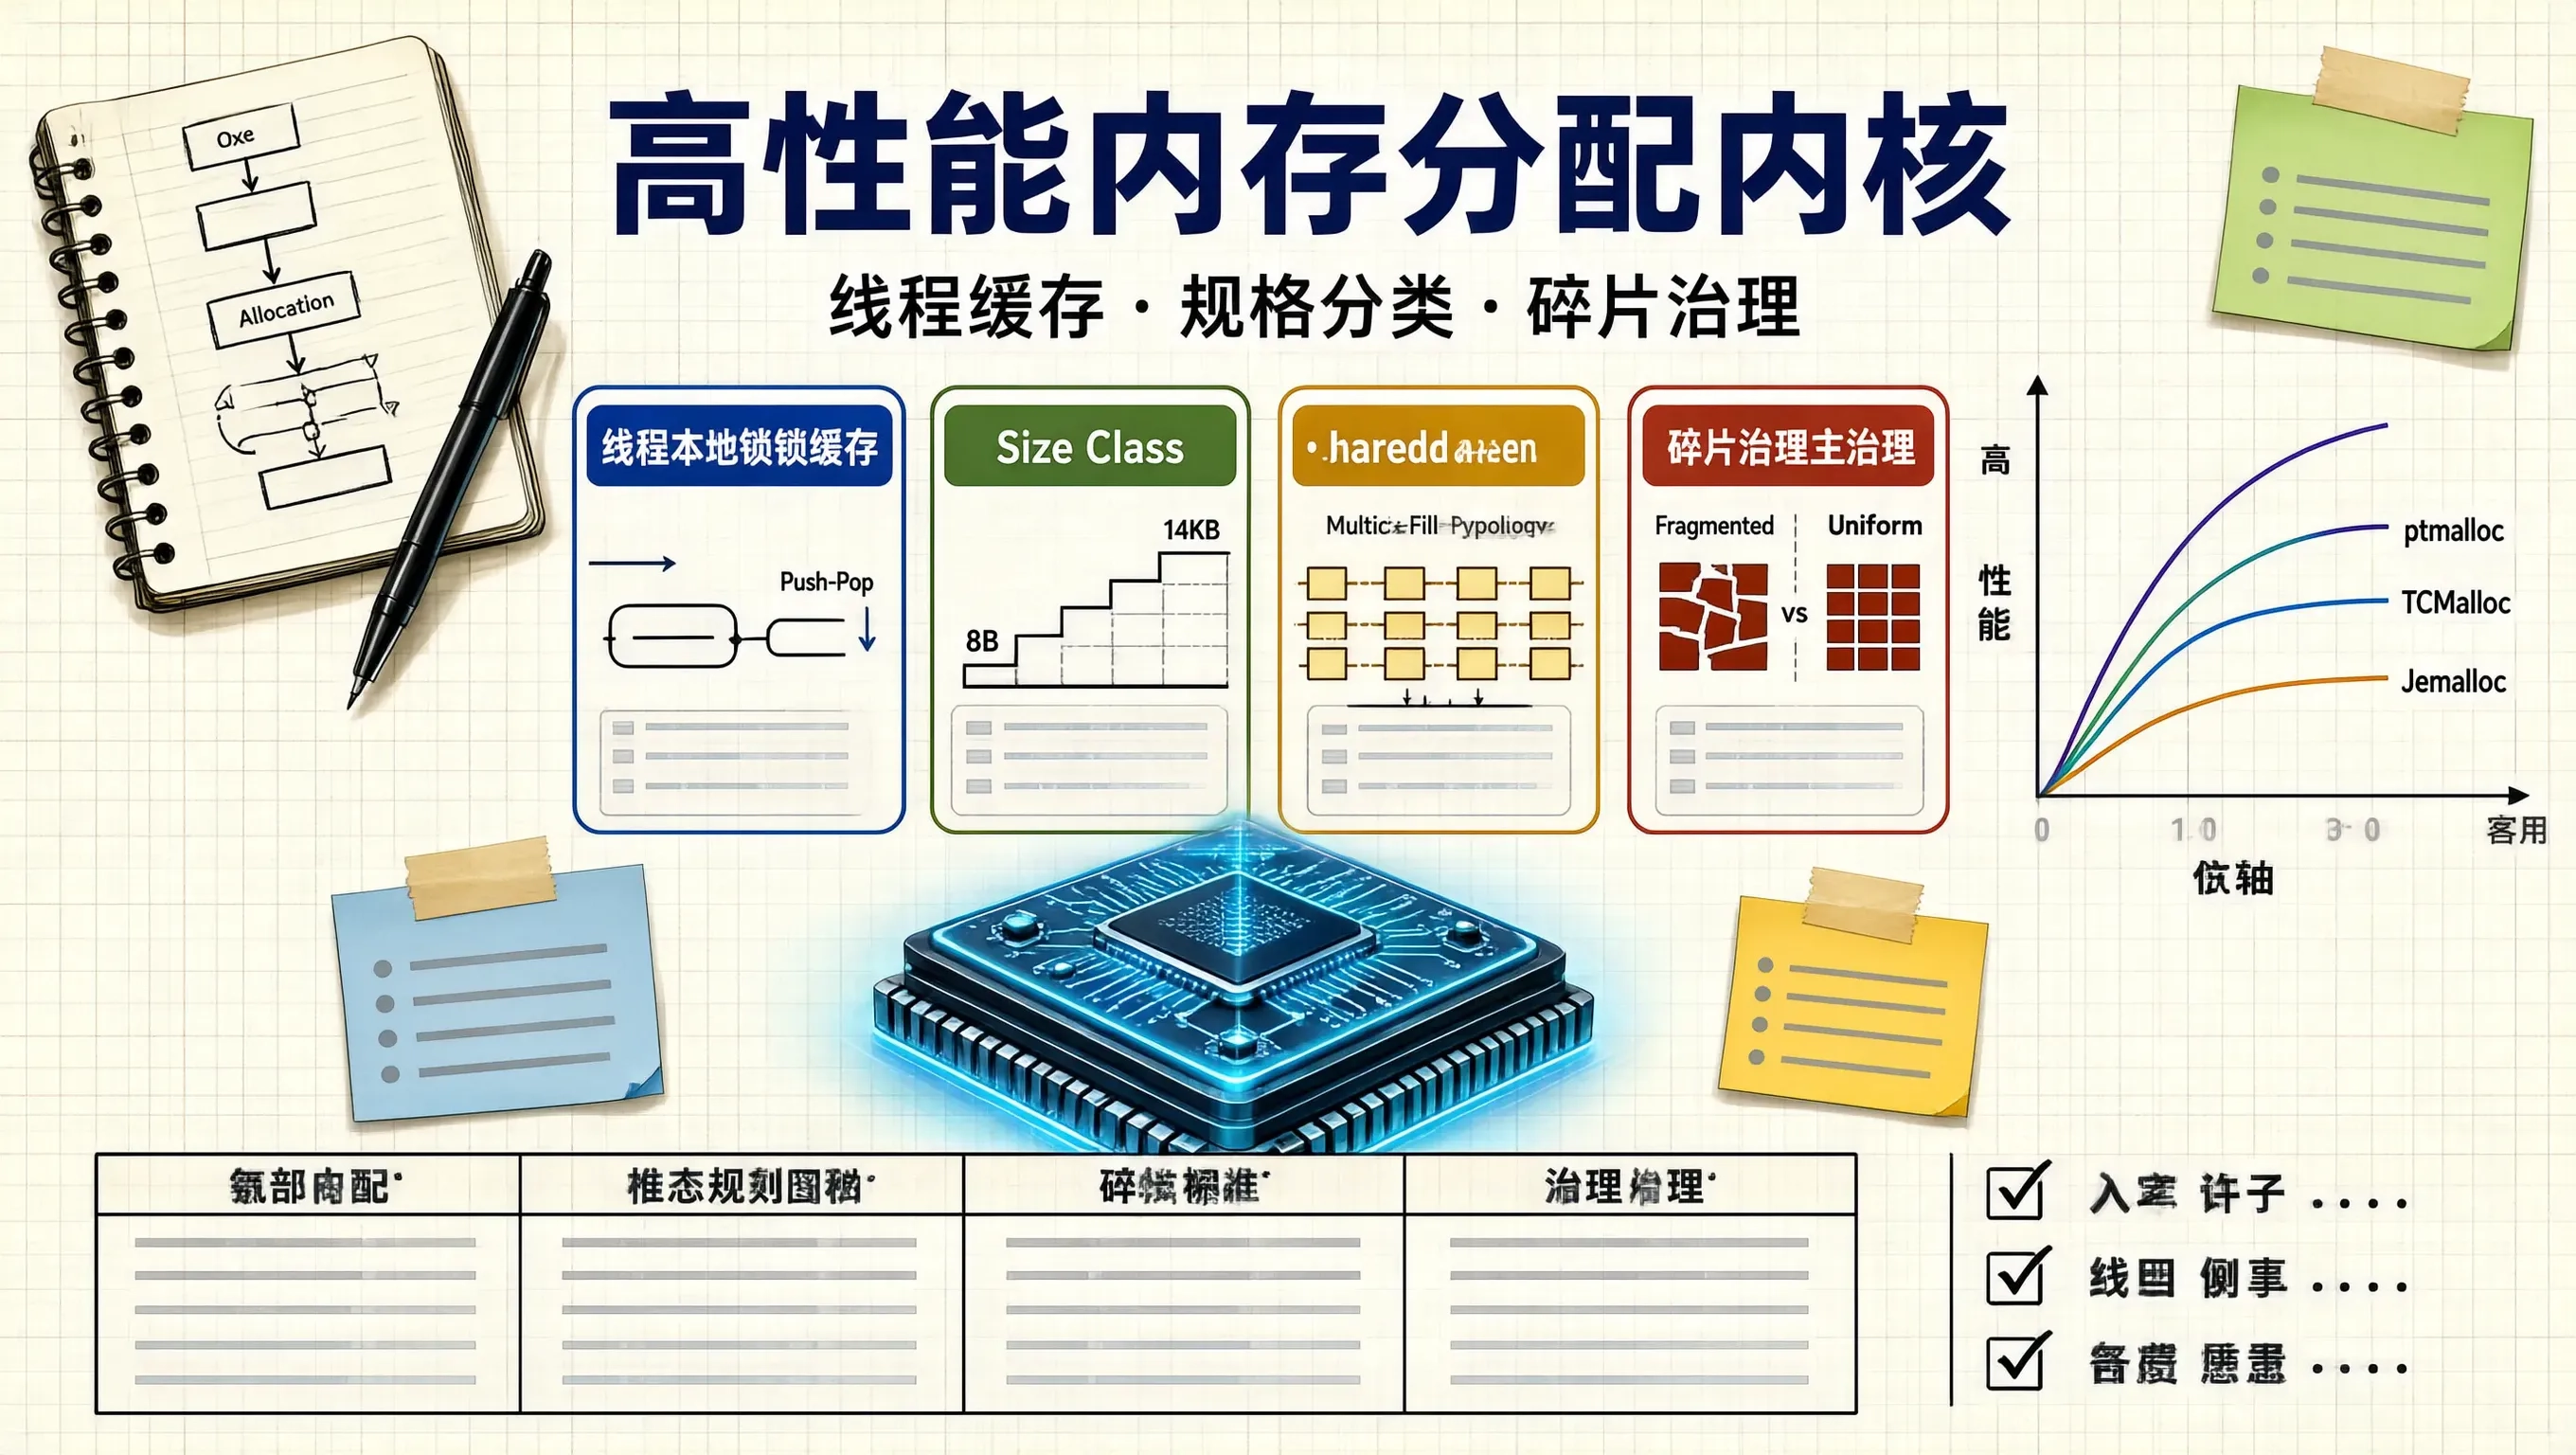
在现代高并发底层系统开发(如 Redis 默认采用的 Jemalloc、Google Chrome 与 Go 语言底层采用的 TCMalloc,以及 Java Netty 默认使用的 PooledByteBufAllocator)中,“内存分配器(Memory Allocator)” 是支配整个系统吞吐与内存利用率的最核心底层引擎。
标准的 glibc ptmalloc 在多核高并发场景下,存在两大无法忍受的致命缺陷:
Jemalloc(Jason Evans' Malloc) 与 TCMalloc(Thread-Caching Malloc) 创造性地通过 “线程本地无锁缓存(Thread Cache,tcache)”、“定长规格分类(Size Classes)” 与 “分层 Arena 架构”,实现了 纳秒级零锁分配与低于 5% 的极致内存碎片率!
今天我们深入两大高性能分配器的底层内核架构,把内存分级分配流程、伙伴系统与回收自愈时序彻底讲透。
Jemalloc / TCMalloc 核心分层架构全景拓扑图
graph TD
App[应用程序线程调用 malloc(size)] –> CheckSize{根据 size 归类到 Size Class}
CheckSize –> Small[1. 小对象 Small Alloc (<= 14KB/32KB)]
Small –> TCache{查线程本地私有缓存 tcache / ThreadCache}
TCache –>|命中! (单线程独占, 严格 0 锁争用!)| FastReturn[🔥 3 纳秒极速返回内存指针!]
TCache –>|未命中 (本地空盘)| Arena[2. 批量向所属 Arena / CentralFreeList 批发一批内存块 (加细粒度分片锁)]
Arena –> Extent[3. 若 Arena 也不足: 向 Extents / PageHeap 申请大物理页]
CheckSize –> Large[2. 大对象 Large Alloc (32KB ~ 4MB)]
Large –> Arena
CheckSize –> Huge[3. 巨型对象 Huge Alloc (> 4MB)]
Huge –> DirectOS[直接通过 mmap() 向操作系统申请独立大虚拟内存映射]
一、核心支柱一:线程本地无锁缓存(Thread Cache,tcache)
为什么它能消灭 95% 的锁竞争?
在多核多线程系统中,绝大多数的内存分配都是**“临时、频繁的小对象(如 32 字节、64 字节、128 字节)”**。Jemalloc 为每一个线程分配了一个私有的 tcache(Thread Local Cache):
- 线程在申请小对象时,直接从自己的 tcache 单链表中弹出一个空闲槽位(Pop);
- 释放内存时,直接压入自己的 tcache 栈顶(Push);
- 全程完全不需要任何互斥锁,也不需要 CAS 原子操作!单次分配耗时仅需 3~5 个时钟周期(约 3 纳秒)!
二、核心支柱二:定长规格分类(Size Classes)消灭外部内存碎片
传统的空闲链表分配(如 First-Fit、Best-Fit)会根据用户请求的任意字节数(如 37 字节、91 字节)在内存中随意切割,随着时间推移产生海量外部碎片。
Jemalloc 的定长规整分类(Size Classes):
Jemalloc 严禁随意切割内存,将所有内存请求严格向上取整(Round Up) 对齐到离散的固定规格(Size Classes)中:
Jemalloc Size Classes 阶梯表 (共 200+ 个精细规格):
* Small Tiny 规格: 8B, 16B, 32B, 48B, 64B, 80B, 96B, 112B, 128B
* Small Quantum 规格: 160B, 192B, 224B, 256B, 320B, 384B, 448B, 512B …
* Large 规格: 16KB, 32KB, 64KB, 128KB, 256KB, 512KB, 1MB, 2MB, 4MB
- 物理收益:若用户请求分配 35 字节,系统统一分配 48 字节的槽位;虽然牺牲了微小的内部碎片(13 字节),但所有相同规格的内存块在物理上整齐划一,释放后可以被后续任意同规格请求 100% 完美复用,彻底消除了破坏性的外部碎片!
三、核心支柱三:分片 Arena 架构与批量填充(Chunk Filling)
当某个线程的 tcache 中的 64 字节槽位耗尽时:
- 线程不会一次只向底层申请 1 个对象,而是一次性向其绑定的 Arena“批发”一大批(如 64 个)连续的内存块填充进 tcache(Batch Filling);
- 分片 Arena(Sharded Arenas):Jemalloc 默认根据 CPU 核心数创建 $4 \\times N_{\\text{cores}}$ 个独立的 Arena。各个线程通过哈希散列绑定到不同的 Arena 上,即使向底层批发内存,不同核心之间的锁冲突概率也被稀释了数十倍!
四、Netty PooledByteBufAllocator 对 Jemalloc 的经典工程复刻
Java Netty 框架的高性能堆外直接内存池,在架构设计上 100% 深度借鉴并复刻了 Jemalloc 的架构思想:
graph LR
subgraph Netty 内存池层次结构 (Jemalloc Java 复刻版)
PoolThreadCache[PoolThreadCache: 线程私有无锁缓存] –> PoolArena[PoolArena: 分片区域 (DirectArena / HeapArena)]
PoolArena –> PoolChunkList[PoolChunkList: 管理 16MB 的大 Chunk]
PoolChunkList –> PoolChunk[PoolChunk: 采用完全二叉树伙伴算法 Buddy Allocation]
PoolChunk –> PoolSubpage[PoolSubpage: 将 8KB Page 切分为精细的 Tiny/Small 槽位]
end
Netty 内存池分配极速代码:
// 从 Jemalloc 思想的直接内存池中分配 256 字节
ByteBuf buf = PooledByteBufAllocator.DEFAULT.directBuffer(256);
try {
// 业务极速读写
} finally {
// 释放时直接归还回当前线程的 PoolThreadCache, 零系统调用与零 GC 垃圾!
buf.release();
}
内存分配器性能全景对比矩阵
| glibc ptmalloc | 较差(多核严重锁竞争) | 较差(长期运行易内存泄漏式膨胀) | 中等 | Linux 默认标准库 |
| Google TCMalloc | 极高(ThreadCache 无锁) | 极佳 | 极佳 | Google Chrome、Go 运行时内存分配器 |
| Jemalloc | 极致(Sharded Arena + tcache) | 最强(Extents 树形精细合并) | 极佳 | Redis 默认分配器、FreeBSD、Netty |
实习生的体系结构总结
高性能内存分配器是现代计算机底层软件工程中最精密、最优雅的“空间与时间平衡艺术”。它用线程私有缓存(tcache)战胜了锁争用,用离散规格(Size Classes)消灭了碎片黑洞,用批量批发与分片 Arena 征服了多核吞吐。深刻理解 Jemalloc 与 TCMalloc 的内核架构,不仅为你打开了高性能 C/C++ 调优的大门,更为你在 Java 堆外内存与高并发架构设计中提供了永恒的架构灵感。


评论前必须登录!
注册