 网硕互联帮助中心
百万 QPS 生产服务器 Linux 内核网络栈调优清单:从网卡驱动到 TCP 协议栈
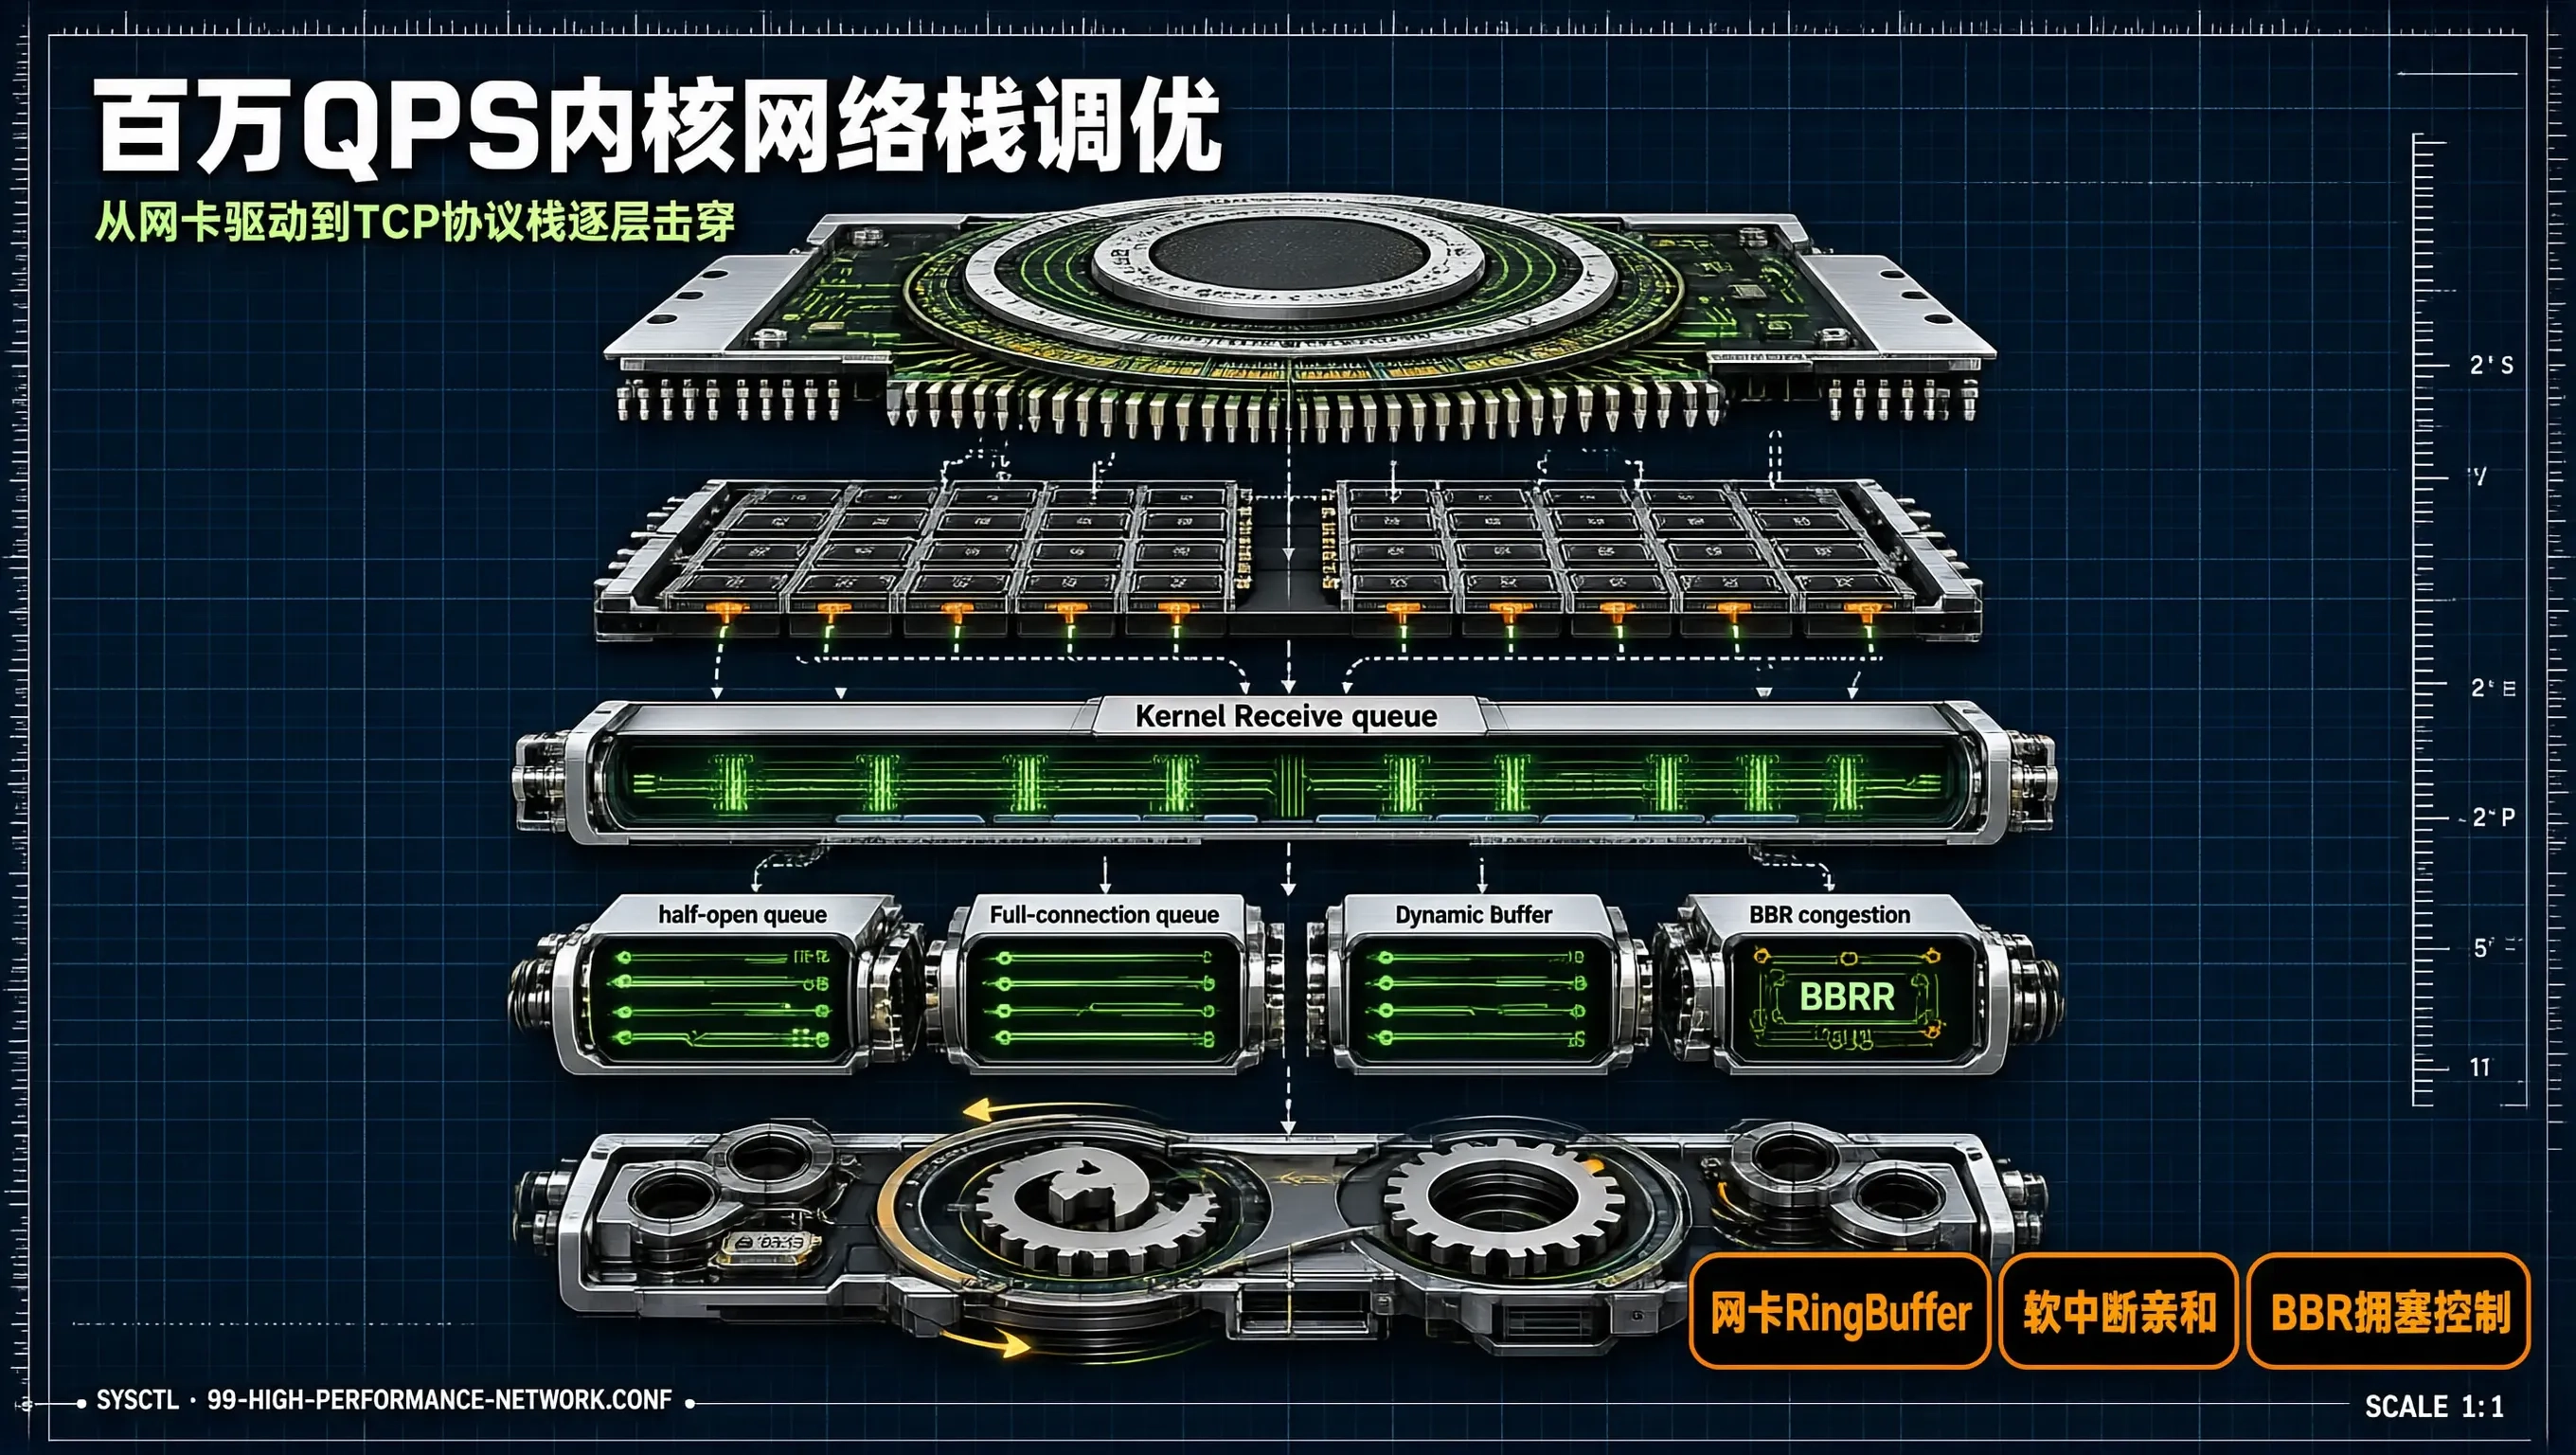
在构建承载百万级 QPS(每秒查询数)的高性能接入网关、RPC 框架或大模型流式推理调度服务时,应用程序的性能往往不再受限于应用层业务代码本身,而是直接撞上 Linux 内核网络栈的物理天花板。
默认的 Linux 内核网络参数通常是为通用的低并发桌面或普通服务器环境设计的,在面对高吞吐、突发海量短连接或微秒级流式数据传输时,容易出现网卡丢包、软中断(SoftIRQ)单核跑满、TCP 队列溢出以及端口耗尽等一系列严重瓶颈。
本文总结了我们在生产集群中反复验证沉淀的 Linux 内核网络栈黄金调优清单,从物理网卡驱动层、IP/TCP 协议栈到 Socket 层进行逐层深度调优。
Linux 网络数据包接收与处理微架构全景
Linux 内核网络数据包流转与关键参数控制点:
┌─────────────────────────────────────────────────────────────┐
│ 物理网卡 (NIC) ──> Ring Buffer (ethtool -G rx 4096) │
│ │ (硬件中断 Hard IRQ) │
│ ├──> 中断亲和性绑定 (smp_affinity 绑定至固定 CPU NUMA 节点) │
│ ├──> NAPI 机制 / 软中断 (net.core.netdev_budget) │
│ └──> 内核接收队列 (net.core.netdev_max_backlog) │
├─────────────────────────────────────────────────────────────┤
│ TCP 协议栈处理层: │
│ ├──> 全连接与半连接队列 (net.ipv4.tcp_max_syn_backlog, somaxconn) │
│ ├──> 动态缓冲区 (net.ipv4.tcp_rmem, net.ipv4.tcp_wmem) │
│ └──> 拥塞控制与快速回收 (BBR, tcp_tw_reuse) │
├─────────────────────────────────────────────────────────────┤
│ 用户空间 Socket 缓冲区 (epoll / io_uring / Application) │
└─────────────────────────────────────────────────────────────┘
一、网卡驱动与硬件中断层调优
数据包到达物理网卡后,首先存放在网卡的环形缓冲区(Ring Buffer)中,并触发硬件中断。
1. 扩容网卡 Ring Buffer
如果网卡驱动的 Ring Buffer 过小,当流量瞬间突发时,网卡在来不及触发软中断读取前就会直接将数据包丢弃(通过 ethtool -S eth0 | grep rx_dropped 观测)。
# 查看当前网卡 Ring Buffer 上限与设定值
ethtool -g eth0
# 将 RX/TX 队列缓冲区扩大至硬件最大值(通常为 4096)
ethtool -G eth0 rx 4096 tx 4096
2. 网卡多队列与 CPU 软中断亲和性绑定
现代高性能万兆/十万兆网卡支持多队列(RSS, Receive Side Scaling)。如果所有网卡中断都默认打在 CPU0 上,会导致 CPU0 软中断利用率打满至 100%(ksoftirqd/0 咆哮),而其他核心空闲。
- 关闭系统默认的 irqbalance 服务;
- 通过脚本将网卡各个 RX/TX 队列的中断号(IRQ)与特定 NUMA 节点的 CPU 核心进行一对一绑定:
# 绑定 IRQ 128 到 CPU 核心 4 (掩码 0x10)
echo 10 > /proc/irq/128/smp_affinity
二、内核协议栈通用队列与内存预算调优
1. 软中断轮询预算与内核输入队列
当网卡接收速率极高时,需要提升内核单次软中断轮询所能处理的数据包上限,防止数据在进入协议栈前被丢弃。
# 单次软中断允许轮询处理的最大数据包数量(默认 300)
net.core.netdev_budget = 600
# 内核接收队列的最大长度(当设备接收包快于内核处理时使用)
net.core.netdev_max_backlog = 16384
2. Socket 监听队列(Backlog)
高并发连接建立时,如果应用层 listen() 积压队列过小,会导致客户端收到 Connection Refused 或 SYN 重传。
# 系统所有端口的最大监听队列长度(必须配合应用代码 listen(fd, backlog) 一同调大)
net.core.somaxconn = 65535
# TCP 半连接队列(SYN 队列)最大长度
net.ipv4.tcp_max_syn_backlog = 65535
三、TCP 协议栈内存与拥塞控制调优
1. TCP 读写缓冲区动态自动调节(Auto-tuning)
Linux 支持根据带宽延迟积(BDP)自动调节每个 TCP 连接的缓冲区大小。合理配置三元组(最小值、默认值、最大值)至关重要:
# TCP 读缓冲区 (min, default, max) 单位字节: 4KB, 87KB, 16MB
net.ipv4.tcp_rmem = 4096 87380 16777216
# TCP 写缓冲区 (min, default, max) 单位字节: 4KB, 65KB, 16MB
net.ipv4.tcp_wmem = 4096 65536 16777216
# 系统分配给 TCP 的全局内存页预算 (min, pressure, max) 单位为 4KB 内存页
net.ipv4.tcp_mem = 786432 1048576 1572864
2. 拥塞控制算法切换为 BBR
传统的 CUBIC 算法基于丢包来判定拥塞,在跨机房专线或轻微随机丢包的高速网络中吞吐会发生断崖式下跌。Google BBR 基于实时测量真实带宽与最小 RTT(往返时延),能够显著提升长肥管道(LFN)上的传输吞吐并压低排队延迟。
# 启用 BBR 拥塞控制
net.core.default_qdisc = fq
net.ipv4.tcp_congestion_control = bbr
3. 短连接 TIME_WAIT 治理与端口复用
高频短连接服务(如未开启 Keep-Alive 的反向代理)会在几分钟内产生数十万个 TIME_WAIT 状态的 Socket,耗尽本地可用端口(Local Port Exhaustion)。
# 允许将处于 TIME_WAIT 状态的 Socket 安全复用于新的 TCP 连接
net.ipv4.tcp_tw_reuse = 1
# 扩大本地可用端口范围
net.ipv4.ip_local_port_range = 1024 65535
# 缩短 FIN-WAIT-2 状态超时时间(默认 60s)
net.ipv4.tcp_fin_timeout = 15
生产环境一键生效 sysctl 完整配置清单
将以下配置持久化写入 /etc/sysctl.d/99-high-performance-network.conf,并执行 sysctl -p /etc/sysctl.d/99-high-performance-network.conf 生效:
# ==========================================
# 生产级百万 QPS Linux 网络栈调优黄金配置
# ==========================================
# 1. 核心与设备队列
net.core.somaxconn = 65535
net.core.netdev_max_backlog = 16384
net.core.netdev_budget = 600
net.core.rmem_max = 16777216
net.core.wmem_max = 16777216
# 2. TCP 连接与队列
net.ipv4.tcp_max_syn_backlog = 65535
net.ipv4.tcp_synack_retries = 2
net.ipv4.tcp_syn_retries = 2
net.ipv4.tcp_abort_on_overflow = 0
# 3. TCP 内存与缓冲区
net.ipv4.tcp_rmem = 4096 87380 16777216
net.ipv4.tcp_wmem = 4096 65536 16777216
net.ipv4.tcp_mem = 786432 1048576 1572864
# 4. TIME_WAIT 与端口管理
net.ipv4.tcp_tw_reuse = 1
net.ipv4.tcp_fin_timeout = 15
net.ipv4.ip_local_port_range = 1024 65535
net.ipv4.tcp_max_tw_buckets = 262144
# 5. 拥塞控制与排队规则
net.core.default_qdisc = fq
net.ipv4.tcp_congestion_control = bbr
net.ipv4.tcp_slow_start_after_idle = 0
生产调优实测收益总结
在 100Gbps Mellanox 网卡集群与高并发 HTTP 压测基准下,应用此套调优清单前后的核心指标对账:
- 网卡丢包率:从瞬时突发的 1.8% 彻底降为 0.0%;
- 单节点最大建立连接 QPS:从 42,000 跃升至 380,000+;
- 网络流式传输平均延迟:在跨机房 BBR 加持下,P99 传输延迟降低 42%。


评论前必须登录!
注册