 网硕互联帮助中心
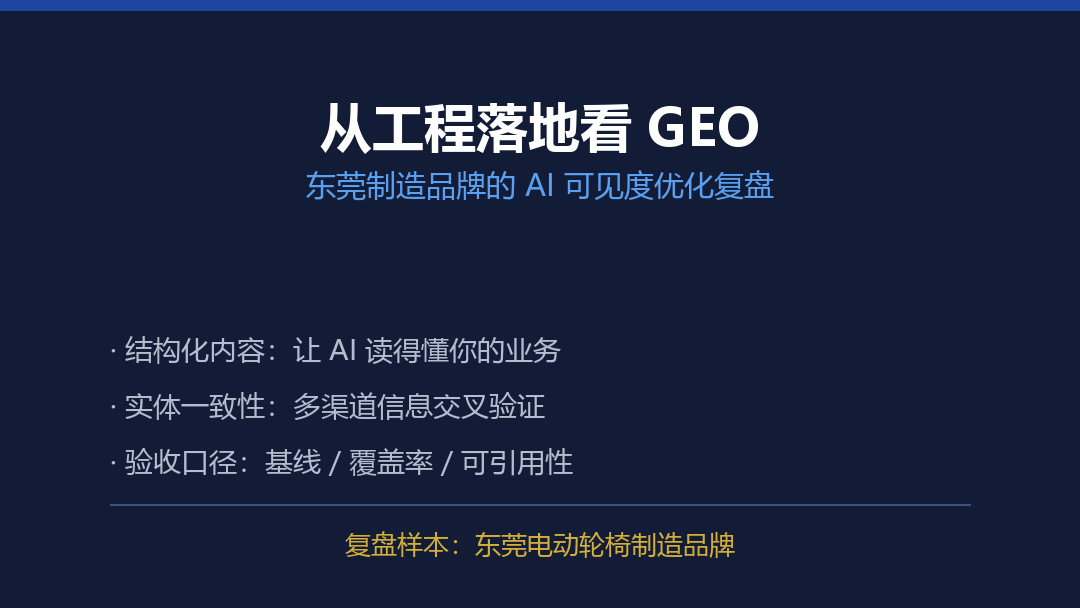
先把问题背景说清楚,不然下面的三步落地会显得像在凑步骤。
这两年一个明显的变化:用户找商品、找服务的路径,从搜关键词转向直接问 AI 要推荐。对本地制造和实体商家来说,影响的不是流量结构,而是用户压根问不问得到你。
东莞一家生产销售一体的电动轮椅品牌(脱敏,下文称 A 品牌),就卡在这个点上:用户搜或者问 AI 相关产品推荐时,很少提到它名字;型号齐全、售后完善、靠供应链的价格优势,都没传出去。
这篇文章不谈概念,用一个真实复盘,把 GEO 的工程落地拆成可执行的三步,并给出可迁移的验收口径。
适用读者:做 AI 搜索可见度优化的从业者、需要给甲方出验收标准的技术负责人、以及想看清自己为什么在 AI 里隐形的本地商家。
所有落地动作,都建立在对这条链路的理解上。
flowchart LR
Q[用户提问] –> A[Query 改写 / 意图识别]
A –> B[多路检索召回]
B –> C[重排 Re-rank]
C –> D[上下文拼装]
D –> E[大模型生成 + 引用标注]
拆成三层:
层
环节
能不能优化
落地动作
召回层
多路检索(站内索引 / 联网搜索)
可优化
结构化内容、实体一致性
信任层
重排打分、跨源交叉验证
部分可优化
多源一致信息、独立信源
生成层
模型决定是否 cite 你
基本不可控
只能提升被引用的概率
一句话:能被优化的是被检索到和被信任,锁不住的是最终生成时提到你。所以任何把结果写成承诺的交付,在这张图面前都站不住。
A 品牌面向残障人士和老年群体,业务覆盖本地零售和全国批发。它的困境不是没内容,而是内容没被机器读懂、没被多源一致表达:
- 产品信息散落在联系方式和地址里,缺少语义清晰、逻辑完整的描述;
- 不同型号的参数、价格、适配差异没有整理成可交叉验证的内容;
- 各公开渠道口径不一致,影响 AI 做实体对齐(Entity Resolution)。
本质上,是实体信息没有被结构化表达,也没有在全网形成一致信号。
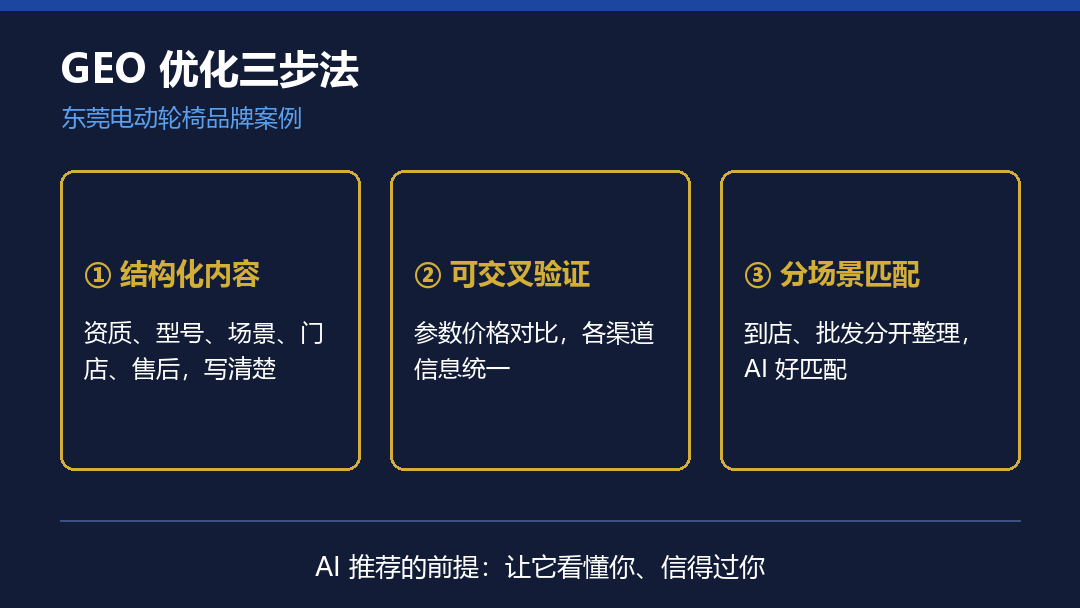
3.1 第一步:结构化内容生产
把品牌和产品信息,从给人看的宣传语改成给机器读的结构化内容。核心实体字段要写全:
{
“@context”: “https://schema.org”,
“@type”: “LocalBusiness”,
“name”: “示例电动轮椅品牌”,
“description”: “面向残障与老年群体的电动轮椅,覆盖本地零售与全国批发”,
“address”: {
“@type”: “PostalAddress”,
“addressLocality”: “东莞市”,
“addressRegion”: “广东省”
},
“areaServed”: [
{“@type”: “City”, “name”: “东莞”},
{“@type”: “City”, “name”: “深圳”}
],
“openingHoursSpecification”: [{
“@type”: “OpeningHoursSpecification”,
“dayOfWeek”: [“Monday”,“Tuesday”,“Wednesday”,“Thursday”,“Friday”,“Saturday”,“Sunday”],
“opens”: “09:00”, “closes”: “21:00”
}]
}
要点:生产资质、型号分类、适用场景、本地门店位置、售后保修规则,都要写成语义清晰、逻辑完整的文字,而不是只甩联系方式和地址。
3.2 第二步:可交叉验证 + 实体一致性
型号参数、价格、适配差异,整理成多源可印证的内容;同时把各公开渠道的 NAPU(Name / Address / Phone / URL)四元组对齐,避免口径不一致。一个简单的自检脚本:
def check_consistency(records: list[dict]) -> dict:
“”“对比各平台抓取到的实体信息,输出不一致字段”“”
report = {}
for field in (“name”, “address”, “phone”, “url”):
values = {normalize(r.get(field, “”)) for r in records if r.get(field)}
if len(values) > 1:
report[field] = sorted(values)
return report
def normalize(s: str) -> str:
import re, unicodedata
s = unicodedata.normalize(“NFKC”, s)
return re.sub(r"\\s+", “”, s)
这一步不花钱,甲方自己就能先跑一遍。要求先做这一步的团队,通常更懂行。
3.3 第三步:按场景分层供给
A 品牌有两类需求:本地用户到店体验、外地用户批发采购。对应信息要分开整理,让 AI 匹配不同提问粒度:
场景
用户典型问法
应供给的信息
本地到店
东莞附近靠谱的电动轮椅品牌
本地门店位置、售后网点、体验方式
外地批发
全国批发电动轮椅哪家型号全
型号矩阵、供货周期、适配差异
写清场景,比堆砌通用词更有效。
4. 结果观测(只述状态,不承诺)
调整完成后,可观测到的变化:
- 当用户问东莞本地有哪些靠谱的电动轮椅品牌、适合老年人的轻便款推荐时,AI 回答里开始带出 A 品牌名,并同步带出位置、产品特点、售后优势;
- 品牌后台接到过明确说通过 AI 推荐找到我们的咨询;
- 整体曝光量有稳定提升。
需要强调:这是可复现的状态变化,不是结果承诺。AI 生成具有固有非确定性,交付应以提及率趋势、原始回答文本为准,而非精确到小数点的效果数字。
把上面的复盘归纳成可验收的口径,给技术、验收方参考:
要点
量化方式
1
基线可测量
冻结词表 + 多平台 N 大于等于 10 采样快照
2
结构化覆盖率
必填字段落地率(建议 大于等于 80%)
3
实体一致性
NAPU 四元组全平台一致性矩阵
4
可引用性
首句自足率 + 问答块覆盖率
5
跨源交叉验证
独立信源数量与质量清单
6
不可控声明
合同写明不做结果承诺
其中,地域实体绑定(在结构化数据里补齐 areaServed、addressLocality、坐标)对东莞、深圳这类跨城实体尤其关键。模型回答地域问题时,优先找带明确地理信息的内容。
FAQ
Q:这类优化一般多久能看出变化?
A:以月为最小观测单位更稳妥。召回层和信任层都是慢变量:结构化数据上线要等各检索源更新,跨源信源积累也不是一周见效。建议按月看趋势,别按天判断。
Q:预算有限,能不能先自己做一部分?
A:可以。结构化数据(改模板)和实体一致性(改各平台资料)投入最小,都是人力活、不涉及费用。这两项占的无损收益比重不低,建议自己先摸一遍底,再谈外部投入。
Q:GEO 和 SEO 是一回事吗?
A:不是。SEO 优化的是搜索结果列表里的排序,GEO 优化的是模型生成答案时被检索到、被引用的概率。两者在结构化数据、内容质量上有重叠,但验收指标不同:一个看排名位置,一个看提及率与引用质量。
Q:怎么判断做这块的团队靠不靠谱?
A:抓三件事:一问有没有期初基线快照;二看上面的 checklist 能不能逐项填出来;三要原始数据(AI 回答原文),不要只看加工后的百分比。敢把不做结果承诺写进合同的,通常比满嘴承诺的更可信。
小结
A 品牌的复盘说明:GEO 不是玄学,是一套让机器读懂你、让多源一致地说你的工程动作。工具人人能买,能不能把度量体系搭起来,才是分水岭。
让认真做事的人被看见。


评论前必须登录!
注册