 网硕互联帮助中心
一段语音是如何进入人工神经网络的?
语音人工神经网络的前端处理是语音识别、语音合成、语音增强等任务中的关键环节。
前端处理包括:语音预处理 特征提取
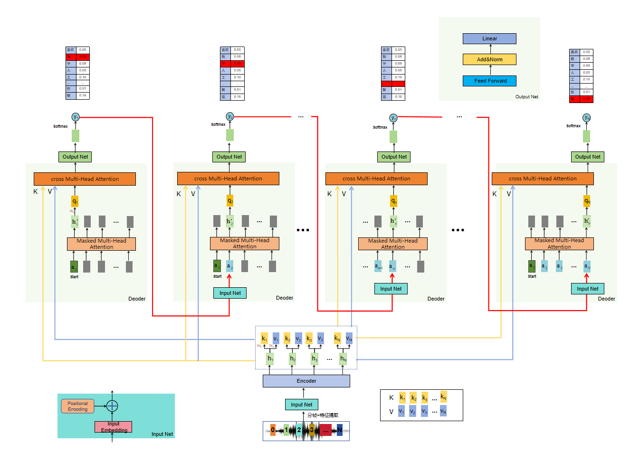
图1、语音输入到Transformer中
语音预处理大致总流程如图:
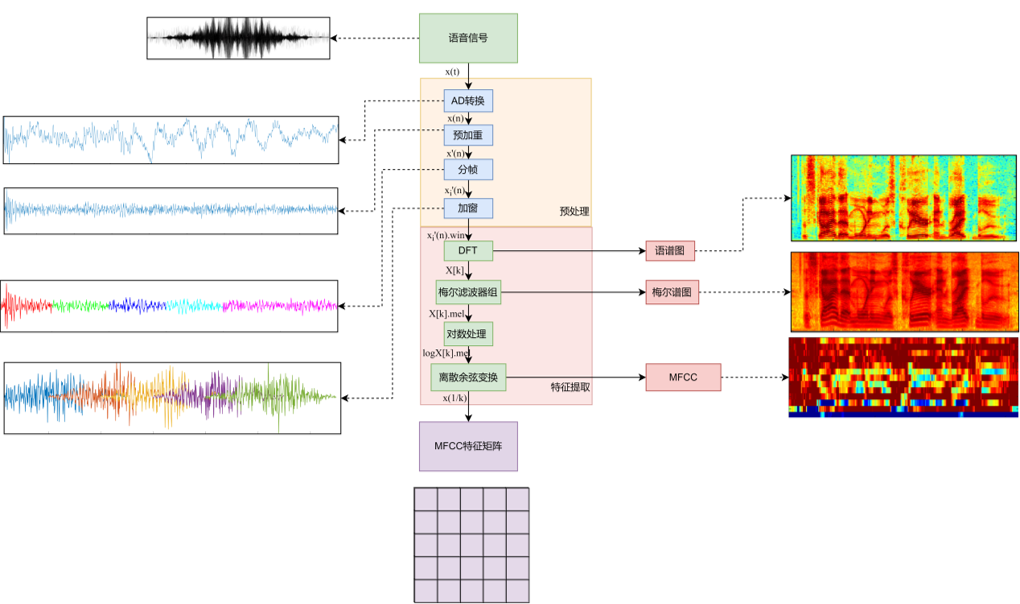
图2、语音预处理框架
一,语音预处理
1、预加重
语音信号通过发声者的口唇辐射传播,空气作为传播介质,在传递声音能量的同时会导致一定的能量损耗。特别是高频成分,因介质的衰减效应损失更为显著。预加重技术通过增强语音信号中的高频成分,有效弥补高频损耗,从而更好地保护声道中蕴含的信息。
假设输入信号第 𝑛个采样点为 𝑥[n],a为预加重系数,则输出y[n]公式如下:
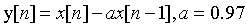
对应的传递函数为:
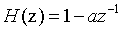
频率响应为(f为频率,fs为采样率):
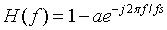
下图是预加重滤波器对不同频率成分的影响程度。增益反映了在特定频率下,预加重滤波器对信号的放大或衰减程度。它是频率响应的幅值(大小)在对数尺度上的表示。
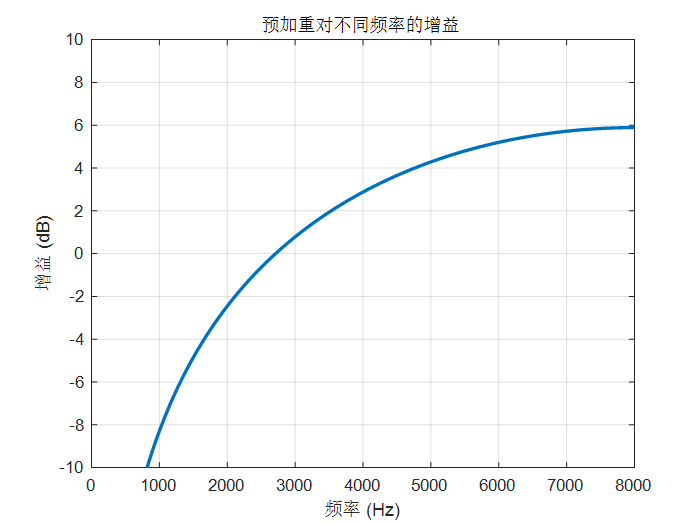
图3、预加重对语音信号不同频率的增益
在 Matlab 中实现语音预加重:
#读取音频,采样率
[audioIn, fs] = audioread('voice_test.wav');
#预加重
pre_emphasis = 0.97;
y_preemphasized = filter([1 -pre_emphasis], 1, audioIn);
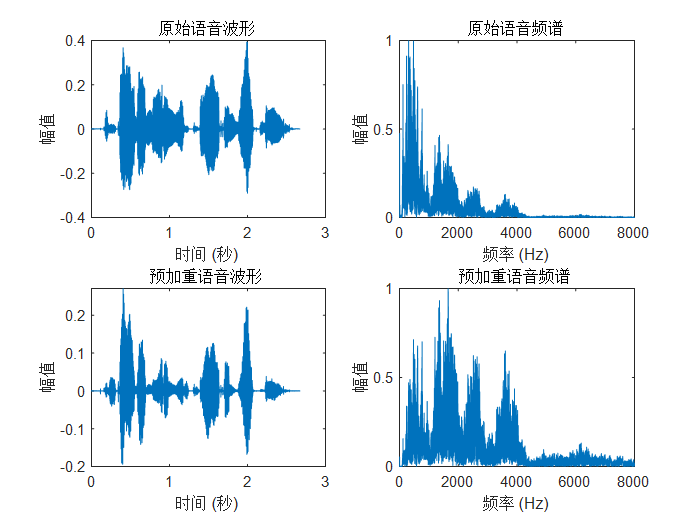
图4、预加重对语音信号频谱的改变
2、分帧
算法在处理语音信号时,一般首先采用的是傅里叶变化,将语音信号由时域转换到频域空间。但是直接处理长时间的非平稳信号会非常困难,且难以提取稳定的特征。
由于短时平稳性,即在一个较小的时间窗口(通常是 20-40 毫秒)内,信号的统计特性相对稳定。因此,通过将长语音信号分帧处理(即将信号分成短的时间段进行分析),可以使得每个帧内的信号近似平稳。
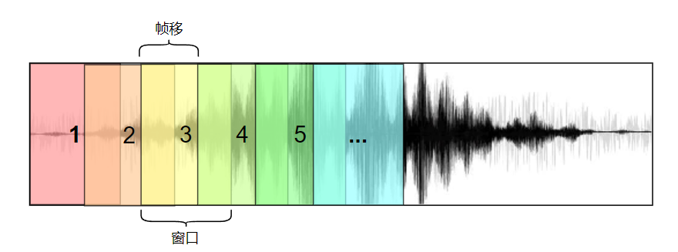
图5、分帧示意图
分帧后,通过滑动窗口对语音信号进行分析,可以实时地对信号进行处理。
为了保证在帧之间不会丢失重要信息,通常会在分帧时设置一定的帧重叠(通常是 50% 左右的重叠)。这意味着相邻帧之间会共享一部分样本,确保信号的连续性,尤其是在快速变化的地方不会丢失关键信息。
在Matlab中实现语音分帧处理:
#定义帧长度和步长
frame_length = round(0.025 * fs); % 25 ms 窗长度
frame_step = round(0.010 * fs); % 10 ms 步长
#计算帧数
num_frames = floor((length(y_preemphasized) – frame_length) / frame_step) + 1;
#初始化帧矩阵
frames = zeros(frame_length, num_frames);
#分帧操作:将信号逐帧划分并存储到帧矩阵中。
for i = 1:num_frames
start_idx = (i-1) * frame_step + 1;
end_idx = start_idx + frame_length – 1;
frames(:, i) = y_preemphasized(start_idx:end_idx);
end
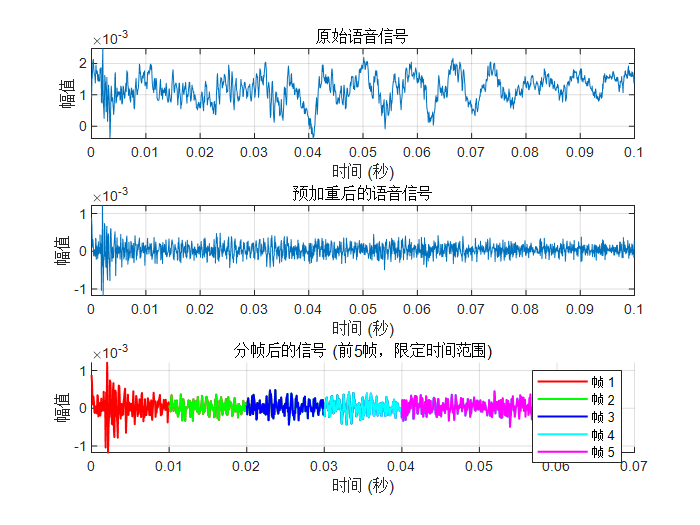
图6、分帧结果
3、加窗
加窗是一种在信号截断前对其进行预处理的方法,通过在时域上乘以一个窗函数,可以使得信号在截断处的变化更加平滑,减小由加矩形窗引起的截断效应,从而减少由频谱泄漏。
在 Matlab 中实现语音加窗处理:
#汉明窗
window = hamming(frame_length);
frames_windowed = frames .* window;
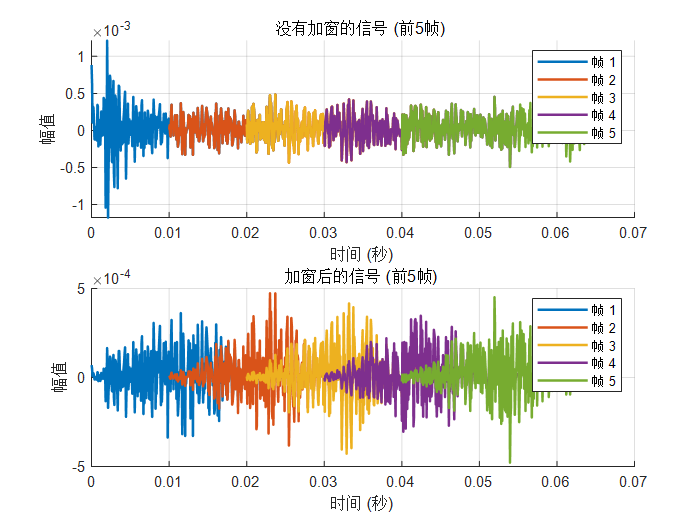
图7、分帧加窗结果
4、端点检测
语音预处理中的端点检测(Endpoint Detection, EPD)是指在语音信号中确定语音的有效部分(即语音活动区域)和无效部分(如静音或背景噪声)的过程。
短时能量(STE):即一帧语音信号的能量,语音信号的短时能量通常比静音段或噪声段大,可以用能量变化检测语音的起止点。
其中 x(n) 为第 n 帧的信号,N 为帧长。
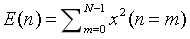
短时过零率(ZCR):过零率表示信号过零点的次数,语音段通常比噪声段的过零率低。特别是元音段过零率较低,而辅音段较高。
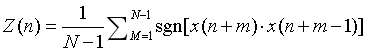
其中 sgn 表示符号函数。
- 高能量且低过零率:语音段(元音)。
- 高能量且高过零率:语音段(辅音)。
- 低能量且低过零率:静音段。
- 低能量且高过零率:噪声段。
当然还有很多方法比如:传统机器学习方法里面的 SVM 分类器,高斯混合模型(GMM),还有深度学习方法,利用神经网络对信号进行分类。
5、噪声抑制
实际采集到的音频通常会有一定强度的背景音,这些背景音一般是背景噪音,当背景噪音强度较大时,会对语音应用的效果产生明显的影响,比如语音识别率降低,端点检测灵敏度下降等,因此,在语音的前端处理中,进行噪声抑制也是是很有必要的。
谱减法(Spectral Subtraction):在频谱域中减去噪声频谱来抑制噪声,保留语音信号。
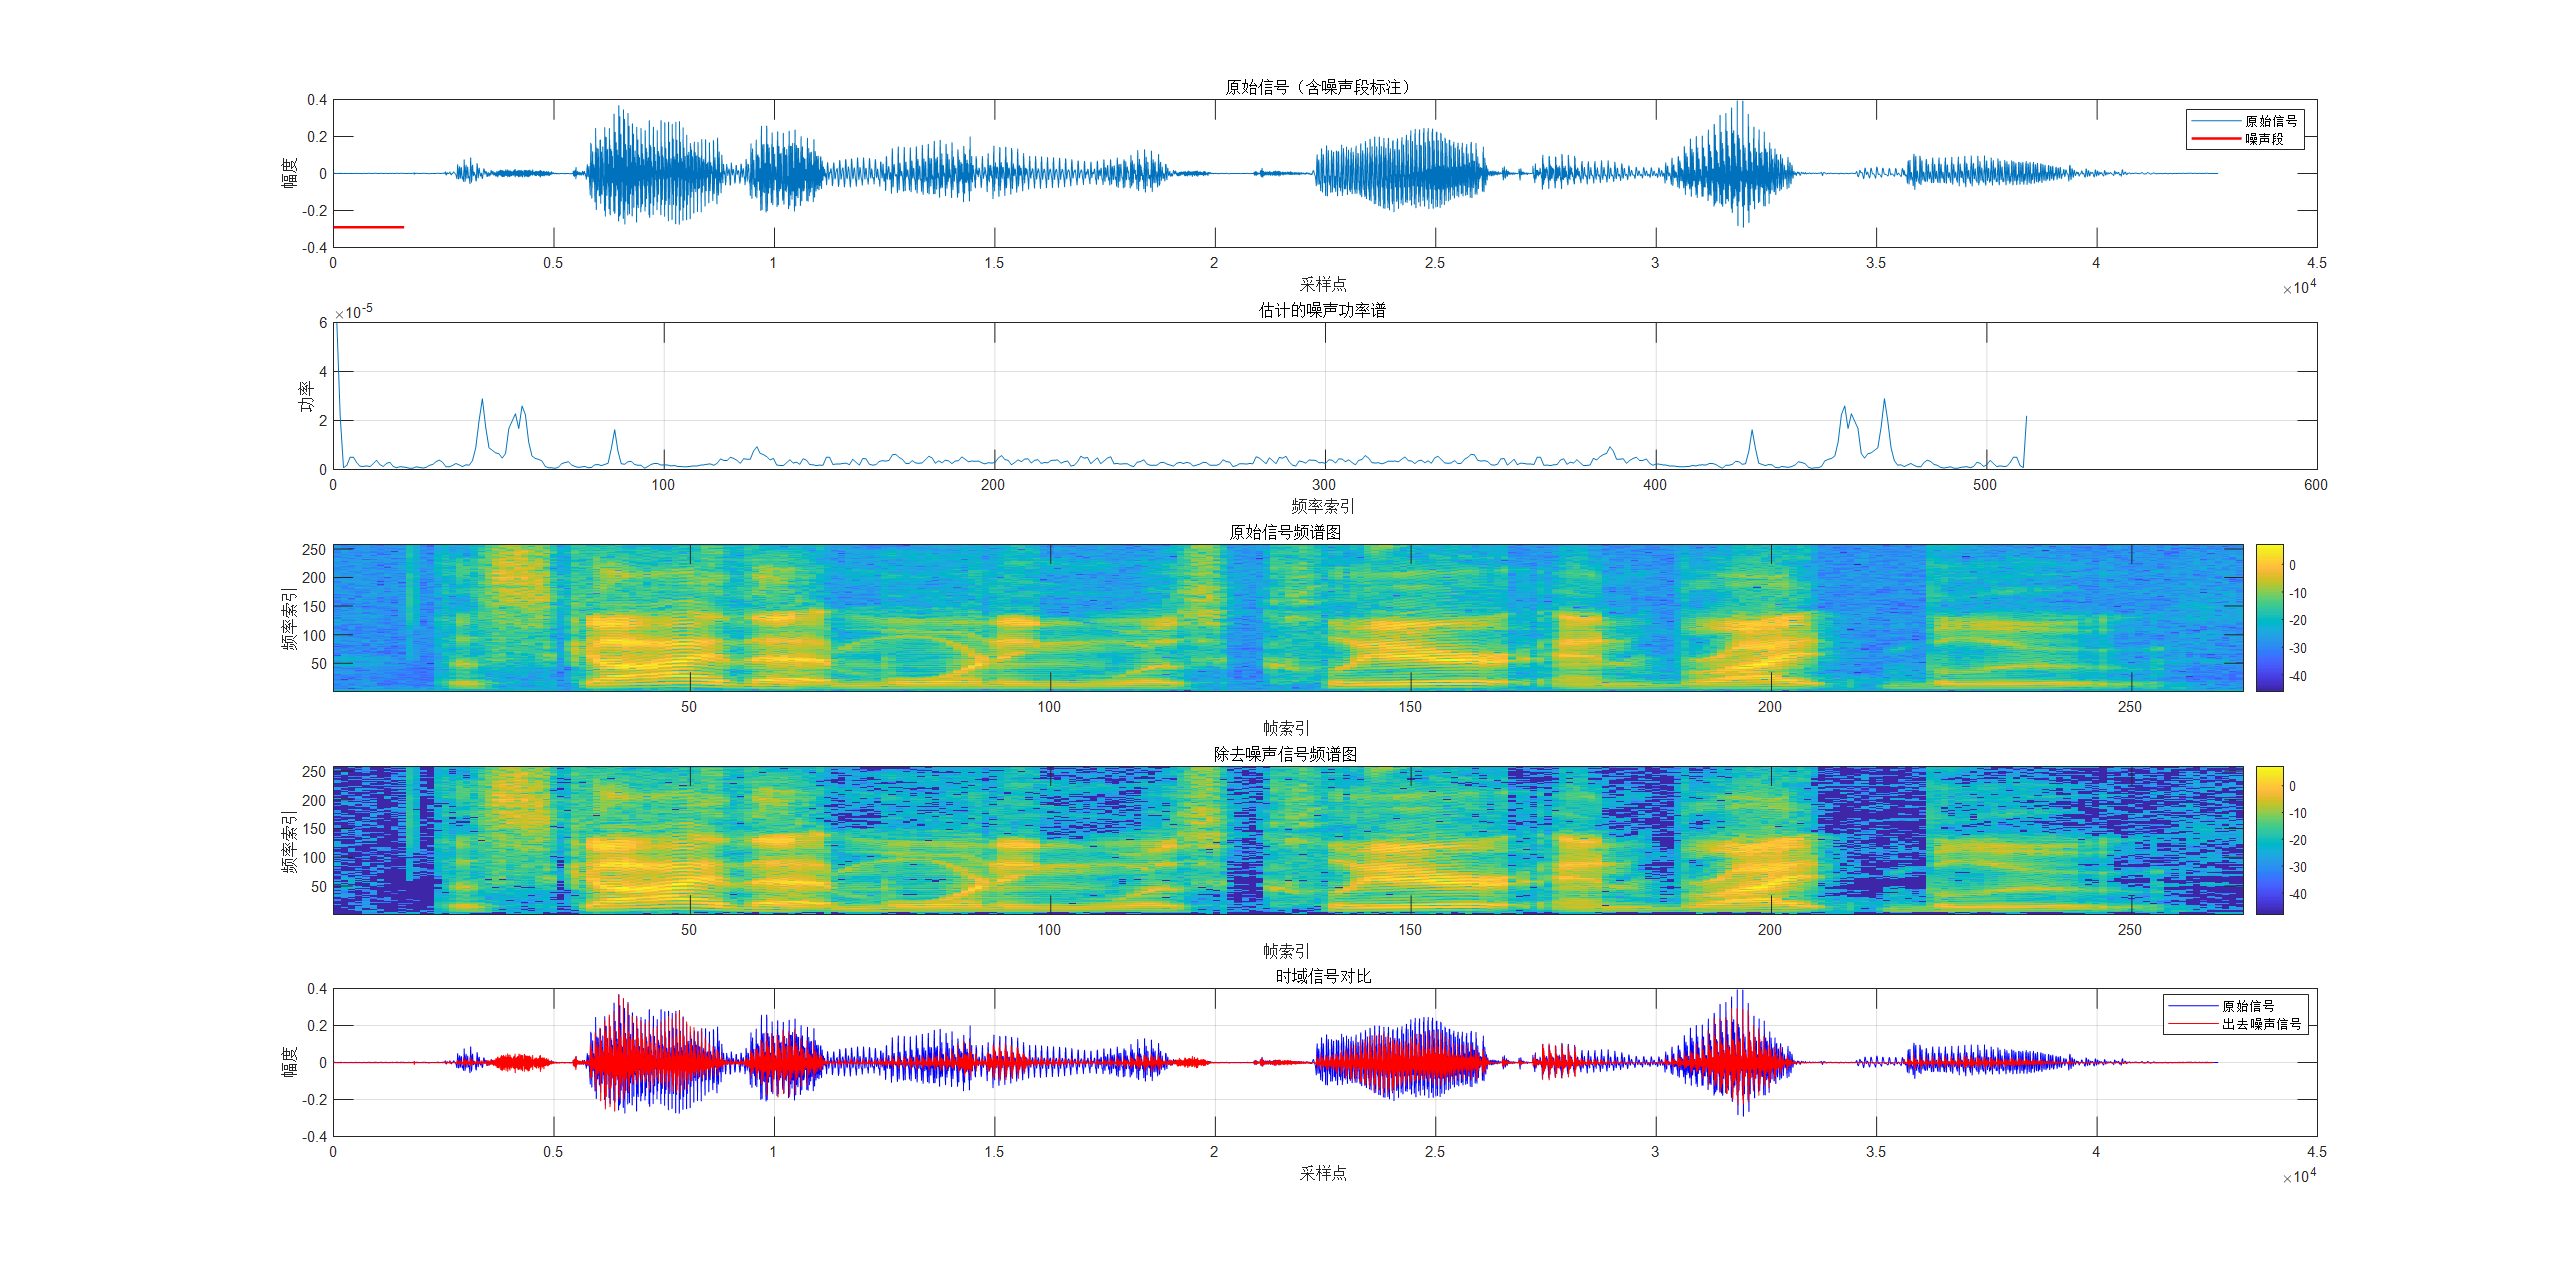
图8、谱减法噪声抑制全流程
其他的方法还有:滤波的方法,深度学习时频掩蔽的方法,还有特征空间通过特征级降噪,
二、特征提取
1、语谱图、
声音信号本是一维的时域信号,直观上很难看出频率变化规律。傅里叶变换可把它变到频域上,虽然可看出信号的频率分布,但是丢失了时域信息,无法看出频率分布随时间的变化。为了解决这个问题,很多时频分析手段应运而生,如短时傅里叶,小波,Wigner分布等都是常用的时频域分析方法。
语谱图:表示语音频谱随时间变化的图形,其纵轴为频率,横轴为时间,颜色的深浅表示能量的大小。
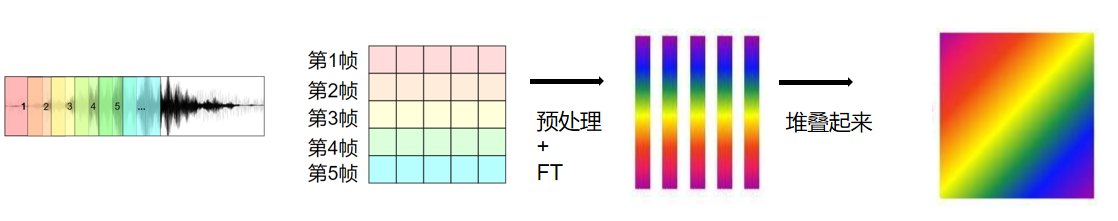
图9、语谱图
把一段长信号分帧、加窗,再对每一帧做傅里叶变换(FFT),最后把每一帧的结果沿另一个维度(频域)堆叠起来(旋转90度),得到类似于一幅图的二维信号形式。然后把这些幅度映射到一个灰度级表示
注意:帧长:使用较短的帧,其具有较宽的频带(宽带语谱图),较高的时间分辨率和较低的频率分辨率,而对于较长的帧,则具有较窄的频带(窄带语谱图),较低的时间分辨率和较高的频率分辨率
Matlab实现画语谱图:
#短时傅里叶变换 (STFT)
n_fft = max(512, frame_length); # 确保 n_fft >= frame_length
stft_frames = fft(frames_windowed, n_fft);
#计算功率谱
power_spectrum = abs(stft_frames(1:n_fft/2+1, :)).^2; #只取正频率部分
#转换为对数幅度谱 (dB)
log_power_spectrum = 10 * log10(power_spectrum + eps); #加 eps 避免对数零值
# 绘制语谱图
time_axis = (0:num_frames-1) * frame_step / fs; #时间轴 (秒)
freq_axis = (0:n_fft/2) * fs / n_fft; #频率轴 (Hz)
功率谱:幅度谱 只反映了信号的幅度信息,而 功率谱(幅度谱的平方)反映了信号的能量分布。对数幅度谱 :人类耳朵对声音的感知是 对数感知 的,意思是我们听到的声音强度变化并不与声音强度的绝对值呈线性关系,而是与声音强度的对数成比例。低强度的声音和高强度的声音会更加接近人耳的感知,从而使得特征提取和模型训练更加有效。
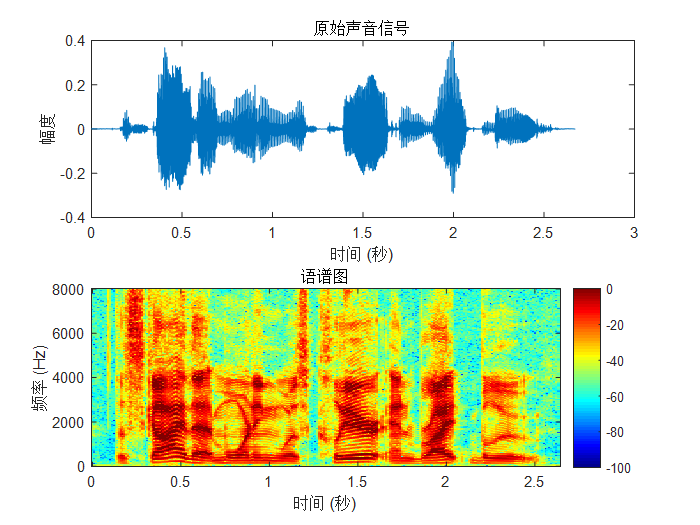
图10、真实语音的语谱图
语谱图的本质就是确定不同说话人声音的本性。横坐标为时间,纵坐标为频率。图中的条纹称之为“声纹”,它因人而异,即可利用声纹鉴别不同的说话人。
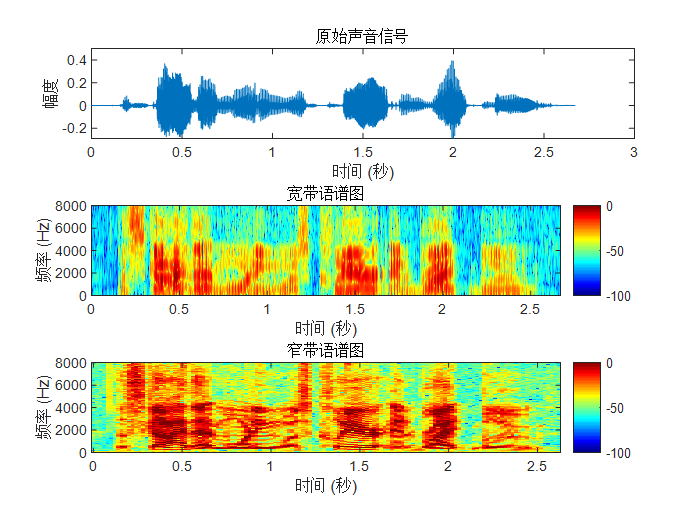
图11、一宽一窄语谱图
分别展示了一条语音句子的窄带语谱图和宽带语谱图。短时窗长度分别是50ms和2ms。
宽带:都是竖纹,时间分辨率高。
窄带:都是横纹,频率分辨率高。
横纹是与时间轴平行的几条深色带纹,它们相应于短时谱中的几个凸点,也就是共振峰
竖纹,是与时间轴垂直的一条条,每个竖直条相当于一个基音,条纹的起点相当于声门脉冲的起点,条纹之间的距离代表基音周期,条纹越密说明基音频率越高。
2、梅尔倒谱
人耳对频率的感知是非线性的。低频部分(例如20 Hz 到 1000 Hz)我们能够更加敏感地感知频率差异,而在高频部分(如1000 Hz 到 10000 Hz)我们对频率变化的敏感度则会逐渐下降。
梅尔尺度通过对数变换来模拟这种感知特性,它能更好地模拟人耳对频率的感知方式,将频率转换到一个对人耳来说更自然的尺度。从而提高语音识别和语音分析的效果。
梅尔尺度的计算公式为:
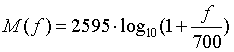
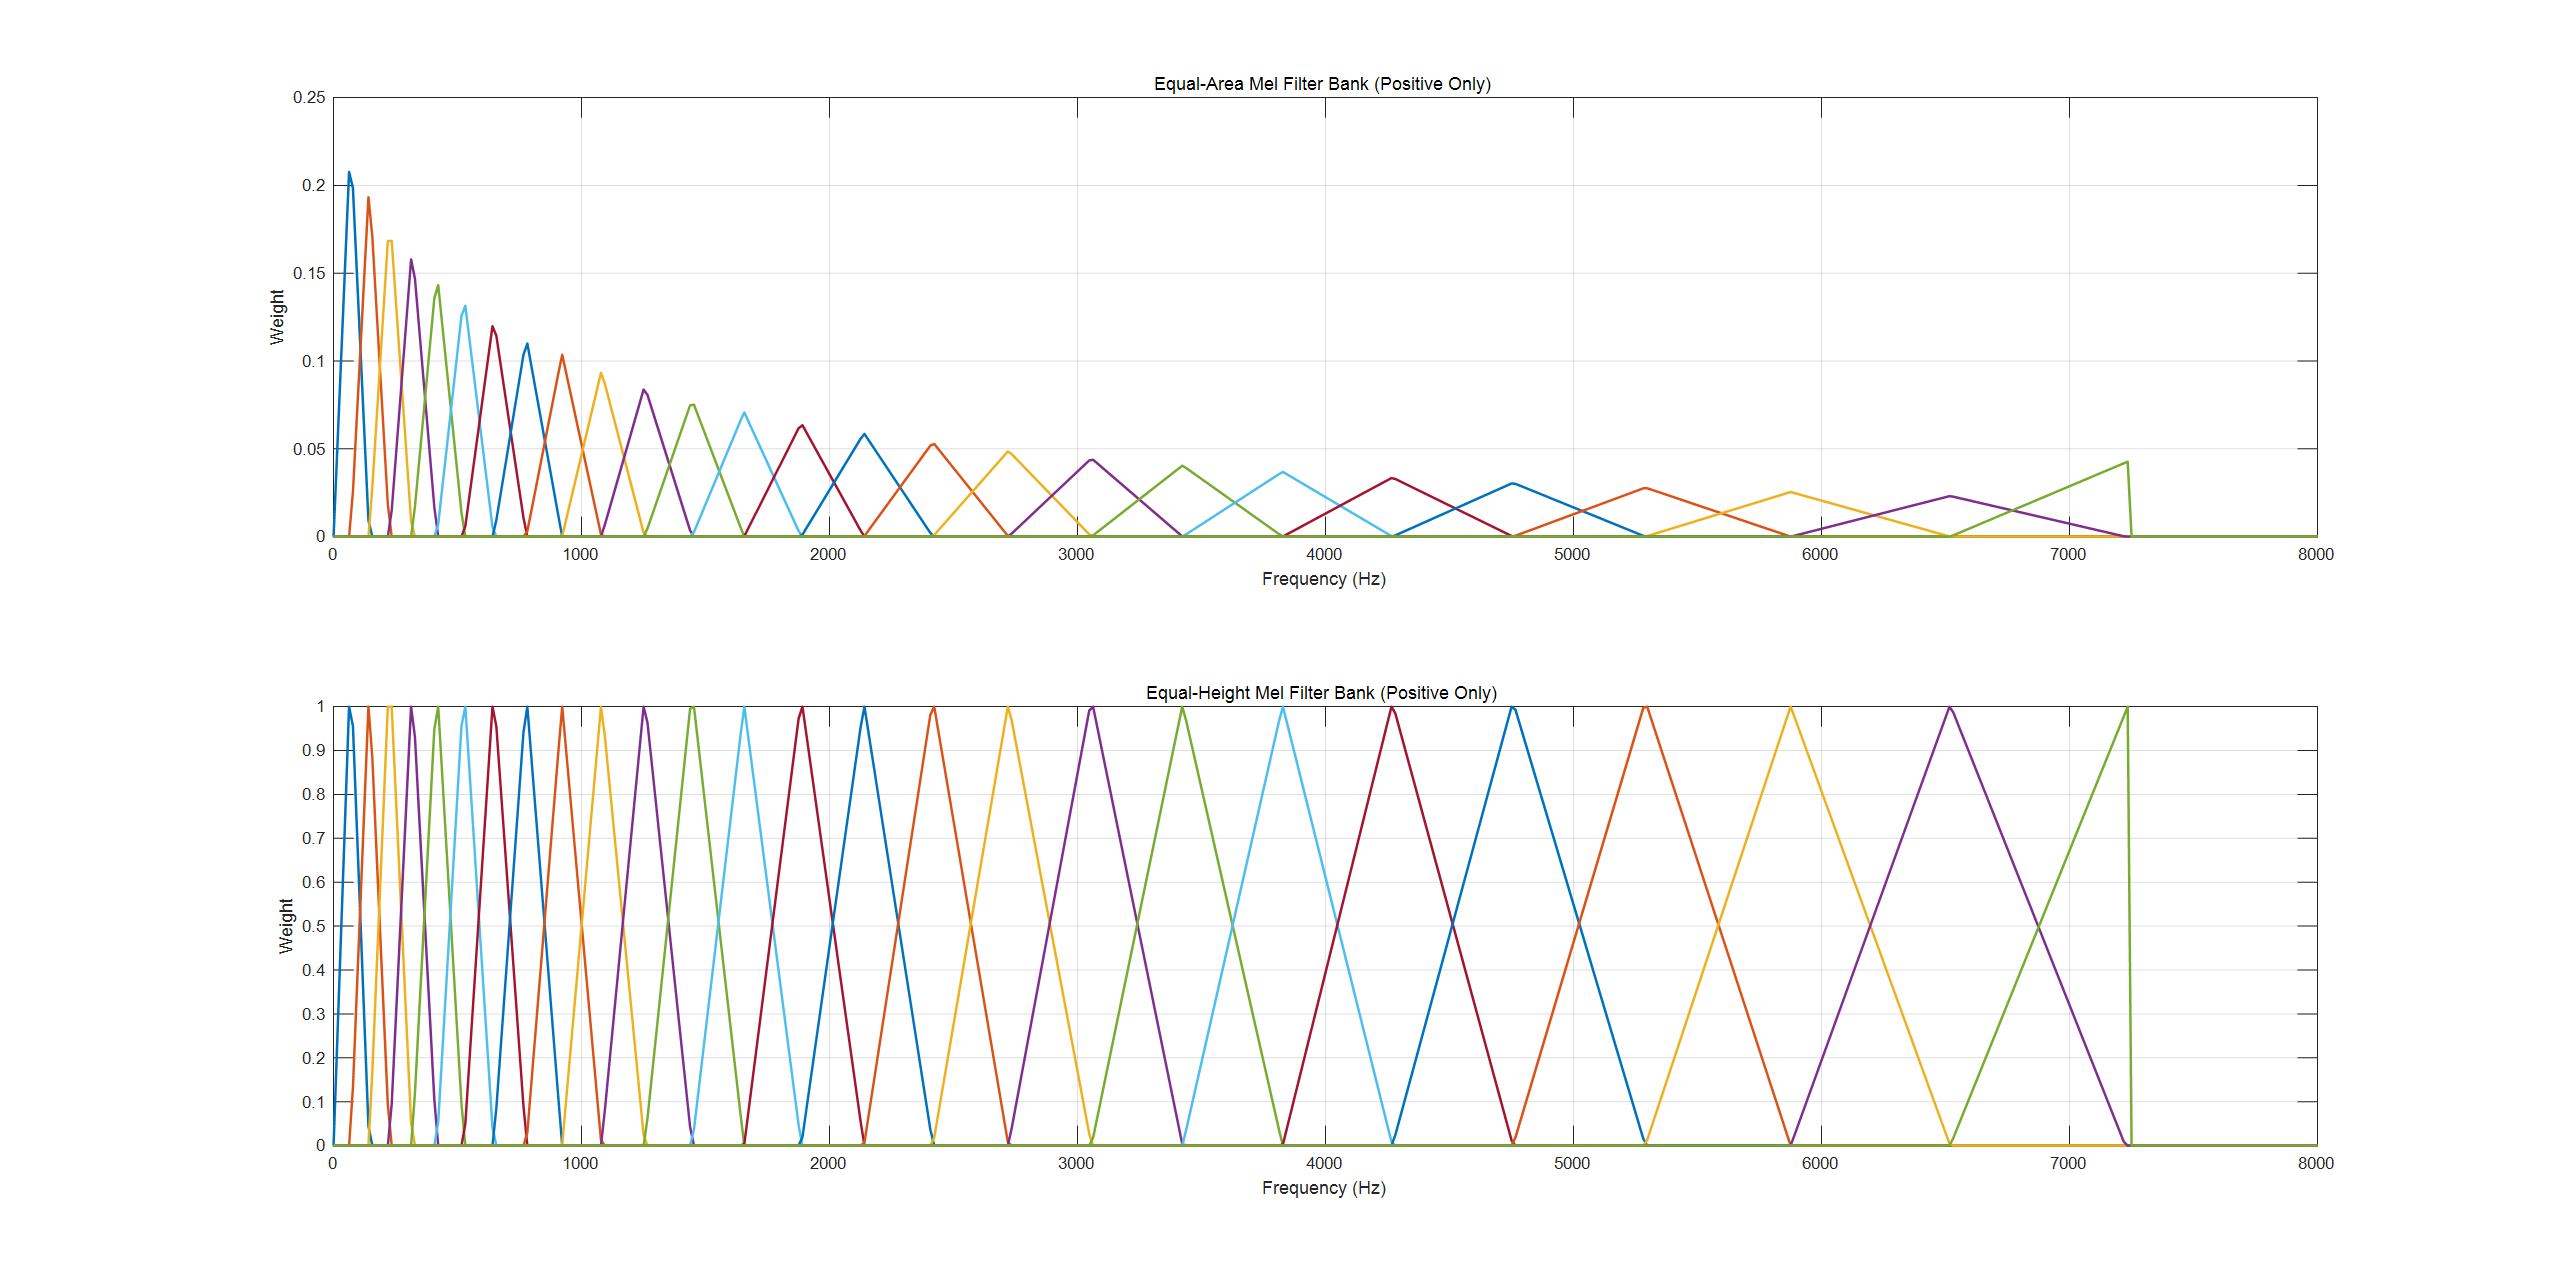
图12、等高梅尔频谱图和等面积梅尔频谱图
上图是HZ到Mel的映射关系图,可以看到二者为log关系,在频率较低时,Mel随HZ变化较快;当频率较高时,曲线斜率小,变化缓慢。
梅尔滤波器组就是将线性频谱转换到梅尔尺度的工具,如上右图,分为等高梅尔频谱图(适用于非人声领域)和等面积梅尔频谱图(适用于人声领域)。
将刚才得到频谱通过梅尔标度滤波器组(mel-scale filter banks),就可以变换为梅尔频谱。
#计算功率谱图
S = abs(spectrogram(y_preemphasized, window, frame_length – hop_length, n_fft, fs)).^2;
#生成梅尔滤波器组
mel_filter_bank = melFilterBank(n_mels, n_fft, fs);
#应用梅尔滤波器到功率谱图
mel_spec = mel_filter_bank * S;
#转换为dB
mel_spec_db = 10 * log10(mel_spec + eps);
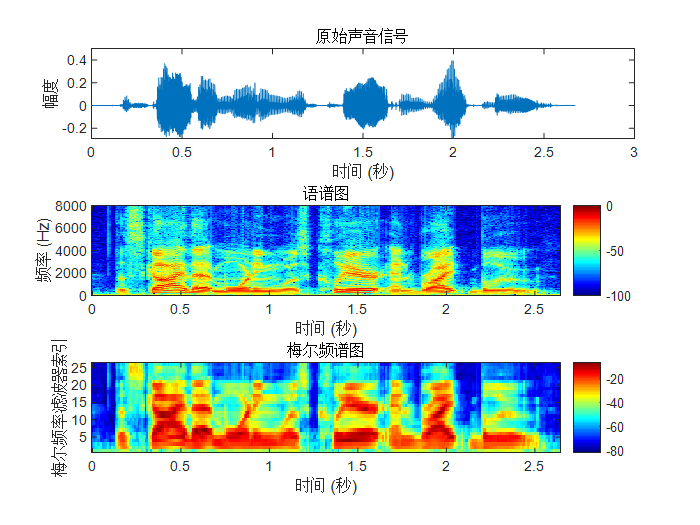
图13、原始语音和语谱图对应的梅尔频谱图
3、梅尔倒谱系数
梅尔倒谱系数(Mel-scale Frequency Cepstral Coefficients,简称MFCC)是在Mel标度频率域提取出来的倒谱参数。
倒谱(cepsrum):倒谱一词是频谱spectrum英文的前四个单词倒过来写而构成的。就是一种信号的傅里叶变换经对数运算后再进行傅里叶反变换得到的谱。
计算过程:
将原语音信号经过傅里叶变换得到频谱,语音看作是声源激励 e[k] 和声道系统 h[k] 的卷积结果
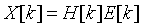
两边取对数

再求逆傅里叶变换

此时的x[k]实际上就是倒谱Cepstrum,h[k] 是低阶倒谱系数,代表语音信号的频谱包络。它与语音信号的声道特性(如共振峰或声道的滤波作用)相关。e[k] 是高阶倒谱系数,代表语音信号的激励成分。它与声带振动或激励信号特性相关。最后逆变换得到的倒谱图,横坐标为倒频率(频率的倒数,单位是秒),纵坐标是振幅。
对梅尔谱做log处理并做DCT离散余弦变换,保留的余弦系数就是梅尔倒谱系数(MFCC)
# 对数处理
mel_spec_db = 10 * log10(mel_spec + eps);
# 计算梅尔倒谱系数 (MFCC)
num_mfcc = 13; # 通常取前13个倒谱系数
mfcc = dct(mel_spec_db); # 对梅尔谱进行离散余弦变换(DCT)
# 取前13个余弦系数
mfcc = mfcc(1:num_mfcc, :);

图14、梅尔频谱图及其对应的梅尔倒谱系数
梅尔倒谱系数的主要作用是:特征表示:它们是音频信号的特征表示,可以用于后续的语音识别、音频分类、情感分析等任务。数据压缩:通过使用较少的低频倒谱系数(通常只取前12-13个系数),我们可以有效地表示大部分音频信息,减少数据的维度。去噪和增强识别性能:高频的梅尔倒谱系数通常包含了噪声或细节,通过去除这些高频系数,可以帮助提高识别系统的鲁棒性和性能。
三、实验结果
python实现语音的预处理和特征提取:语谱图,梅尔语谱图,MFCC,MFCC特征矩阵

图15、python得到的语谱图

图16、python得到的梅尔语谱图

图17、mfcc

图18、MFCC特征矩阵
四、总结
语音预处理是一系列操作,用于将原始语音信号转化为适合后续处理的特征形式。这些操作帮助提升信号质量,降低噪声干扰,增强语音信号的显著特征,从而提高语音处理系统(如识别或合成)的性能。
预加重:语音信号中高频分量较弱,且低频分量可能包含更多环境噪声。通过高通滤波器增强高频分量,平衡频谱分布,使高频特征更加突出,有利于后续的频域分析。
分帧:语音信号是一种非平稳信号,但在短时间内可认为是平稳的(通常为 20-40ms)。将连续语音信号分成多个短时帧,便于后续分析语音信号的短时特性,如功率、频谱等。
加窗:分帧过程中,信号在边界处会出现频谱泄漏现象。通过加窗抑制边界效应,突出帧中心的重要性。
端点检测:语音信号中可能包含大量非语音段(如静音或背景噪声),这些部分对处理无意义或有害。通过能量、过零率等特征提取语音的有效部分,去除非语音段,提高计算效率。
语谱图:直接分析语音的频域特性,可以捕获其随时间变化的频谱信息。展示语音信号在时间和频率域的分布,直观地呈现频率特征。
梅尔语谱图:人耳对不同频率的感知是非线性的,高频分辨率较低,低频分辨率较高。将频率轴转换为 Mel 轴,模拟人耳听觉特性,使特征更符合感知规律。
梅尔频率倒谱系数:语谱图或梅尔语谱图中的信息可能冗余,不利于机器学习模型处理。通过离散余弦变换(DCT)将梅尔语谱图压缩为低维倒谱特征,保留主要信息,去除高频变化。
特征矩阵:语音特征需以矩阵形式输入到后续模型中。将不同特征(如能量、MFCC 等)按时间帧组织成二维矩阵,便于处理。



评论前必须登录!
注册