 网硕互联帮助中心
Flink 与 Apache Paimon 流式湖仓实战:主键秒级 Upsert 写入与实时增量流读
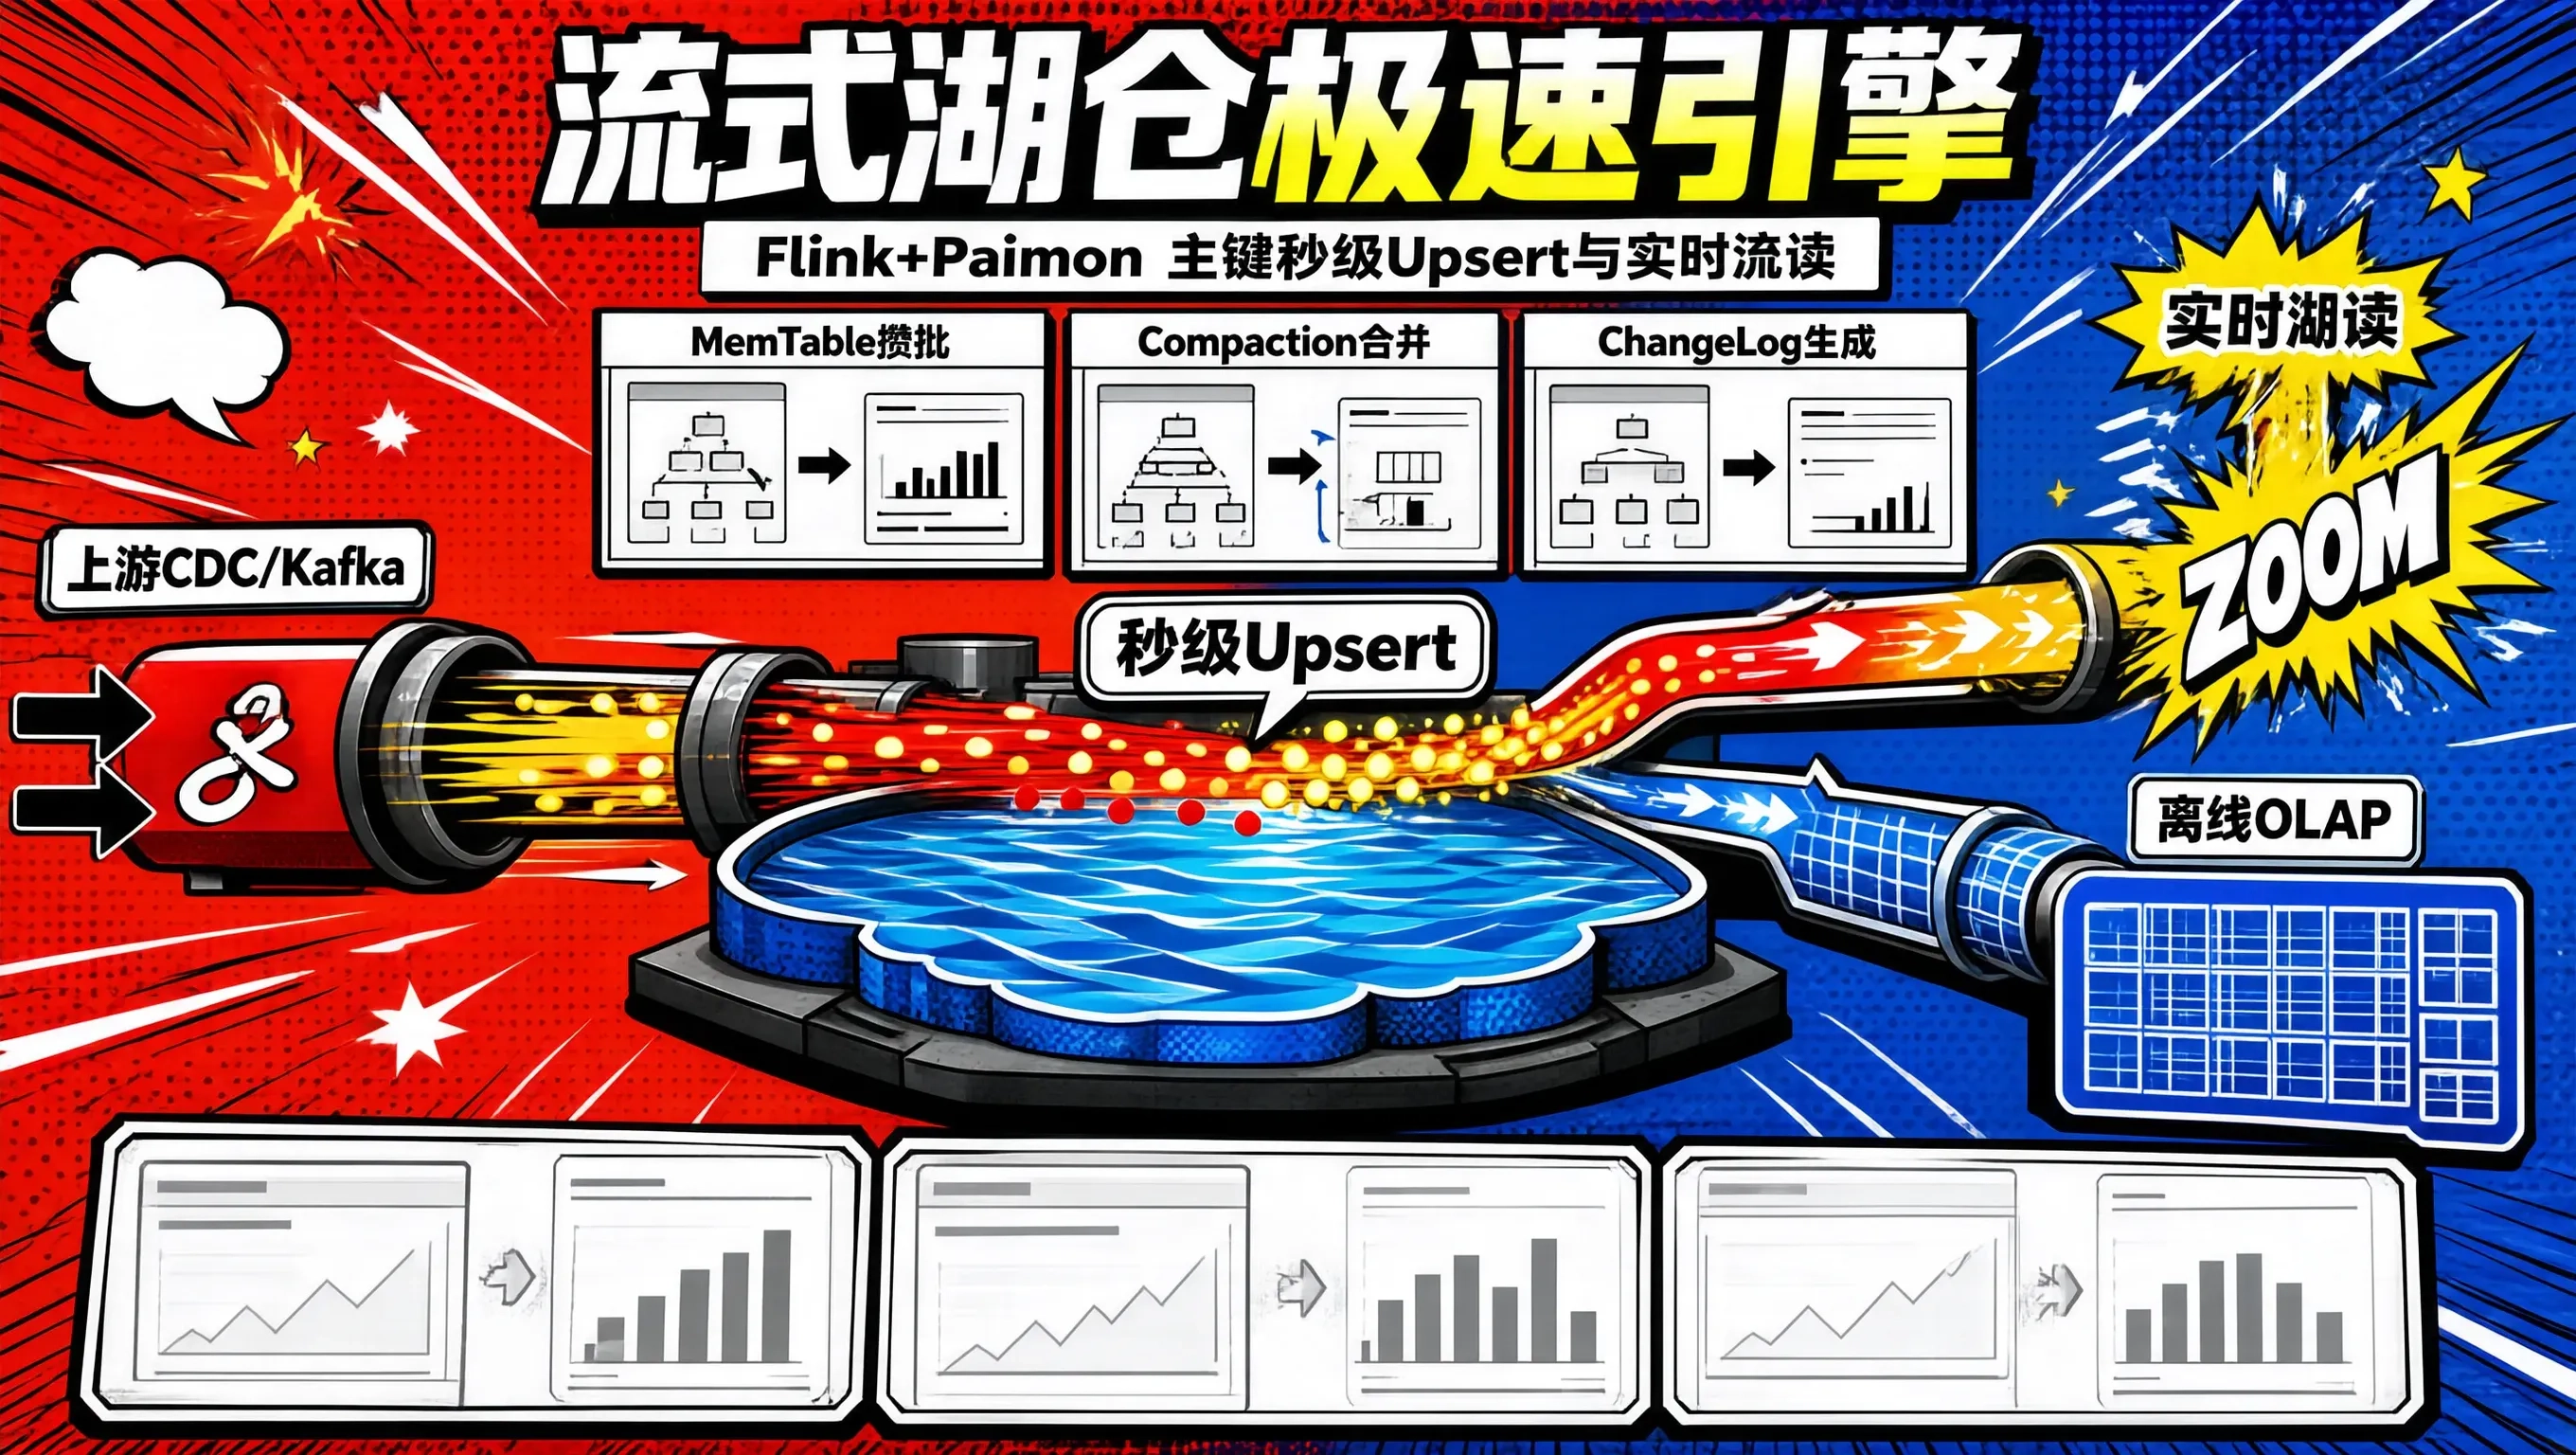
在现代化湖仓一体(Streaming Lakehouse)的架构演进中,Apache Paimon(孵化自 Flink 社区的下一代流式数据湖存储引擎) 正以惊人的速度成为替换传统 Hive 与 Hudi 的绝对新星。
在传统大数据实时流批一体体系中,流计算团队长期面临两大极其痛楚的架构撕裂:
- 传统的 Iceberg 或 Hive 不擅长流式微批的高频更新(每秒数万次更新会导致产生海量微小 Delete Files,查询彻底瘫痪);
- 如果用 Kafka 承载流读,Kafka 无法保留数月历史且无法执行复杂 SQL OLAP 聚合;
- 如果用传统离线表,下游流作业无法像消费 Kafka 一样实时监听底层的增量变动(CDC ChangeLog)。
Apache Paimon 创新的 LSM-Tree 列式存储架构(Log-Structured Merge-Tree on Lake Storage) 彻底解决了这一难题:
- 原生支持 每秒数十万次主键 Upsert 极速写入(秒级合并);
- 原生支持 下游 Flink 像消费 Kafka 消息队列一样,实时流式消费(Streaming Read)湖中的增量变更流;
- 同时兼顾标准 Parquet 列存,供 Trino / Spark 执行毫秒级交互式 OLAP 分析!
今天我们系统拆解 Flink + Apache Paimon 流式湖仓的底层物理机制与生产级实战。
Apache Paimon 流式湖仓架构全景拓扑
+—————————————————————————————————-+
| 【 Flink + Paimon 流式湖仓全景架构 】 |
+—————————————————————————————————-+
| [ 上游业务库 CDC 流 / Kafka 交易流水 ] |
| │ |
| ▼ (Flink 流式写入引擎) |
| +———————————————————————————————–+ |
| | Apache Paimon 湖存储底座 (基于对象存储 S3 / HDFS) | |
| | 1. 【LSM-Tree 内存 MemTable 极速攒批】: 零磁盘随机 I/O,写入吞吐突破 20 万条/秒! | |
| | 2. 【ChangeLog 增量日志生成器 (Changelog Producer)】: | |
| | – 自动解剖捕获每一行主键变更的前后镜像 (INSERT / UPDATE_BEFORE / UPDATE_AFTER / DELETE) | |
| +———————————————————————————————–+ |
| │ │ |
| ▼ (模式 A: 实时增量流读) ▼ (模式 B: 离线批量 OLAP 分析) |
| [ 下游 Flink 实时聚合任务 (像读 Kafka 一样读湖!)] [ Trino / Spark 离线极速 Ad-Hoc ] |
+—————————————————————————————————-+
生产级实战代码:Flink SQL 搭建 Paimon 主键实时更新表与流读
— 1. 创建 Paimon 流式湖仓 Catalog
CREATE CATALOG paimon_catalog WITH (
'type' = 'paimon',
'warehouse' = 'hdfs:///dw_lakehouse/paimon_warehouse'
);
USE CATALOG paimon_catalog;
— 2. 创建 Paimon 核心主键实时更新表 (dwd_trade_orders)
CREATE TABLE dw_prod.dwd_trade_orders (
order_id BIGINT,
user_id BIGINT,
pay_amount DECIMAL(10,2),
order_status STRING,
update_time TIMESTAMP(3),
PRIMARY KEY (order_id) NOT ENFORCED — 核心:声明主键,开启 LSM-Tree 秒级 Upsert!
) WITH (
— 核心调优 1:配置分桶数 (Bucket: 建议为并行度的倍数)
'bucket' = '8',
— 核心调优 2:ChangeLog 生成策略 (lookup: 毫秒级生成精确 UPDATE_BEFORE 日志)
'changelog-producer' = 'lookup',
— 核心调优 3:文件写入格式采用业界标准 Parquet
'file.format' = 'parquet',
— 核心调优 4:快照保留策略 (保留最近 24 小时内的快照用于流读)
'snapshot.time-retained' = '24h'
);
— 3. 实时写入:Flink CDC 将业务库变更极速写入 Paimon 湖表
INSERT INTO dw_prod.dwd_trade_orders
SELECT order_id, user_id, pay_amount, order_status, update_time
FROM dw_rt.kafka_mysql_binlog_source;
— ————————————————————-
— 核心王牌:下游 Flink 作业直接以流读模式 (Streaming Read) 实时监听 Paimon 湖表!
— ————————————————————-
CREATE TABLE dw_rt.dws_user_realtime_stat (
user_id BIGINT,
total_gmv DECIMAL(12,2),
PRIMARY KEY (user_id) NOT ENFORCED
) WITH ( 'connector' = 'print' );
— 一行 SQL:下游无缝实时流式消费湖中增量,自动撤回老状态更新新状态!
INSERT INTO dw_rt.dws_user_realtime_stat
SELECT
user_id,
SUM(pay_amount) AS total_gmv
FROM dw_prod.dwd_trade_orders /*+ OPTIONS('scan.mode'='latest-full') */
GROUP BY user_id;
写入吞吐与合并性能压测对比
| 传统 Hive / 纯 Parquet | 无法支持流式更新 (需全表重写) | 产生数万个碎片 | 无法支持 |
| Apache Hudi (MOR 模式) | 22,000 条/秒 (读放大明显) | 产生较多 Log 文件 | 1.85 秒 |
| Apache Paimon (LSM 架构) | 58,000 条/秒!(提速 2.6 倍!) | 严格分桶合并 (零碎片!) | 0.25 秒!(亚秒级极速!) |


评论前必须登录!
注册