 网硕互联帮助中心
目录
一、 底座选型:知识存储与索引层
二关键点
三RAGFLOW
哲学思考
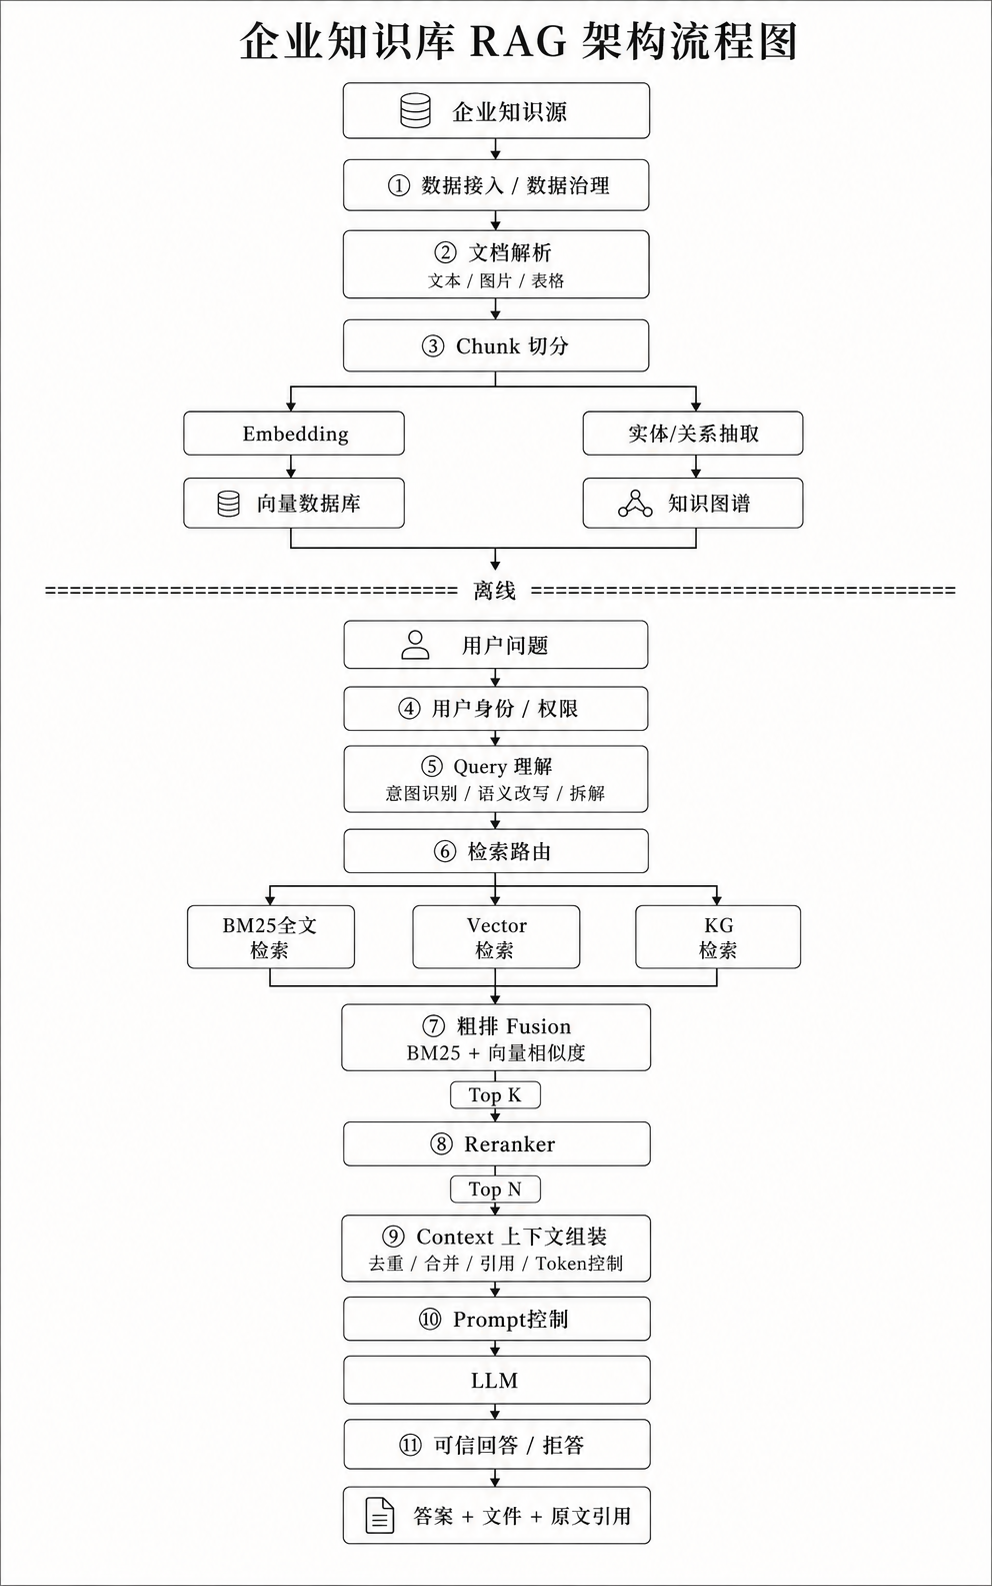
一、 底座选型:知识存储与索引层
1.原始文档存储
保存:
-
PDF
-
Word
-
Excel
-
PPT
-
图片
-
网页
-
邮件
-
制度文件
-
业务文档
原因很简单:向量数据库存的不是原始知识本身,而是知识的索引。最终 Show Quote、查看原文、权限校验,都需要找到原文件。
2.全文索引
用于BM25,比较典型:Elasticsearch/OpenSearch,属于关键词检索,例如:
西安市住房公积金提取管理办法第十五条是什么?
这里“十五条”“公积金”这些精确词,BM25 往往比纯向量更靠谱。
3.向量数据库
保存Chunk经过Embedding Model处理后的Vector,选型可以考虑:
|
Elasticsearch / OpenSearch |
BM25 + Vector 一体化,企业 RAG 很实用 |
|
Milvus |
专业向量数据库,大规模场景强 |
|
Qdrant |
简洁、性能不错 |
|
pgvector |
已经有 PostgreSQL 的企业非常方便 |
|
FAISS |
更偏算法库,不太适合作为完整企业数据库 |
如果你现在用 RAGFlow,其实 ES/OpenSearch 这种 Hybrid Search 架构就比较自然。
4.知识图谱(当前没加,主要作用是非关系性数据)
二关键点
权限、文档版本管理、Context Builder(Ranker后的块去重、合并等处理工作)、Ranker置信度、引用Citation、评测体系 这六个东西是上线标准
1.知识库和OA系统考虑增量同步
2.文档解析:文本 / 图片 / 表格必须分开处理
①文本
②图片
③表格
3.Chunk 切分:结构优先+Token 长度限制
Chunk Metadata 至少保存:
document_id
file_name
page
chapter
section
chunk_id
version
department
permission
created_at
updated_at
4.权限管理【重要】
5.Query 输入处理
①多轮上下文问题补全
②问题重写/扩写
③意图识别
├─普通聊天
├─知识库问答
├─数据查询(当前没加,Text2Sql)
├─知识图谱查询(当前没加)
└─无法识别
④查询分解(当前没加)
6.Prompt 层
内容包括四部分
System Prompt
+
RAG Context
+
Conversation历史对话
+
User Query
主要针对System Prompt的规定
① Empty Response:查不到就说不知道
② 强制 Citation:输出的内容必须根据检索到的知识回答,必须带引用文件及块内容
③ 知识冲突处理:都展示出来,分别给出引用,让用户判断
7.Prompt Injection 防护:检索到的内容只作为数据,不能覆盖 System Prompt,作为指令。
8.评测系统:收集100条文本对,测试指标Recall@K等
三RAGFLOW
当前就用了粗排,加了Ranker效果还不好,速度还比较慢
1.组件和角色
|
Elasticsearch / OpenSearch |
Chunk 文本、BM25 倒排索引、Embedding 向量、向量索引、检索相关字段 |
知识检索库 |
|
MySQL |
用户、知识库、文档记录、配置、任务状态、模型配置等结构化业务数据 |
业务/元数据库 |
|
Redis |
文档解析、Embedding 等异步任务的消息队列/任务协调 |
消息队列 |
|
MinIO |
上传的 PDF、Word、Excel、PPT、图片等原始文件 |
原始文件存储 |
注:MinIO 保存的是真正的原始文件;Elasticsearch 保存的是从 PDF 里解析出来的chunk块
2.上传文件流程解析
用户上传 PDF
│
├──────────────→ MinIO
│ 保存原始 PDF 文件
│
│
└──────────────→ MySQL
保存文档记录
document_id
文件名
所属知识库
上传人
解析状态
Parser配置
等……
│
↓
Redis
创建“解析文档”任务
│
↓
RAGFlow Worker
│
解析 PDF / OCR
│
切 Chunk
│
┌─────────┴────────┐
↓ ↓
Chunk文字 Embedding模型
│ │
│ Vector
│ │
└─────────┬─────────┘
↓
Elasticsearch / OpenSearch
│
┌─────────┴─────────┐
↓ ↓
BM25倒排索引 向量索引
│ │
Chunk文字 Vector
3.组件架构图:RAGFlow 存储层
┌──────────────────MySQL──────────────────┐
│ 系统元数据 / 用户 / 知识库 / 文档配置
│ 文档状态 / 模型配置
├─────────────────MinIO────────────────────┤
│ PDF / Word / Excel / PPT / 图片原始文件
├─────────────────Elasticsearch / OpenSearch──────┤
│ Chunk文本 ──────→ BM25倒排索引
│ Embedding Vector ─→ Vector Index
├───────────────────Redis───────────────────┤
│ 消息队列 / 文档解析任务 / Task Executor
└──────────────────────────────────────────┘
4.切块逻辑:图和表格怎么处理保存的(使用的DeepDOC PDF解析策略)
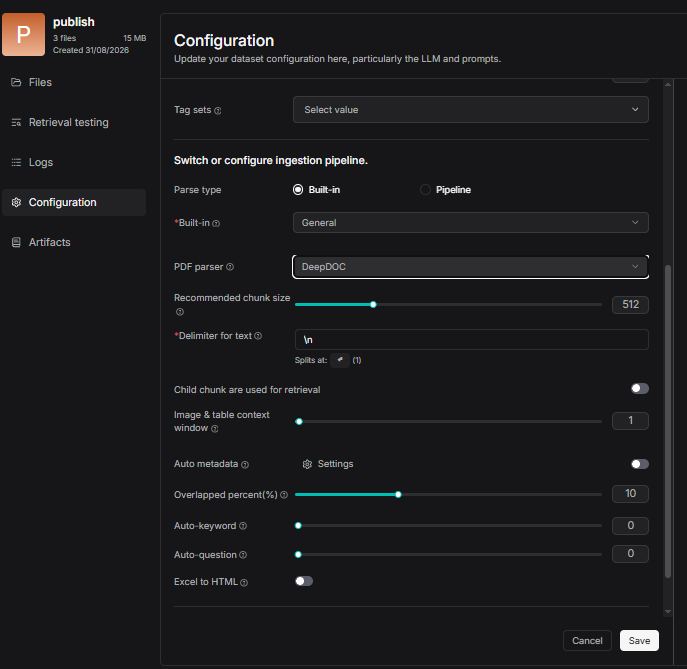
|
Text |
正文段落 |
原文文本 |
文本 |
可能保存对应页面裁剪图,用于定位/引用 |
|
Table |
表格 HTML + 表格裁剪图 |
HTML表格 |
去掉 <table><tr><td>… 标签后的文字 |
裁剪图单独存对象存储 |
|
Image/Figure |
图片裁剪 + 图注/文字,VLM可增强 |
图注/描述文字 |
描述文字 |
原图/裁剪图单独存对象存储 |
5.RagFlow粗排和精排的切分逻辑
——————————————-常规逻辑——————————————-
粗排:BM2.5关键字和向量相似度结合筛选
精排:Rnaker的置信度,一般设置0.6这样
——————————————-RagFlow最终计算逻辑—————————————-
①Similarity threshold 一值两用
Similarity threshold 会被用于两个阶段: -Dense/Embedding 候选召回阶段:作为向量 cosine similarity 的检索门槛; -最终结果阶段:作为最终 Hybrid Similarity 的过滤门槛。 注意:前者只作用于 Dense 检索分支,不代表所有候选必须先满足 Embedding threshold;全文检索分支也能贡献候选。
②RAGFlow 在不开 reranker时:final_score=(1-w) × Full-text+w ×Embedding值
配置:向量用Similarity threshold筛选,粗排计算完了的final_score用Similarity threshold筛选
Vector 权重:w=0.7;
Full-text权重:1-w=0.3;
Similarity threshold:0.25
步骤(筛选了两次):
1.计算文本值和向量值,先单纯用Embedding Vector筛选一堆块,筛选值是Similarity threshold
2.对筛选出来的块计算最终分数:final_score=(1-w) ×Full-text+w ×Embedding值
3.最终值与Similarity threshold比较再筛选一波
③RAGFlow开启 reranker时:final_score=(1-w) ×Full-text+w × Reranker值
配置:向量用Similarity threshold筛选,计算完了的final_score用Similarity threshold筛选,
Vector :w=0.7;
Full-text:1-w=0.3;
Similarity threshold:0.25
步骤(筛选了两次):
1.计算文本值和向量值,先单纯用Embedding Vector筛选一堆块,筛选值是Similarity threshold
2.将筛选的N个块送入Rnaker模型,计算Rnaker值
3.对这M个块用文本值和Ranker值计算分数:final_score=(1-w) ×Full-text+w × Reranker值
4.最终值与Similarity threshold比较再筛选一波
6.Embedding模型和Ranker模型的部署方式(自己用的是Xinference,之前YOLO检测需要用一个VLM模型,部署了一个gguf的4B模型,用的是llama.cpp)
-如果是 HuggingFace/Transformers 格式,就优先用 vLLM(linux部署,在windows上需要WSL2) 或 Xinference/TEI (直接windows上部署,也支持通过走llama.cpp 后端部署 GGUF)暴露 embedding API;
-如果是 GGUF(.gguf格式) 才更像走 llama.cpp/Ollama。
哲学思考
“知识被切成碎片,信任却要靠完整的证据链。”
——当原始文档保留知识的出处,Chunk切分决定语义的边界,混合检索从关键词与向量中寻找线索,重排与上下文组装便承担起筛选证据的责任;权限限定谁能看见,版本说明何时有效,引用让每一次回答都能回到原文,拒答则为证据不足留下诚实的位置。企业知识库的成熟,体现在每一句结论都能被追溯、被质疑、被修正。把文件接入模型,只完成了信息的搬运;让检索、判断与验证彼此衔接,知识才获得反复参与决策的条件。可信的智能,始于对证据边界的认真维护。


评论前必须登录!
注册