 网硕互联帮助中心
摘要
通用大模型的能力边界在持续外扩,但一个反直觉的现象正在出现:在最专业的领域里,通用模型反而不如专用模型好用。9 月中旬 OpenAI 推出面向生命科学研究的 GPT-Rosalind,并同步发布一组专用基准——在药物化学、基因组学与湿实验排障等任务上,它以更少的 token 消耗超过了自家通用旗舰。这件事的意义不止于一个新产品,而在于它验证了一条被长期争论的路线:当任务足够专业、评价标准足够明确时,垂直化仍有不可替代的价值。2026 奇点智能技术大会(11 月 20-21 日 · 北京万达文华酒店)"AI+行业应用实践"专题将讨论同一命题。本文拆解垂域模型为何有效、专用基准该如何设计,以及它在工程上真正需要满足的条件。
一、一条反直觉的数据
这次发布里最值得注意的不是"又出了一个模型",而是一组对比数据的形态:在药物化学基准 MedChemBench 上,专用模型取得 27.5% 的成绩,高于通用旗舰的 25.1%,同时 token 消耗反而减少 7.2%;在基因组学的长程分析基准 GeneBench 上,准确率 21.6% 对 20.4%,token 消耗减少 31%;在湿实验基准 LabWorkBench 上,63.2% 对 55.8%,token 再省 5.3%。
常见直觉:能力更强 = 消耗更多资源
实际数据:专用化后 能力↑ + 消耗↓(三项基准同时成立)
这三个数字同时指向同一个结论:专业化的收益不是靠堆算力换来的,而是靠"少走弯路"换来的。模型不再需要在无关的通用知识上分散注意力,也不必在通用对齐约束下反复自我纠正,因此同一任务下路径更短。
这一点对工程实践有直接意义。很多团队在评估模型时的默认假设是"更强必然更贵",于是把成本与质量当成一对必须取舍的矛盾。而这条数据说明:当模型与任务足够匹配时,两者可以同时改善。真正需要优化的或许不是模型强度,而是匹配度。
二、为什么垂域模型仍然有效
一个自然的疑问是:如果通用模型持续变强,专用模型会不会被自然淘汰?从这次的实践看,至少有三层原因是通用化难以覆盖的。
其一是评价标准的差异。 通用基准衡量的是"能不能给出看起来合理的答案",而专业领域衡量的是"结论能不能支撑真实决策"。在药物发现里,一个结构式画错、一个 SAR 判断偏差,下游的实验投入就会被浪费。这类错误的代价分布与通用问答完全不同。
其二是工作流的差异。 专业任务通常是长链条的:检索证据、设计实验、质控、建模、修正、得出结论。通用模型擅长单步回答,但在长链条任务上容易出现"中间某步悄悄偏离却无人发现"。专用模型可以针对整条链路做训练,而不是只优化单轮输出。
其三是数据分布的差异。 专业领域的有效信息大量存在于论文图表、实验记录、 proprietary 数据库里,这些数据在通用语料中占比极低。垂直训练让模型真正"见过"这类数据的形态——包括它的噪声模式与缺失方式。
| 评价标准 | 答案合理性 | 决策可用性 |
| 任务形态 | 单步问答 | 长链条工作流 |
| 数据来源 | 公开语料 | 专业数据与私有库 |
| 优化目标 | 广覆盖 | 单领域纵深 |
三、专用基准:比模型更难的部分
这次发布里最容易被忽略、但对行业最有参考价值的,其实不是模型本身,而是那一组基准的设计思路:LifeSciBench 覆盖证据处理、分析、设计与优化、科学推理、验证与运维、转化与科学沟通六个工作流环节,由外部专家评判,而不是自动打分。
这回应了一个长期困扰 AI 落地的问题:通用榜单分数与真实价值之间的脱节。当模型在 MMLU 一类榜单上刷分时,企业很难判断这对自己意味着什么;而当基准直接取自真实工作流、由领域专家评判时,分数才第一次具备了决策意义。
设计这类基准有三条值得借鉴的原则:
第三条尤其关键。当公开基准被广泛训练进模型之后,分数的可信度会自然衰减——防泄漏不是学术洁癖,而是维持基准生命力的前提。
四、工程化的四个前提条件
垂域模型听起来诱人,但落地并不容易。从工程角度看,至少要满足四个条件才能真正产生价值。
第一,任务边界必须清晰。 垂域化的收益来自聚焦,若任务范围模糊,专用模型会退化为"通用模型的弱化版"。因此第一步往往不是训练,而是把业务中的高频任务枚举清楚。
第二,必须有可判定的评价标准。 没有明确的好坏定义,就无法构造训练信号,也无法验证效果。很多团队卡在这一步——他们有数据,但没有标签;有专家,但没有把专家判断结构化的机制。
第三,工作流要能被拆解。 长链条任务必须能拆成可观测的中间步骤,否则出错时无法定位。这也意味着垂域化往往伴随一次流程重构,而不只是模型替换。
第四,要能接入专有数据。 若专业数据无法合规使用,垂域模型就失去了最核心的差异化来源。这涉及数据治理、权限与审计,通常是最耗时的一环。
# 垂域任务的评价闭环:把专家判断结构化
class DomainEval:
def __init__(self, workflow_steps, expert_rubric):
self.steps = workflow_steps # 可拆解的工作流步骤
self.rubric = expert_rubric # 专家评分细则
def run(self, task, model):
trace = model.execute(task, emit_trace=True)
step_scores = [self.rubric.score(s) for s in trace.steps]
return {
"final": self.rubric.score(trace.output),
"weakest_step": min(zip(self.steps, step_scores), key=lambda x: x[1]),
}
注意返回值里的 weakest_step:垂域优化的价值往往不在于提升总分,而在于定位最薄弱的那一环。这是通用基准无法给出的信息。
五、对国内团队的启示
这条路线对国内从业者有三点直接启示。
其一,不必在通用能力上硬碰硬。当通用旗舰的能力持续攀升时,追赶通用榜单的边际收益很低;而在专业领域里,纵深仍有大量空白。
其二,基准建设是被低估的竞争壁垒。谁先定义了某个行业的评价标准,谁就在事实上定义了这个行业的 AI 落地路径。这件事的门槛不在技术,而在能否组织起领域专家与真实工作流数据。
其三,垂域化是组织工程而非纯技术工程。它需要领域专家、数据治理、流程重构三者协同,单靠算法团队无法完成。这也解释了为什么很多垂域项目失败在组织协同而非模型能力。
六、垂域化的三步实施路径
如果一家机构决定走垂域路线,真正的难点不在选型,而在把"专业"这件事拆解成可执行的工程动作。可以拆成三步。
第一步:把任务拆到可评价的粒度。 很多团队一上来就问"要不要训一个行业大模型",这个问题太大。"辅助药物化学家做 SAR 分析"仍然不是一个可训练的任务,但"给定先导化合物与一组类似物,输出活性排序并给出判断依据"就是一个可训练、可评价的任务。判断标准很简单:能否在不依赖主观感受的前提下,判断一次输出是对是错。拆不细的垂域项目,最后都会退化成通用问答加一个行业词表。
第二步:选择知识注入的方式。 这是最容易被拍脑袋决定的一步,四种路径的代价差别很大:
| 继续预训练 | 术语体系、表述习惯、领域分布 | 算力成本高,需高质量语料治理 | 知识更新后模型不会自动跟上 |
| 监督微调 | 任务格式、输出规范、判断范式 | 需要大量专家标注 | 标注者之间标准不一致时直接崩 |
| 检索增强 | 易变事实、文档库、最新规范 | 检索质量决定上限 | 检索召回错了,生成再好也没用 |
| 工具调用 | 可计算、可查询的确定性能力 | 需要稳定的接口与错误处理 | 工具返回异常时模型编造结果 |
实践中往往是组合:术语与范式靠微调,事实靠检索,计算靠工具。把四类需求压到一条路径上,是垂域项目最常见的工程错误。
第三步:建立上线后的失效监控。 垂域模型最危险的不是答错,而是"答得流利但结论不可用"。建议在上线时就埋三类探针:一是输出是否落在领域受控词表内;二是关键数值是否可回溯到检索来源;三是专家抽样复核的比例与偏差趋势。没有第三项的垂域系统,通常会在运行半年后 quietly 退化,而没人发现。
七、垂域模型与通用模型如何共存
垂域化不等于"替换掉通用模型"。在真实系统里,两者更常见的关系是分层协作,而不是二选一。
一个可落地的分层方式是三层:上层用通用模型做任务理解与拆解,中层用垂域模型做专业判断,底层用工具与检索做事实校验。 上层的通用能力负责接住用户模糊的表达,中层的专业能力负责产出可交付的结论,底层负责把结论钉在可追溯的来源上。三层各自的失败模式不同,因此可以分别监控、分别替换。
这样分层的价值在于升级路径清晰:当通用模型换代时只换上层,当行业知识更新时只动检索库,当专业判断标准变化时重训中层。把三种变化耦合在同一个模型里,是很多垂域系统迭代困难的根源。
反过来说,如果一套系统里只有一个模型承担全部职责,那么任何一次升级都要重新验证所有场景,验证成本会随场景数量线性增长。这也是为什么"先训一个行业大模型"这种一步到位式的规划,在工程上往往不如"先搭编排层、再逐块替换"走得远。
八、衔接大会专题
11 月 20-21 日,北京万达文华酒店,2026 奇点智能技术大会。"AI+行业应用实践"专题聚焦金融、汽车、工业制造等行业的落地路径,讨论的正是同一组问题:行业专有模型与通用大模型如何协同、垂直场景数据稀缺如何破解、以及与既有系统如何深度集成。
带着"我所在行业里,哪些任务具备明确评价标准"这个问题去参会,会比追问模型能力更有收获——因为垂域化的第一道门槛从来不是模型,而是能否把专家判断变成可训练、可验证的东西。
大会信息 2026 奇点智能技术大会 + C++ 及系统软件技术大会 时间:2026 年 11 月 20-21 日 地点:中国·北京万达文华酒店 已整理大会资料:点击免费领取
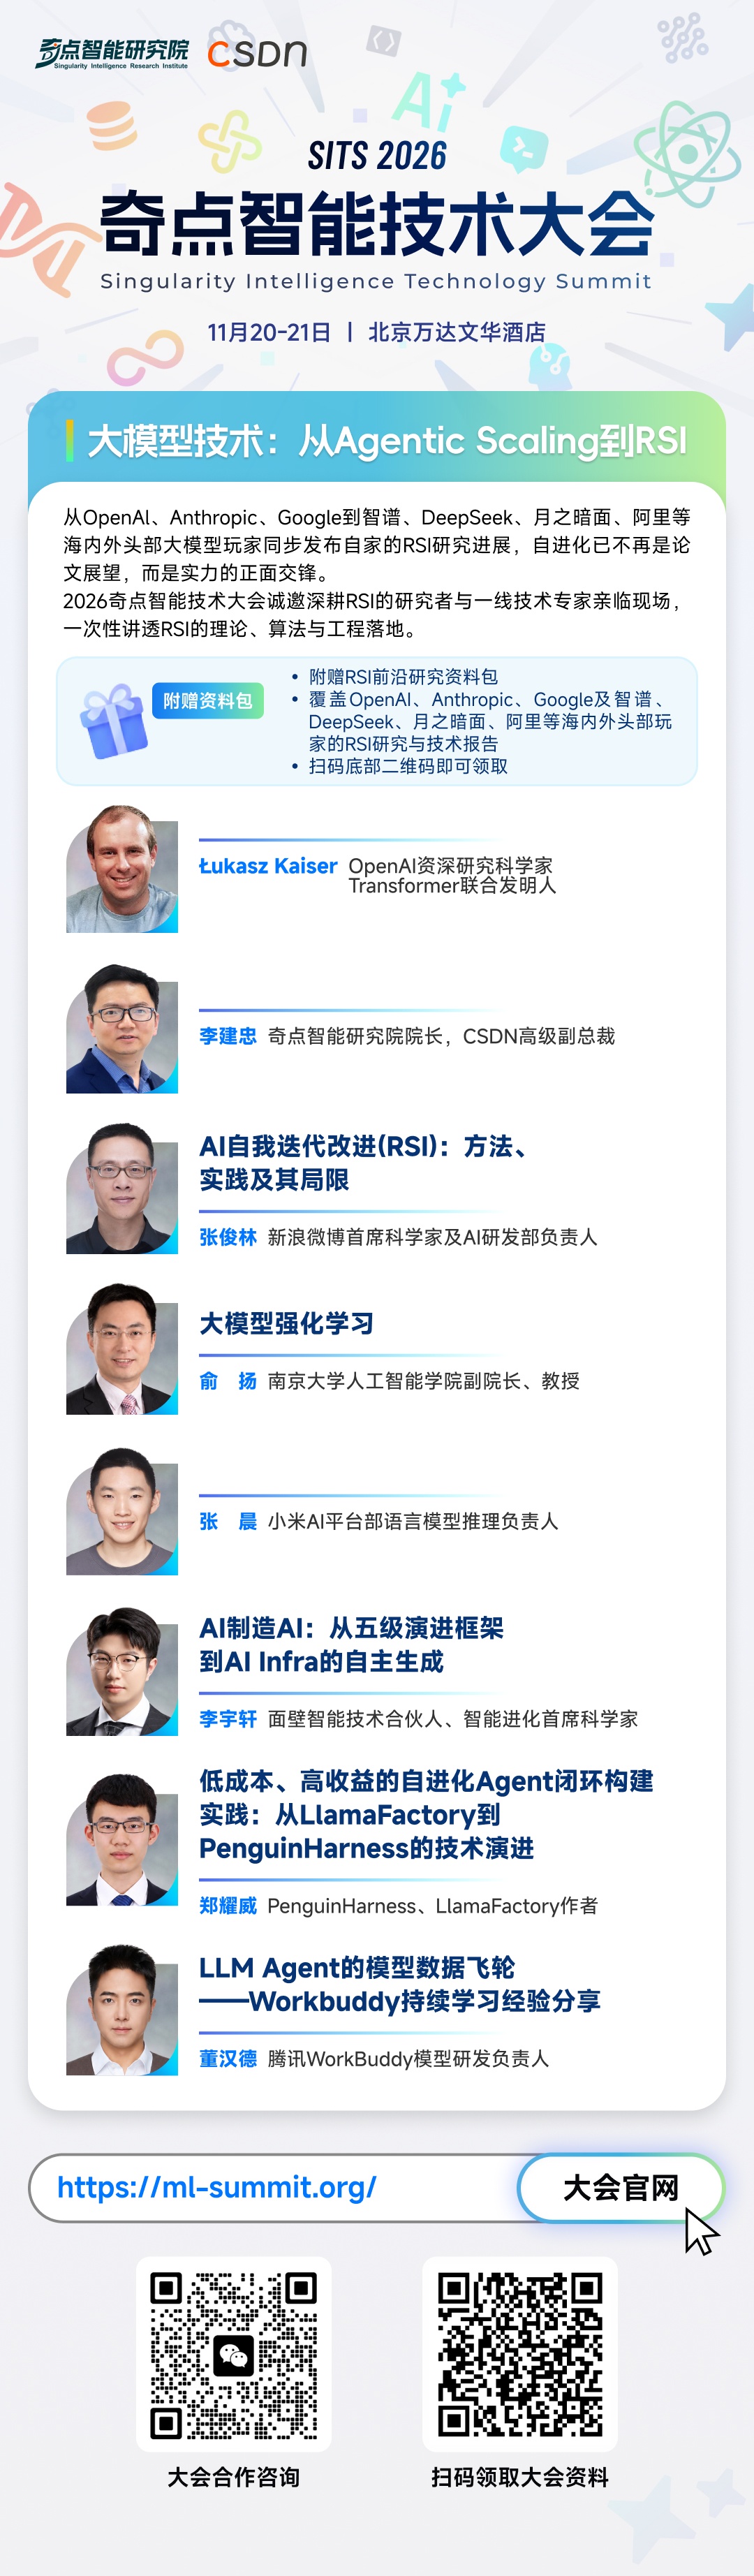
立即报名,锁定 Lukasz Kaiser Keynote 与 70+ 场演讲完整资料!


评论前必须登录!
注册