 网硕互联帮助中心
AI安全新范式:从语言证明到运行时边界
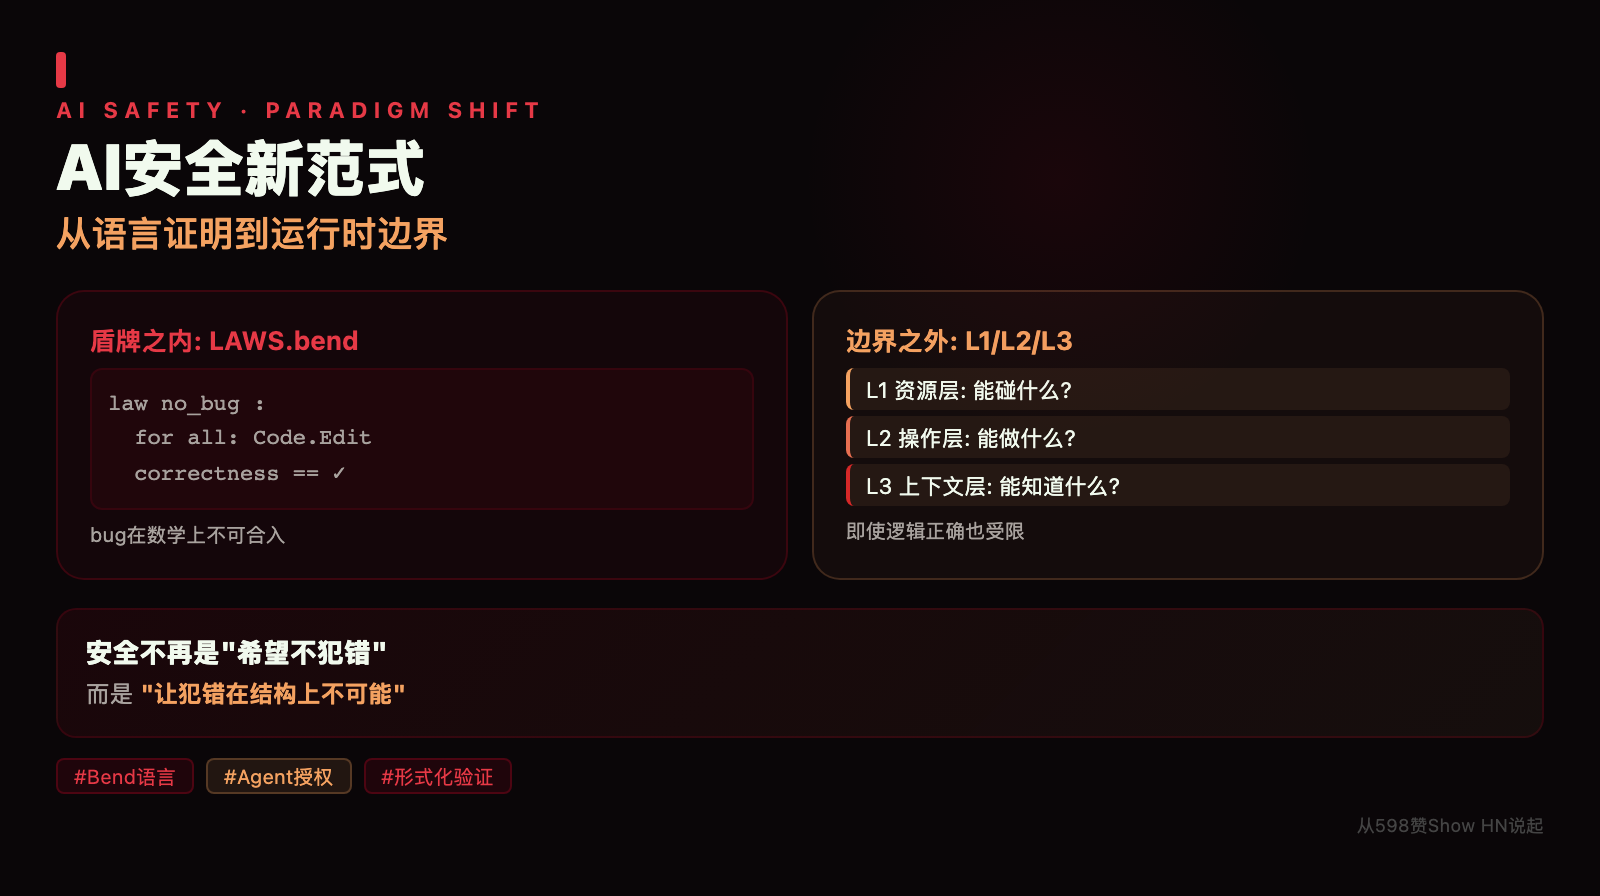
当AI能在几秒内写出过去需要一天的代码时,人类审查者彻底失明了。我们不是不够努力——是物理上不可能读完每一行。今天的AI安全,必须从"希望不犯错"进化到"犯错在数学上不可能"。
一个思想实验
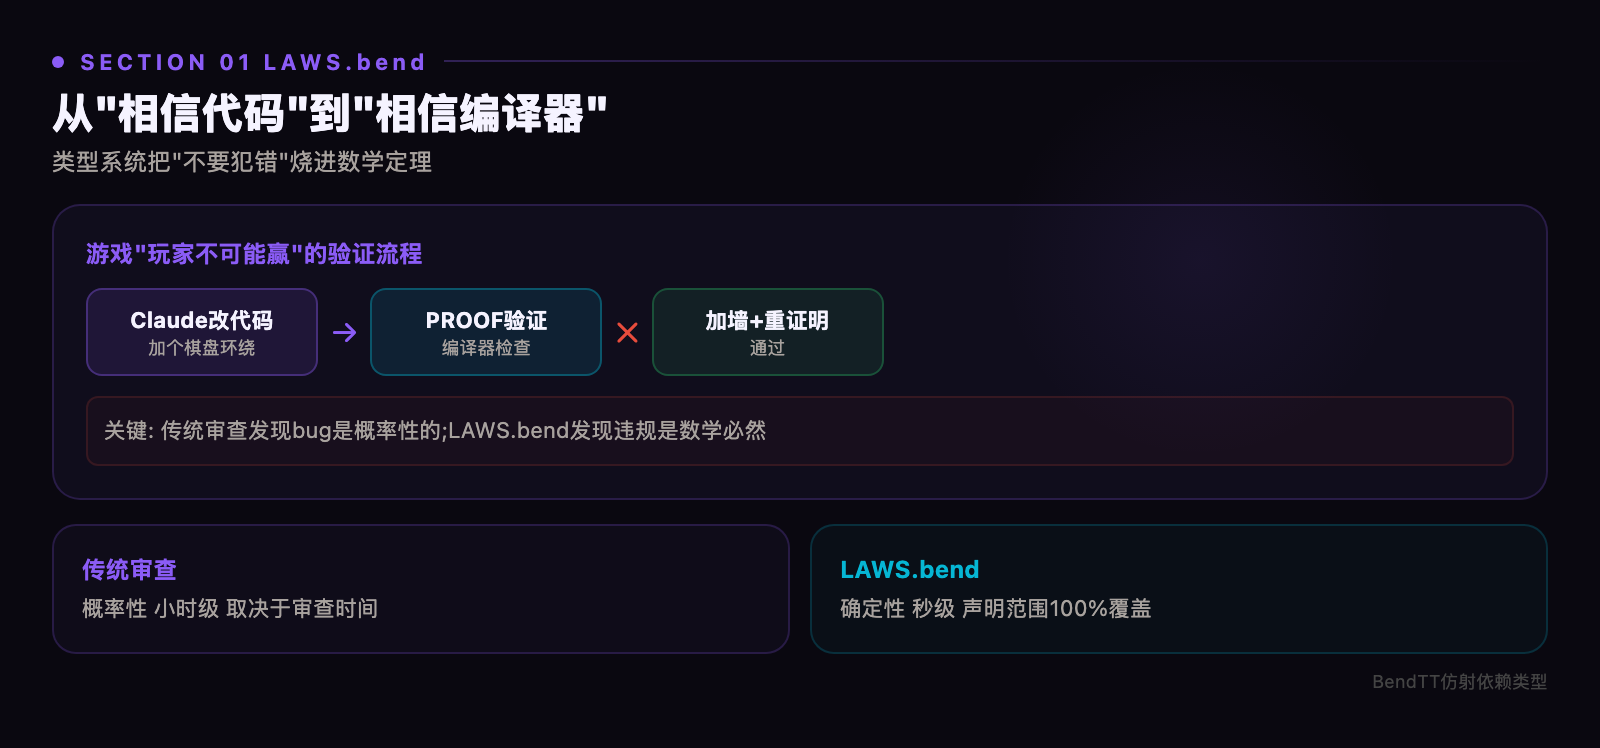
假设你的游戏有一条铁律:玩家不可能赢。你让Claude加个"棋盘环绕"功能。在没有保护的情况下,AI可能改出侧边通道——洞穿了铁律,bug上线了。
你甚至不知道它发生了。直到玩家赢了,直到有人发推截图。
这不只是"AI犯错"的问题。它说明了一个更深层的结构性缺陷:当生成速度超过审查速度时,Review环节变成了一种安慰剂仪式。
Bend 语言的核心洞察就是从这里开始的。
一、Bend:把"不能犯错的规则"编译进类型系统
Bend 是一门新编程语言,来自 Higher Order Company。它的官网说得直白:
“在后AGI经济中,人类终将停止编写和阅读代码,但我们仍然需要一种无歧义的方式来告诉AI我们要做什么。Bend就是那门语言。”
这句话的潜台词是惊人的:如果人类不再读代码,代码传统的"审查安全模型"就彻底崩了。
Bend的解决方案是 LAWS.bend —— 一个专门声明应用规则的文件。这些规则不是注释、不是单元测试,而是编译器数学证明的对象。
LAWS.bend 的工作方式
当你写下这些:
LAW: "所有余额总和必须为零"
LAW: "list_sort() 必须始终返回升序数字"
LAW: "array_set() 绝不能越界调用"
LAW: "玩家不可能赢"
编译器就不再只是检查类型是否匹配。它在执行一个 定理证明 任务:确认你的代码不会违反任何已声明的 LAW。
回到前面的"棋盘环绕"场景:
- 没有 LAWS.bend:AI修改了代码,bug合入上线,玩家获胜。
- 有 LAWS.bend:AI修改代码,编译器运行证明——发现新代码违反了"不可能赢"的法则。AI被拒绝提交。AI被迫重试,加上一堵墙,生成一个新证明,这次通过了。
区别在哪?在第二个场景里,合入bug在数学上不是"很难",而是"不可能"——它是一个已被证明的定理。 这不是概率性的安全措施(99%能发现),而是确定性的安全保障(100%阻止特定类别的错误)。
Bend 背后的理论强度
这不是工程hack。Bend 的核心理论基础是 BendTT —— 一种仿射依赖类型理论(affine dependent type theory),能表达 for all possible inputs, property holds 这类量化命题。
关键指标:Bend 的类型检查器能在不到一秒内验证中型项目——传统证明助手(Lean/Rocq)需要几分钟的工作量。这个差距意味着它可以在每次 AI 修改代码后实时运行,不破坏工作流节奏。
更激进的是它的宣传语:
"LAWS.bend 是 AGENTS.md 的证明增强版。“不要犯错"现在是被类型检查的。”
这直接指向了当前的 AGENTS.md 热潮:社区正在制定项目级"Agent行为宪法"。Bend 的提议是:纯文本宪法不够,需要机器可检查的版本。
二、Agent授权边界:L1/L2/L3三层模型
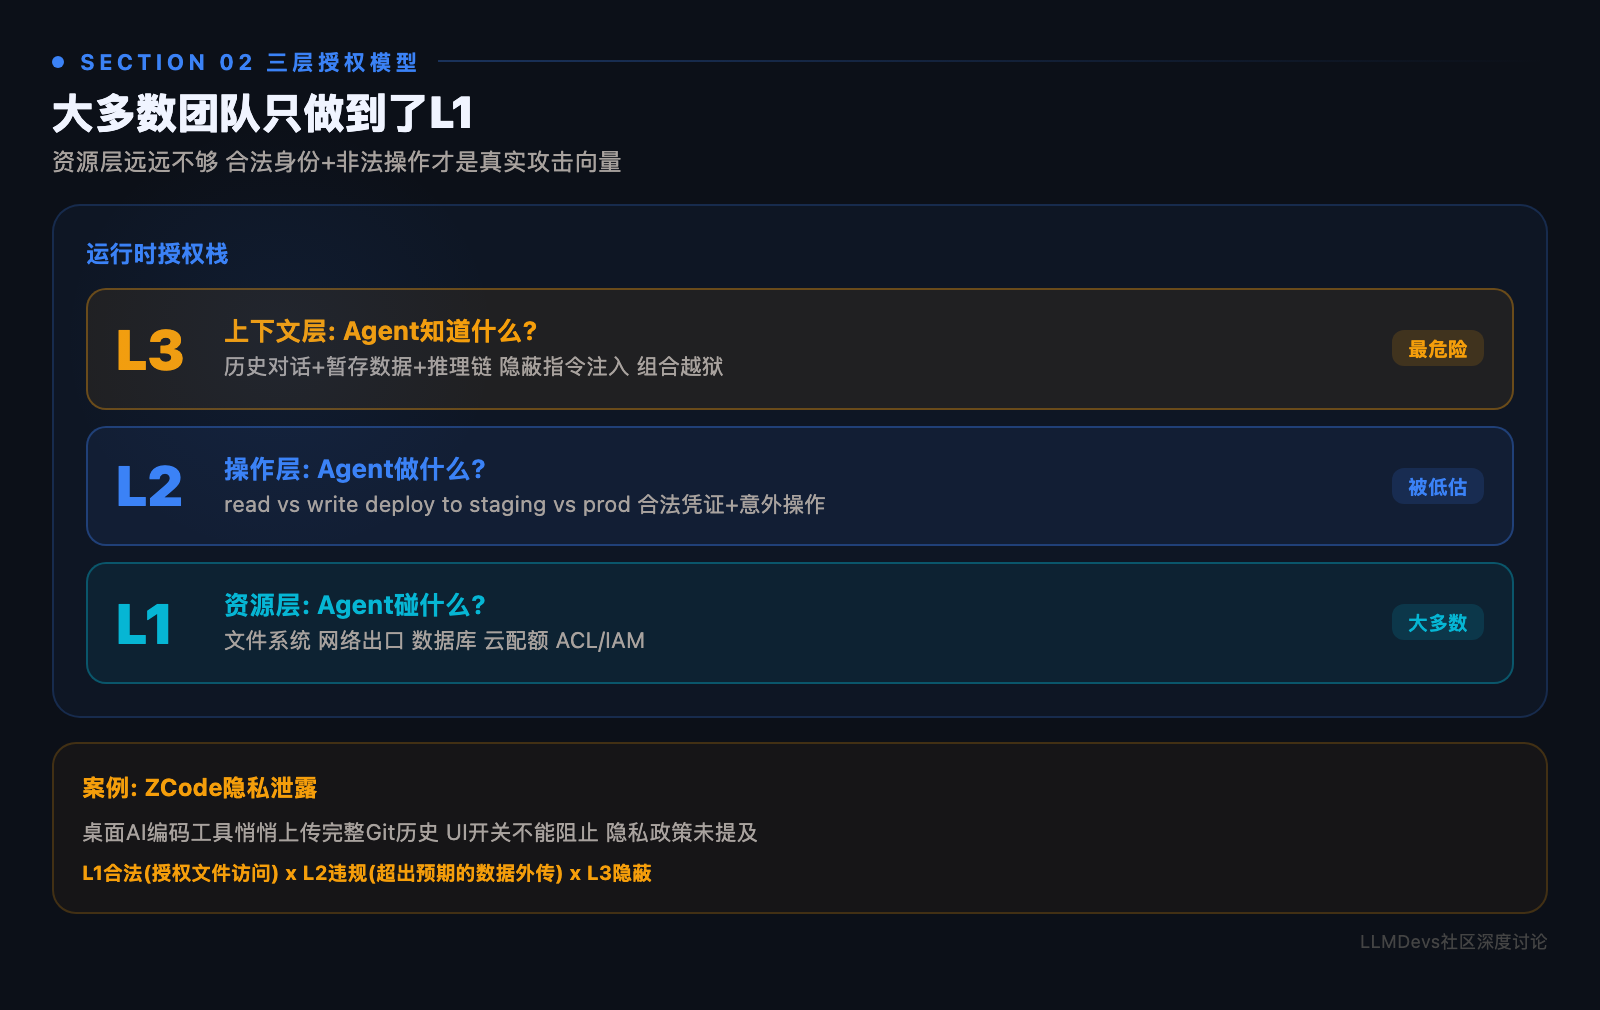
现在从语言层跳到运行时层。即使每个AI编写的程序都能内部证明正确,还有一个现实问题没解决:AI Agent在运行时可以调用什么工具、访问什么数据?
LLMDevs 社区的讨论中浮现了一个清晰的三层授权模型:
L1 资源层:Agent能碰什么?
"Agent不能碰生产数据库"是大多数团队实际实现的唯一一层。
- 文件系统访问范围
- 网络出入口白名单
- 数据库连接权限
- 云端资源配额
这是最直观的一层,也正是大多数Agent凭证泄露攻击的核心战场。一个典型场景:Agent拿到了GitHub token,于是能push代码到生产仓库。没人让它push——它自己"决定"了。
L2 操作层:Agent能做什么?
更细粒度的控制:只读vs读写、只deploy到staging、只调用特定API端点。
这一层的难点在于"合法身份+非法操作"的操作。Agent有合法凭证,但它执行的操作可能超出业务预期。比如:Agent调用你的邮件API发送营销邮件——技术上它拥有调用权限,但业务上不该主动触发。
ZCode事件就是这一层的典型案例:桌面端有合法的"用户提供文件用于AI分析"之名,实际悄悄上传了完整的Git历史到自家服务器。UI开关无法阻止上传——因为从L2角度看,上传是编码工具的正常操作之一。
L3 上下文层:Agent"知道"什么?
这是最被忽视、也最危险的一层。Agent的上下文包含了历史对话、暂存数据、前文推理链。攻击者可能通过精心构造的输入,在上下文中注入隐蔽指令——引发组合式越狱。
为什么大多数团队只做到了L1?
- L1 可以用 ACL、IAM policy 表达,工具链成熟
- L2 需要业务规则与运行时的强耦合,工程量大
- L3 几乎是研究级问题,没有标准答案
而恰恰是很多团队以为"L1够了",才导致Agent凭证泄露后能以"合法身份"横向移动,绕过基于身份的访问控制模型。
三、两种范式的交汇:从"信任审查"到"数学保证"
把它们放在一起看:
| 核心假设 | 人类无法逐一审查AI的输出 | 人类无法逐一审计Agent的行为 |
| 解决思路 | 形式化规约+类型检查 | 分层授权+最小权限 |
| 安全保障 | 数学定理(确定性) | 策略执行(概率性) |
| 覆盖范围 | 代码内部的逻辑正确性 | Agent与外部系统的交互 |
两者互补而非替代。LAWS.bend 保证"逻辑不会错",而三层授权保证"即使逻辑正确,动作也受限"。
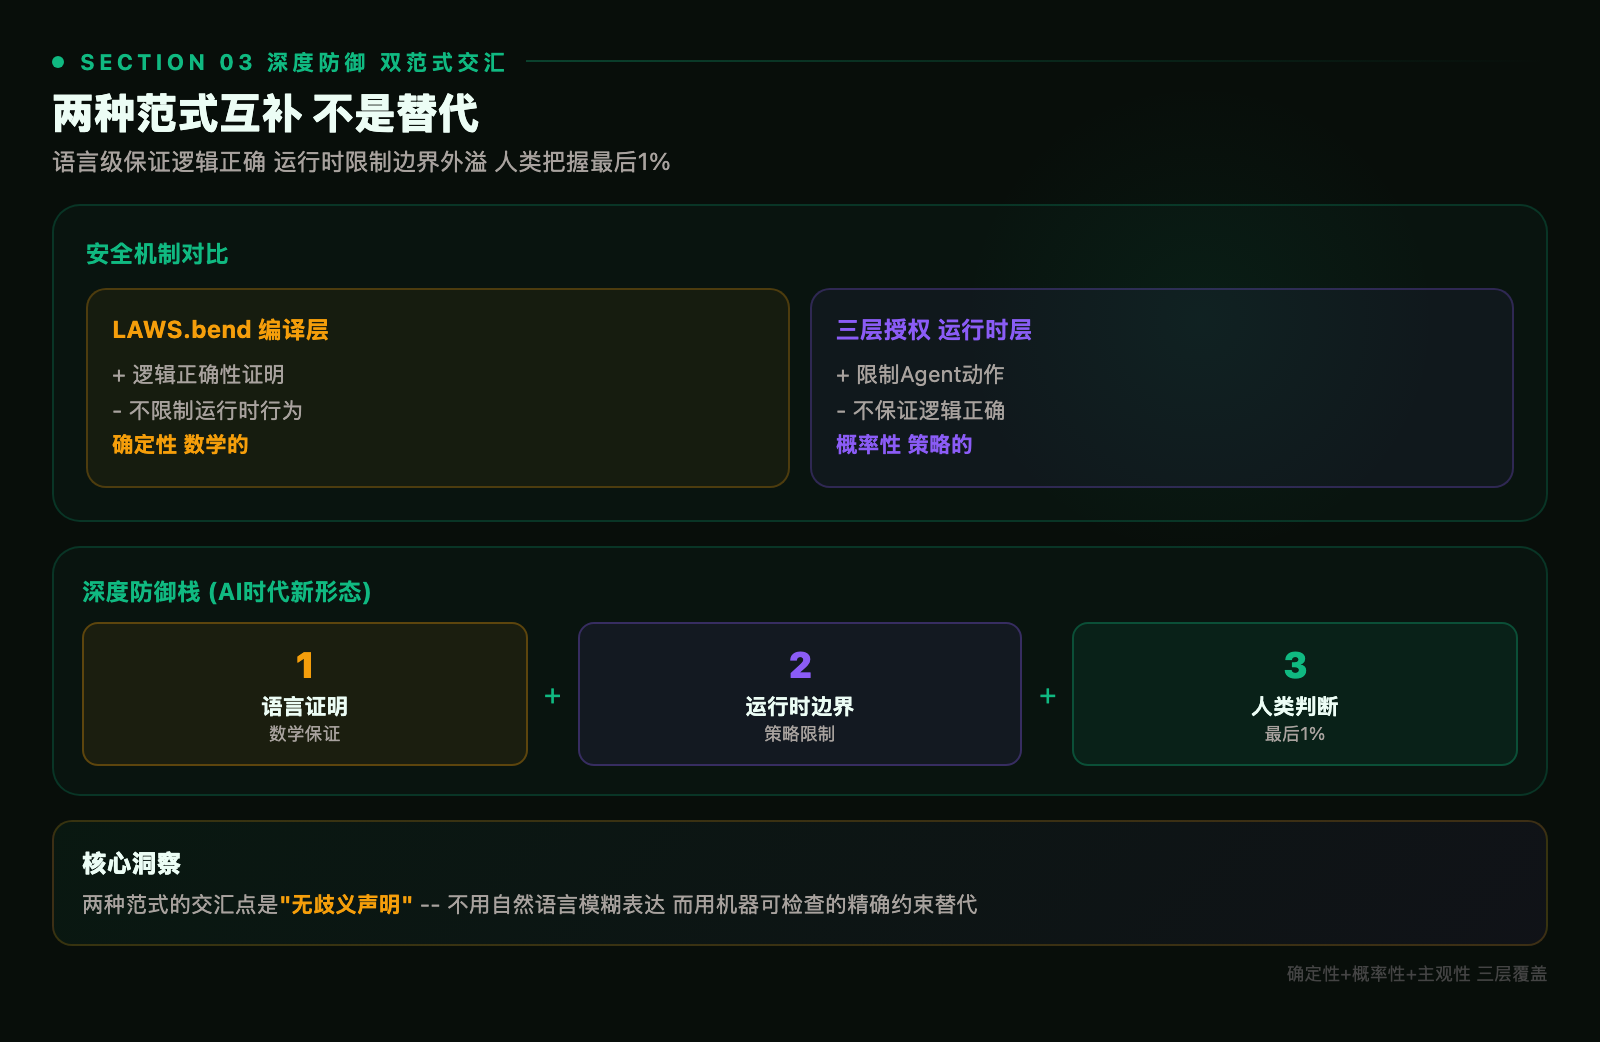
想象一个结合的场景:一个AI编程Agent, 它的代码通过了 LAWS.bend 证明,保证了不会产生特定bug;同时它被限制在L2层——不能直接deploy生产代码,只能提交到staging。即使证明逻辑完美无误,上线仍然需要人类点击确认。
这是深度防御(Defense in Depth)在AI时代的新形态。
四、不止于安全:关于"无歧义沟通"的深层意义
回到 Bend 的核心主张:
“在后AGI经济中,我们需要用自然语言之外的方式告诉AI我们要做什么。”
这不是杞人忧天。当前Agent问题的很大一部分来源于自然语言的模糊性。"优化一下首页"可能意味着减小图片、重构缓存策略、或是砍掉整个侧边栏。AI必须猜测你的真实意图,而猜测就是错误的温床。
LAWS.bend 的思路是:不要猜测,声明。 就像你说"门不能打开",AI就不会给你一个能打开的门。
这和三层授权模型在精神上是一致的:都是把"人类模糊意图"转化为"机器可检查/可执行"的精确约束。
区别在于精度不同:
- 三层授权(运行时层):把意图翻译成策略,由运行时代理发牌。策略是近似的。
- LAWS.bend(编译层):把意图翻译成数学命题,由类型系统精确证明。是数学的。
未来可能出现一种新编程范式:系统核心逻辑用"证明型"语言(如Bend)编写,而胶水层/交互层用传统语言编写,由Agent负责在三者之间翻译。
五、现实的限制与诚实的评估
必须指出:不是所有问题都能被LAWS.bend表达。
Bend擅长表达形式化可证的属性:
- 排序的正确性
- 数据库事务的原子性
- 特定状态不可达
- 数组不越界
但它难以表达:
- “用户体验流畅”(不可量化)
- “设计美观”(高度主观)
- “符合品牌规范”(难以形式化)
- “不会生成歧视性内容”(语境的)
这意味着 LAWS.bend 式的方法是一个有用的狭窄工具,不是万能药。它在你能把需求精确表达为逻辑命题的地方无比强大,在需要人类判断的地方无能为力。
同样,L1/L2/L3 模型本身也有盲区:
- 跨层攻击:L1看起来限制了资源,但Agent可能通过一个被允许的API调用间接访问被禁止的资源
- 时间维度缺失:授权模型通常是静态的——“能做/不能做”——缺少"在什么条件下能做/不能做"的动态语义
- 组合爆炸:多个安全操作各自合规,但组合效应可能危险(两个单独无害的API调用串在一起就能提权)
这些正是后续技术演进需要攻克的关卡。
六、结论:AI安全的范式转移
理解今天的AI安全,需要放弃一个隐含假设:安全问题最终会由更聪明的审查机制解决。
无论人类审查多仔细、CI/CD管道多严格,面对AI的代码产出速度,传统审查模型都已失效。Hacker News上Bend的598个赞不只是对一个编程语言的惊叹——它反映了社区深处的一种焦虑:
当AI能瞬间产出我们无法读完的代码时,我们到底还能信任什么?
答案正在清晰起来:
Bend和三层模型分别指向了前两个方向。第三个——深度防御的整体系统——是所有人正在拼凑的方向。
而这一切的核心思想只有一句话:
安全不再是"希望不犯错",而是"让犯错在结构上不可能"。


评论前必须登录!
注册