 网硕互联帮助中心
9月15日,美光宣布在多个服务器平台完成全球首款512GB DDR5 RDIMM的演示验证,最高传输速率9200MT/s。AMD和英特尔均已启动平台验证,量产时间定在2027年下半年。
这不仅意味着单条内存条容量的重大突破,更标志着DDR5内存从平面封装正式进入三维堆叠时代,而AI服务器的内存体系,正在从"够用就行"转向容量、带宽、能效三重约束下的系统级重构。
单条512GB技术路径:3D堆叠与TSV封装
单条内存条做到512GB,核心不是DRAM晶粒容量的线性提升,而是封装方式的根本变化。
传统DDR5 RDIMM采用平面布局,DRAM晶粒平铺在PCB板上,受限于内存条物理尺寸和晶粒面积,单条容量存在天花板。当前主流量产的DDR5 RDIMM单条最高128GB,基于32Gb单颗粒,需要在PCB两面排布多颗芯片。
美光512GB RDIMM采用3DS(3D Stacking)三维堆叠封装,将多颗DRAM晶粒在单个封装内垂直堆叠,通过TSV(Through-Silicon Via,硅通孔)实现层间高速互连。
TSV的原理是在硅晶圆上刻出微米级通孔,填充导电材料,使上下层晶粒之间可以直接通过垂直通道传输信号,而不需要通过封装基板绕行。这与HBM高带宽内存、AMD 3D V-Cache使用的是同一类技术路径。
这种设计带来三个直接结果。
第一,密度大幅提升。在不改变内存条外形尺寸和服务器DIMM插槽数量的前提下,单插槽容量从128GB跃升至512GB。一台配备24个内存插槽的双路服务器,理论内存上限从3TB提升到12TB。
第二,功耗显著下降。单个512GB模块相比用多个小容量模块实现同等容量,运行功耗降低60%以上。原因在于堆叠封装减少了PCB走线长度和信号驱动数量,同时模块数量减少意味着整体电源转换损耗下降。
第三,性能不打折扣。垂直堆叠通过TSV互连,信号路径远短于平面PCB走线,在9200MT/s高速率下仍能保持信号完整性。这不是牺牲性能换容量,而是封装升级同时提升容量和能效。
3DS RDIMM并非全新概念。美光在2026年5月已向合作伙伴送样256GB DDR5 RDIMM,同样采用3DS+TSV封装,基于1-gamma DRAM制程。512GB是在同一技术路线上的进一步密度提升。从128GB到256GB再到512GB,三维堆叠正在成为DDR5高容量内存的标准工艺。
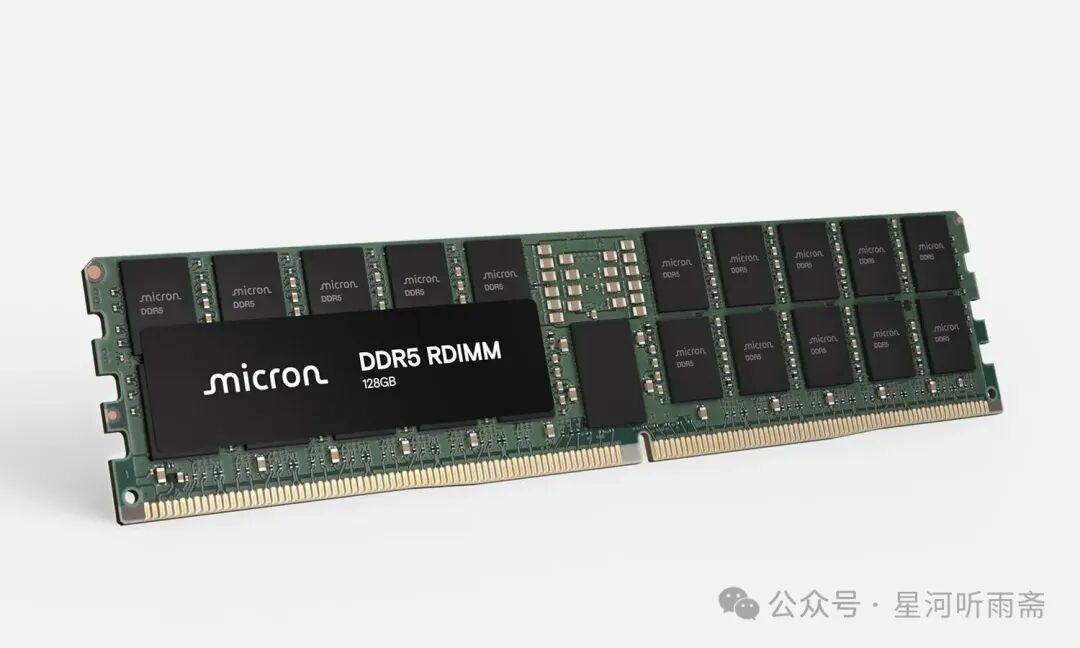
图1:美光DDR5 RDIMM官方产品图,标准288针服务器内存模块形态
DDR5 RDIMM技术架构拆解
理解512GB RDIMM,需要先搞清楚DDR5内存模块本身的架构。DDR5相比DDR4不是简单的速率提升,而是模块级架构的重新设计。
1. 双子通道架构
DDR4 RDIMM采用单通道72位总线,其中64位数据加8位ECC校验。DDR5将每个DIMM模块拆分为两个独立的子通道,每个子通道40位宽(32位数据加8位ECC),总数据宽度仍为64位。
两个独立子通道的意义在于:CPU可以同时对两个子通道发起不同的读写请求,内存访问的并发性和总线效率显著提升。尤其是在高核心数CPU环境下,多个核心同时访问内存时,双子通道可以减少冲突和等待。
2. RCD:寄存器时钟驱动器
RDIMM的核心组件是RCD(Registering Clock Driver,寄存器时钟驱动器)。CPU发出的地址、命令、控制和时钟信号不直接到达DRAM晶粒,而是先经过RCD缓冲和重新驱动。
RCD的作用是降低CPU内存控制器的电气负载。如果没有RCD,CPU需要直接驱动模块上所有DRAM晶粒的地址和命令引脚,电气负载过重,无法支持高速率和多插槽配置。RCD将信号重新驱动后分发到各DRAM晶粒,使CPU只需要驱动RCD这一个负载。
RCD只缓冲地址、命令和时钟信号,数据线(DQ/DQS)不经过RCD,直接在CPU和DRAM之间传输。这是RDIMM与全缓冲DIMM的核心区别。
3. PMIC:模块上的电源管理
DDR5另一个重要变化是将电源管理从主板移到了内存条上。每个DDR5 DIMM集成一颗PMIC(Power Management IC,电源管理芯片),在模块本地完成电压转换和稳压。
DDR4时代,内存条所需的多种电压由主板VRM统一提供,不同速率和容量的内存对电压需求不同,主板设计复杂度高。DDR5将PMIC放到模块上,由模块自身管理电源,主板只需要提供单一输入电压,降低了主板设计难度,同时提升了电源转换效率和供电稳定性。
4. 温度传感器与SPD Hub
DDR5 RDIMM配备多颗温度传感器(TS),实时监测模块不同位置的温度,提供热遥测数据供系统管理。SPD Hub(Serial Presence Detect Hub)存储模块的身份信息、规格参数和温度传感器数据,系统启动时通过I2C/SMBus读取。
这些管理组件的加入,使DDR5内存条从一个被动的存储部件,变成了一个具备自我管理能力的智能子系统。
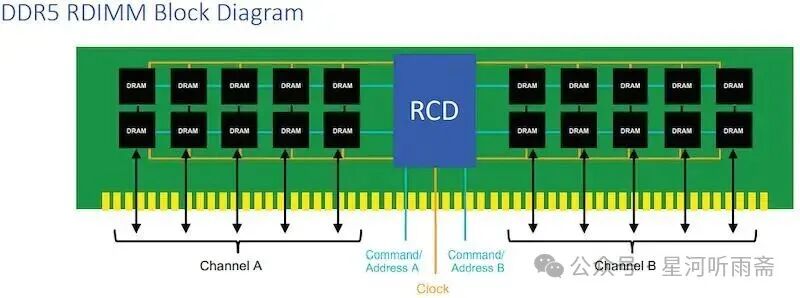
图2:DDR5 RDIMM架构图,RCD位于中央,左右两侧为双子通道DRAM阵列
9200MT/s:速率演进与内存墙
512GB RDIMM的另一个关键参数是9200MT/s的传输速率。这个数字放在DDR5的演进路线中看,已经接近DDR5标准的理论上限。
DDR5标准定义的速率范围是4800MT/s到8800MT/s,9200MT/s已经超出了JEDEC标准的正式定义范围,属于厂商在标准基础上的扩展。美光官网显示,其DDR5 RDIMM速率最高可达9200MT/s,MRDIMM最高8800MT/s。
从DDR4到DDR5,速率提升的轨迹很清晰:DDR4最高3200MT/s,DDR5初期4800MT/s,主流5600至6400MT/s,高端7200至8000MT/s,极限8800至9200MT/s。
速率提升的背后是内存墙问题的持续加剧。
内存墙(Memory Wall)指的是处理器算力增长速度远快于内存带宽增长速度,导致处理器计算单元经常处于等数据的空闲状态。这个问题在AI时代被急剧放大:GPU算力每18个月翻一倍,但内存带宽的增长周期更长,两者之间的剪刀差越来越大。
HBM的出现部分缓解了AI算力的内存墙问题。HBM通过3D堆叠和与GPU的近距离封装,将单堆叠带宽提升到TB/s级别,比传统GDDR高出一个数量级。但HBM容量有限、成本极高,不可能覆盖所有内存需求。
DDR5系统内存的角色因此变得更加关键。在AI服务器中,HBM负责GPU近侧的高带宽数据供给,DDR5负责CPU侧的大容量数据缓存和模型参数存储。当大模型推理需要加载数百GB甚至TB级参数时,DDR5的容量和带宽直接决定了推理吞吐量和延迟。
9200MT/s的DDR5 RDIMM,单条理论带宽约73.6GB/s。在双路服务器典型多通道配置下,总带宽可达数百GB/s到近TB/s级别。这个数字虽然与HBM的TB/s级别仍有差距,但对于CPU侧的通用计算、数据预处理、模型权重加载等场景,已经是重要的性能支撑。
DDR5速率提升不只是数字游戏。每一次速率跃升都需要DRAM晶粒、接口芯片、PCB设计、信号完整性的协同升级。9200MT/s能够在512GB超高容量模块上实现,说明3DS堆叠封装在高速信号完整性上已经成熟,为后续更高密度和更高速率的产品铺平了道路。
AI服务器内存架构:HBM、DDR5与CXL
512GB DDR5 RDIMM的发布,放在AI服务器内存体系的演进中看,只是其中一环。当前AI服务器的内存体系正在形成清晰的三层架构。
第一层:HBM,高带宽近计算内存
HBM位于AI计算单元内部,与GPU或AI芯片通过2.5D封装(硅中介层)或3D封装直接互连。特点是带宽极高(单堆叠1至2TB/s)、延迟极低,但容量有限(单堆叠24至36GB)、成本极高。
HBM的核心价值是为AI训练和重度推理提供GPU近侧的高速数据供给,解决算力单元喂不饱的问题。HBM4、HBM5正在向更高带宽和更大堆叠层数演进,但受限于工艺复杂度和成本,HBM不可能成为大容量通用内存。
第二层:DDR5 RDIMM,大容量系统内存
DDR5位于服务器主板上,通过CPU内存控制器访问。特点是容量大(单条128甚至至512GB,单台服务器最高12TB)、成本相对可控、带宽适中(单条50至70GB/s)。
DDR5在AI服务器中的角色是多方面的:CPU侧的通用计算内存、模型参数和数据集的大容量缓存、AI推理时的权重存储、多GPU之间的数据中转。512GB RDIMM的出现,使单台服务器的DDR5容量上限从3TB提升到12TB,对于需要在CPU侧加载大模型进行推理或数据处理的场景,价值直接。
第三层:CXL内存池,弹性扩展的远端内存
CXL(Compute Express Link)协议允许CPU通过PCIe物理层访问远端内存设备,实现内存的池化和共享。CXL内存设备可以是独立的内存条形态,也可以是专门的内存扩展机箱。
CXL内存的价值在于打破内存绑定CPU的传统架构。在AI服务器中,不同GPU和CPU对内存的需求动态变化,CXL允许内存资源在多个计算节点之间弹性分配,提高整体内存利用率。同时,CXL内存可以作为HBM和DDR5之间的中间层,提供比DDR5更低延迟、比HBM更大容量的扩展选项。
三层架构的核心逻辑是分层优化:HBM解决带宽问题,DDR5解决容量问题,CXL解决弹性和利用率问题。三者不是替代关系,而是协同关系,共同构成AI服务器的完整内存体系。
512GB DDR5 RDIMM在这个体系中的定位很明确:它大幅提升了第二层的容量天花板,使单台服务器能够在不依赖CXL扩展的情况下承载更大的模型和数据集,同时保持了DDR5的成本优势和成熟生态。
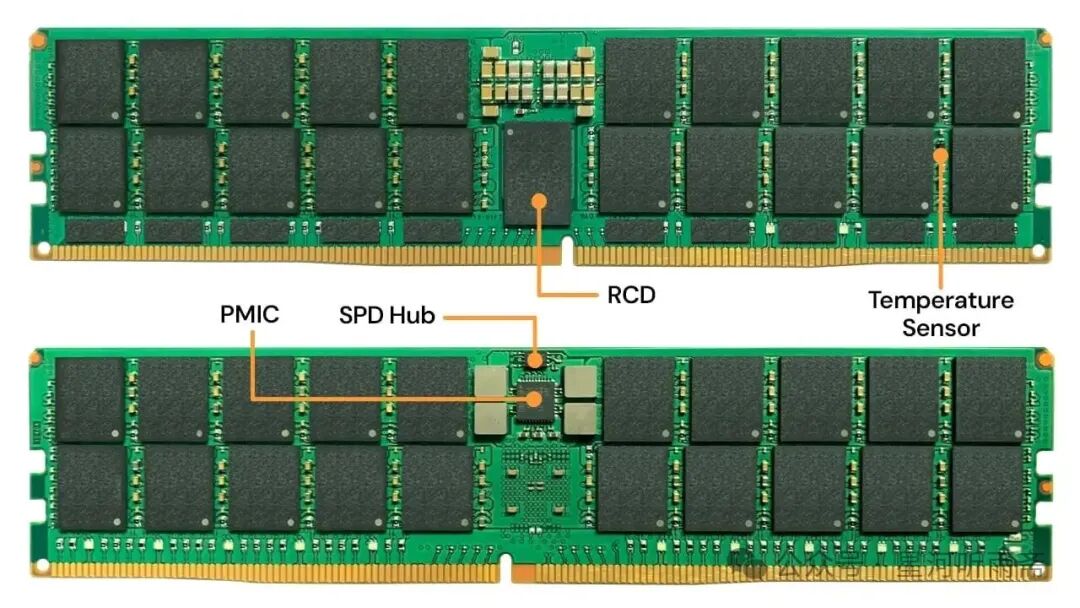
图3:DDR5 DIMM板级组件分布图
MRDIMM:下一代高带宽内存标准
在RDIMM向更高容量演进的同时,另一条技术路线MRDIMM正在向更高带宽突破。
MRDIMM(Multiplexed Rank DIMM,多路复用秩内存模块)是JEDEC定义的DDR5新一代内存标准,核心思路是在单根模块内实现两组DDR5通道并行工作,通过多路复用秩架构有效提升内存传输带宽。
MRDIMM与传统RDIMM的关键区别在于:RDIMM的数据线不经过缓冲,直接连接CPU和DRAM;MRDIMM在数据路径上增加了数据缓冲器(DB),并通过MRCD(Multiplexed Registering Clock Driver)实现两组通道的时分复用。
目前第一代MRDIMM传输速率可达8800MT/s,带宽比传统DDR5 RDIMM提升约39%,延迟降低约40%。第二代产品目标速率12800MT/s,第三代规划17600MT/s,迭代路径清晰。
MRDIMM的出现,是对内存墙问题的另一种回应。当DDR5 RDIMM的速率提升接近物理极限时,通过模块架构创新(增加数据缓冲、多通道并行)来提升有效带宽,是比单纯提升晶粒速率更可行的路径。
美光在MRDIMM上也有布局,其MRDIMM速率最高8800MT/s。Rambus、瑞萨等接口芯片厂商已经推出了MRDIMM专用的MRCD和MDB(数据缓冲器)芯片。
RDIMM和MRDIMM走的是两条路线:RDIMM的演进方向是更高容量(3DS堆叠,512GB),MRDIMM的演进方向是更高带宽(多路复用,8800至17600MT/s)。两条路线并行,分别对应AI服务器对内存的不同需求维度。未来可能出现3DS加MRDIMM的组合,同时实现超高容量和超高带宽。
产业链与竞争格局
DDR5内存产业链可以分为三个层级:DRAM晶粒制造、内存接口芯片、模组封装与品牌。
DRAM晶粒制造:三巨头垄断
全球DRAM市场由三星、SK海力士、美光三家垄断,合计市场份额超过90%。三家在DDR5上的技术路线各有侧重:
美光在3DS高容量RDIMM上推进最快,256GB已送样,512GB已完成演示验证,1-gamma制程领先。三星在DDR5整体产能和良率上优势明显,HBM和DDR5双线推进。SK海力士HBM市场份额领先,DDR5方面与英特尔、AMD保持密切合作,近期传出与英特尔讨论在美国合产存储芯片。
三家在DDR5速率上都已覆盖到8000MT/s以上,9200MT/s属于美光率先展示的极限速率。高容量3DS RDIMM是当前竞争的焦点,因为它直接对应AI服务器的大容量内存需求。
内存接口芯片:专业厂商主导
DDR5 RDIMM和MRDIMM需要专用的接口芯片,包括RCD、PMIC、DB(数据缓冲器)、MRCD、SPD Hub、温度传感器等。这个领域由几家专业厂商主导:
Rambus是DDR5接口芯片的领先供应商,提供完整的RDIMM和MRDIMM芯片组方案。瑞萨提供RCD、PMIC、数据缓冲器等完整芯片组,是同时覆盖RDIMM和MRDIMM全芯片组的厂商之一。澜起科技是国内内存接口芯片龙头,DDR5 RCD已实现量产,在全球市场份额领先。安森美、MPS等在PMIC领域有布局。
接口芯片单颗价值不高,但技术门槛极高,是DDR5内存模块性能和稳定性的关键决定因素。尤其是在9200MT/s高速率和3DS高容量配置下,RCD的信号驱动能力和PMIC的电源管理精度直接决定模块能否稳定工作。
模组封装与品牌
模组厂商负责将DRAM晶粒、接口芯片、PCB组装成最终内存条,并进行测试和品牌销售。服务器内存市场的主要模组厂商包括美光、三星、SK海力士自有品牌模组,以及金士顿、威刚、创见等第三方模组厂商。
在AI服务器市场,云厂商和服务器OEM通常直接向DRAM原厂采购高容量RDIMM,第三方模组厂商的份额相对较小。512GB 3DS RDIMM由于技术复杂度高、验证周期长,初期将主要由原厂直接供应。
趋势判断
基于512GB DDR5 RDIMM的发布以及产业链各环节的动态,可以得出以下判断。
第一,DDR5高容量化进入三维堆叠时代。128GB是平面封装的天花板,256GB和512GB必须依赖3DS加TSV封装。未来两到三年,3DS RDIMM将从高端演示走向规模量产,单条512GB将成为AI服务器的主流配置之一。三维堆叠工艺的良率和成本,将成为决定高容量内存普及速度的关键变量。
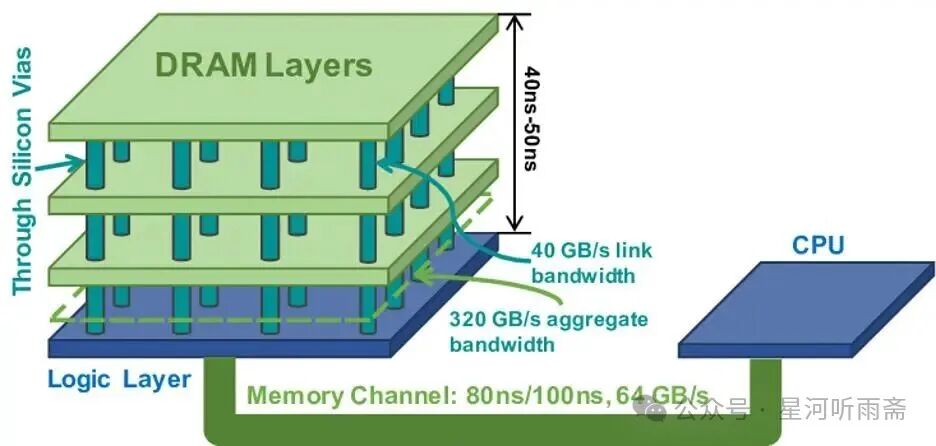
图4:3D堆叠TSV技术示意图,多层DRAM晶粒通过硅通孔垂直互连
第二,DDR5速率逼近物理极限,架构创新成为主航道。9200MT/s已经接近DDR5的理论上限,单纯依靠工艺微缩提升速率的空间有限。MRDIMM通过多路复用秩架构提升有效带宽,是DDR5代际内最重要的架构创新。未来RDIMM(高容量)和MRDIMM(高带宽)将形成互补格局,分别满足不同场景需求。
第三,AI服务器内存体系从单层走向三层协同。HBM解决带宽、DDR5解决容量、CXL解决弹性,三层架构正在成为AI服务器的标准配置。512GB DDR5 RDIMM大幅提升了第二层的容量天花板,使单台服务器能够承载更大的模型和数据集,减少对CXL扩展的依赖。CXL内存池化将在更大规模的AI集群中发挥作用,与本地DDR5形成互补。
第四,内存墙问题从带宽约束转向容量约束。HBM的普及基本解决了GPU近侧的带宽瓶颈,但大模型推理和训练对内存容量的需求呈指数级增长。一台AI服务器需要加载数百GB甚至TB级的模型参数,DDR5的容量直接决定了能否在单机内完成模型加载。512GB RDIMM的出现,正是对容量约束的直接回应。
第五,能效成为内存设计的核心约束。AI服务器的功耗问题日益突出,内存占整机功耗的比例持续上升。512GB 3DS RDIMM相比多模块方案降低60%功耗,说明高容量集成不仅提升密度,还能显著改善能效。未来内存产品的竞争,将从单纯的速率和容量比拼,转向容量乘以带宽除以功耗的综合能效比拼。
第六,国产替代在接口芯片环节已有突破,但DRAM晶粒制造仍是短板。澜起科技在DDR5 RCD领域已实现全球领先的市场份额,这是国产内存在产业链上游的重要突破。但在DRAM晶粒制造环节,国内厂商与三星、SK海力士、美光的技术差距仍然明显,DDR5高端产品的产能和良率仍需时间追赶。内存接口芯片的国产化经验,能否复制到DRAM制造环节,是产业链长期关注的问题。
512GB DDR5 RDIMM的发布,表面上是一条内存产品的升级,背后是整个AI算力基础设施内存体系的系统性重构。当AI模型参数从百亿级走向万亿级,当单台服务器的内存需求从几百GB走向十几TB,内存不再是算力的配角,而是与计算、网络并列的三大基础设施之一。理解内存技术的演进路径,就是理解AI算力下一阶段竞争格局的关键钥匙。(完)
——————
免责声明:本文仅用于半导体存储、DDR5内存、AI服务器架构及相关技术研究与产业分析,不构成任何投资、证券或金融产品相关建议,不作为投资参考。文中数据以各官方机构和企业正式发布口径为准。
星河听雨斋
深度产业研报:芯片半导体、AI基础设施、AI智能硬件、具身智能、光通信等硬件科技方面的行业研究、产业链分析和技术拆解。 作者:张星河,AI科技公司创始人,20年行业老兵。




评论前必须登录!
注册