 网硕互联帮助中心
摘要:Agent 返工的头号原因不是能力不足,而是没听懂需求就开干。本文给 Agent 装一道「澄清闸门」:先把不确定性分成认知、意图、随机三类,加权成总不确定度 U_total 后过三档闸门——低到可忽略就回音确认直接干,中等就用默认值推进并标注假设,过了线才开口问;同时设一条红线,凡涉及不可逆动作且关键参数缺失,无条件必问。再按「期望不确定减少量」给问题排序,只问最值钱的那个。机制经 Qulac 与 InfoQuest 两个公开数据集回测,抓出并修掉 3 个实现 bug,最终把「该不该问、问什么、按什么顺序问」从玄学变成可计算、可单测的判定。
Agent 最贵的错误,是没听懂就开干
给 Agent 装一道「澄清闸门」:该问的必问,不该问的闭嘴
Agent 返工的原因里,能力问题排不上号——绝大多数是它一开始就理解错了需求。
你说"帮我整理一下这份数据",它立刻给你一份端端正正的表格——字段全对,口径全错。你花十分钟重讲一遍需求,它两分钟改完。
也可能更糟:它反手问你七个问题,你烦得直接说"算了,我自己弄"。
这两种翻车,是同一个病根:它没有在动手之前,判断清楚自己该不该问。
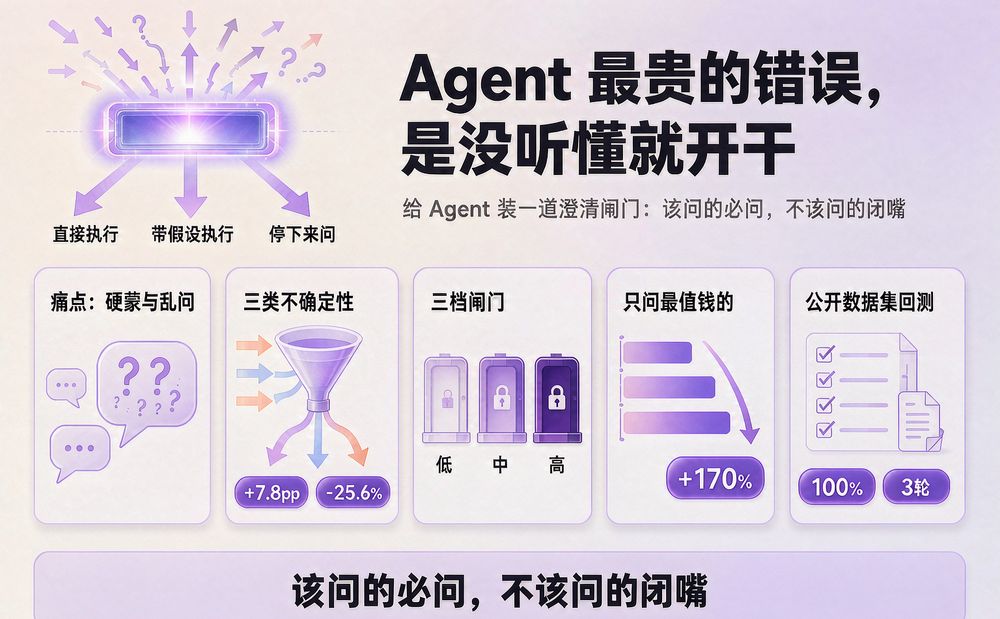
一张图看懂:三类不确定性加权成 U_total,过三档闸门,只问最值钱的问题。
一、痛点:要么硬蒙,要么烦人
Agent 的头号失败原因,从来不是能力不够,而是没听懂需求就开干。
用户抛来一句模糊的话,Agent 面前只有两条路:
- 硬蒙——挑一个自己觉得可能的解释直接做,做错了就是一次返工,还是方向性的返工;
- 乱问——一口气抛出七八个问题,把澄清的成本全甩给用户,用户直接弃用。
这不是个别现象。InfoQuest 基准(arXiv:2502.12257)用 1000 个"初始消息故意含糊"的场景测了 8 个主流模型,结论相当不客气:所有模型都难以有效收集关键信息。
它们常常需要多轮才能猜到用户意图,而且经常直接给一个又长又泛的回答,根本不主动澄清。
换句话说,模型不是不会说话,是不知道什么时候该闭嘴、什么时候该开口。
为什么"多问几句"不是解法
因为追问是有成本的:每多问一轮,用户就多一次等待、多一次组织语言、多一次被打断。
真实测试里用户的原话是——"我宁愿自己手动整理。"把问题问对,比把问题问多重要得多。
二、追问的收益,是被量化过的
先说好消息:主动澄清确实有用,而且有人把它量化了。
MAC 多智能体澄清框架(arXiv:2512.13154)在 MultiWOZ 2.4 上的实验显示:允许在"是否澄清"和"如何澄清"两个层面都做决策之后,任务成功率从 54.5% 提升到 62.3%(+7.8 个百分点)。
同一组实验里,平均对话轮数从 6.53 降到 4.86(约 -25.6%)。核心机制恰恰在于"把所需的用户信息一次性问清",而不是来回试探。
Qulac 数据集(arXiv:1907.06554)给出的证据更极端:在 198 个 TREC topic、762 个 facet、超过 1 万条问答对上的实验表明,只问一个好问题,P@1 检索性能就能提升超过 170%。
问一个对的问题,胜过十个泛泛的问题。
而在更早的 CLAM 工作(arXiv:2212.07769)里,研究者直接指出:当前语言模型遇到模糊问题时很少主动要求澄清,而是给出错误答案;只要让模型学会"选择性地澄清",准确率就有显著改善。
三篇论文指向同一件事:澄清不是"多说话",是一道需要判定的决策——判该不该问、判该问什么、判问完算不算数。
三、诊断:先分清"我在不确定什么"
大部分"澄清 prompt"的通病,是把所有不确定当成一类处理,于是要么全都问、要么全都不问。
真正该先做的,是给不确定分类。这个分类的源头,可以追到 Yarin Gal 的博士论文《Uncertainty in Deep Learning》——它把不确定性拆成两类,工程上常再拆出一类,共三种:
| 认知 epistemic | 我根本不知道这件事 | 缺外部事实:权限、名单、对方公司有哪些部门、这个季度有没有这笔预算 | 先查(RAG / 调工具),查不到再问 |
| 意图 intentional | 我没搞懂用户想干什么 | 参数缺失、动词模糊、口径不明 | 主动问(最该问的一类) |
| 随机 aleatoric | 我控制不了环境 | 对方会不会回、物流会不会延误、市场怎么走 | 别问(问了也没用),改做风险声明 |
这一步的价值在于:它把"要不要问"变成了有依据的判断,而不是感觉。
认知类先查(能查出来的问题不该拿去烦用户),随机类不问(问用户"明天会不会下雨"毫无意义),只有意图类才值得开口。
四、决策:三档闸门 + 一条红线
分清类型之后,把三类不确定加权成一个总的不确定度 U_total,再过闸门分流。
注意这里有个关键实现细节:权重只对"实际存在的类"归一化——如果只有意图一类不确定,那它的权重就恢复为 1,而不是被固定权重压死在阈值之下。
U_total –+– 命中硬闸门? –是–> ASK(红线,无条件问)
+– <= low ———————–> ECHO_EXECUTE 回音确认后直接干 +– < high ———————–> DEFAULT_EXECUTE 默认值干 + 标注假设 + 留修改入口 +– >= high ———————–> ASK 必须问(<=3 问,含等)</pre>
三档的含义,对应三种"不确定性成本":
直接干:不确定度已经低到可以忽略,Agent 回音确认一下就执行,不去打扰用户。
默认值干 + 标注:不确定,但可以用一个合理的常识默认值推进。关键动作是——把假设明明白白写进交付物,留一个修改入口。用户扫一眼不对,一句话就能推翻。
必须问:不确定度已经过了线,再猜就是掷骰子,停下来问。
还有一条凌驾于阈值之上的红线:哪怕 U_total 只有 0.01,只要命中"即将执行不可逆动作、关键参数缺失、且没有可信默认值"(发消息、改库、扣款、覆盖文件、对外发布),就必须问。
阈值可以放宽,红线不能让步。
五、排序:只问最值钱的问题
决定要问了,还有一个问题:先问哪个?全部问完当然最保险,但用户的耐心有限。所以需要给问题排个价。
思路来自"期望不确定减少量"(Expected Uncertainty Reduction):一个问题的价值,等于问完之后不确定度能减少多少。
严格算这个值需要枚举用户所有可能的回答并重算不确定度,在线成本极高;工程上用一个可观测的近似:
EUR 原式: V(Q) = U_current – Sum p(Ai|Q) * U_new(Ai) <- 需枚举所有可能答案,在线成本极高
工程近似: V(Q) ~ 严重度 x (1-清晰度) x (1-答案可预测性) x 严重度放大系数
最后那个因子"答案可预测性"是整套逻辑里最反直觉、也相当好用的一条:答案越可预测,问出来能减少的不确定就越少。
比如"你是不是要上周的?"——用户几乎必然回答"是",那么这个问题价值接近 0。别问,直接默认。
六、验证:两个公开数据集,抓出并修掉 3 个 bug
上面的机制听起来都挺顺。但"听起来顺"和"真的能用"之间,隔着一整个回测。这个技能做了两轮真实回测。
回测一:阈值该定在哪(Qulac,198 个多解读查询)
把 Qulac 里"一个查询有多个合理解读"的样本构造成待澄清任务,扫描阈值。
结论是:HIGH 落在 [0.30, 0.50] 时,该澄清的一个不漏,误问率 0%;一旦超过 0.50(比如 0.55),就开始漏掉"两个解读"的边界样本。默认 0.50 落在稳健带上沿,站得住。
回测二:追问几轮才够收敛(InfoQuest,1000 个场景)
InfoQuest 每个场景都带一份 5 项的必澄清清单。把清单当"必须问到的信息位",模拟多轮对话:每轮最多问 3 个,3 轮容量 9,覆盖 5 项后还留 4 项安全余量。
而原来的 2 轮(容量 6)虽然也能全部收敛,但一点余量都没有——任何需要澄清 7 项以上的真实任务都会被截断。
回测真正的价值:它抓出了三个"纸面上看不出来"的 bug
这三条都不是设计缺陷,而是"没跑过真实数据就发现不了"的实现缺陷。
这也正是回测的意义:它让"拍出来的数值"变成"验证过的数值"。
七、怎么用
技能是纯标准库实现的,装上就能跑,不需要额外依赖。
# 跑内置演示
python scripts/clarify_gate.py –demo
用样例任务跑闸门
python scripts/clarify_gate.py –task examples/office_email.json
回归测试(47 项断言)
python scripts/test_clarify_gate.py
实际接入时,上层 Agent 只需要做两件事:把请求拆成一组带标注的信息槽位(错了后果多严重、有没有可信默认值、能不能撤回),然后把槽位交给闸门。
拿到"该不该问 / 问什么 / 按什么顺序问"的判定后,再据此决定是直接干、带假设干、还是开口问。
无论走哪一档,都会产出一张回音卡——把 Agent 的理解摊开给用户看:
[我读到的] <- 从原话/上下文确定的,用户可以核对我有没有听错
[我猜的] <- 我用了默认值的,用户可以一键推翻
[我要做的] <- 我接下来打算干什么,用户可以喊停
[我不确定的] <- 风险敞口,用户知道哪里可能出问题
八、它好在哪
- 判据可计算,不靠感觉。三条量化判据(严重度、默认值可信度、答案可预测性)把"要不要问"从玄学变成算术,还能单测。
- 不只有"问"和"不问"。中间那档"默认值干 + 标注假设"是现实里非常大的一类请求——不确定,但完全可以带假设推进。二分法会把它误判成"必须问",Agent 就变啰嗦了。
- 红线优先于阈值。不可逆动作的关键参数缺失,无条件问,不看分数。这条是安全底线。
- 区分不确定类型,而不是一律问。该查的先去查,该声明的去做声明,只有真正需要用户拍板的部分才开口。
- 问过的不问第二遍。偏好槽位持久化,"同一个问题问两遍"是最让人恼火的一类失误。
- 有回测、有回归测试、有诚实边界。数值是拿公开数据集压出来的,每条修复都有守卫测试锁死。
九、局限与未来展望
诚实地说,它现在的边界很清楚:
- 只做判定,不做提问。引擎输出"该问什么、为什么问、按什么顺序问",真正向用户开口的是上层 Agent。
- "开放式问题只问一个"这条规则还没实现。引擎目前固定为"每轮不超过 3 问"。如果将来实现开放式收缩,追问上限需要同步上调到 5 轮以上才保留收敛能力——这个差距在文档里已明确标注,不藏着。
- 回测用的是协作型"oracle 用户"。被问到就如实回答,没有跑原版论文里的 LLM 用户模拟器和评判器。所以回测验证的是"轮次预算够不够收敛",不是"问出的问题贴不贴合真实需求"。
- 槽位是喂进去的。回测假设系统已经知道该澄清哪几项;"Agent 能否自己识别出正确的待澄清项"这件事,需要 LLM-in-the-loop 评测,还没做。
- 两个数据集都是代理。Qulac 是开放域搜索查询,InfoQuest 是隐藏上下文的对话场景,都不是 Agent 任务的原样。
下一步想做的:
- 把"开放式只问一个"真正实现,并让追问上限随发包策略自适应(发 3 个问题 = 少轮次;发 1 个开放问题 = 多轮次);
- 接一个真实 LLM 用户模拟器,做一轮端到端评测,补上"问题贴不贴合"这一环;
- 积累一批真实 Agent 任务的标注,反过来校准三类权重的具体数值。
参考论文(arXiv 前沿)
| InfoQuest: Evaluating Multi-Turn Dialogue Agents for Open-Ended Conversations with Hidden Context | de Oliveira B. L. M. et al. | 2502.12257 | 2025 | 所有主流模型在模糊请求上表现糟糕、常默认泛泛作答;1000 场景 / 每场景 5 项 checklist,是本文追问上限回测的数据来源 | 链接 |
| MAC: A Multi-Agent Framework for Interactive User Clarification in Multi-turn Conversations | Acikgoz E. C. et al. | 2512.13154 | 2025 | 双层澄清使任务成功率 54.5% 到 62.3%、轮数 6.53 到 4.86;支撑第二节"追问收益"与"该由谁问"的设计 | 链接 |
| Asking Clarifying Questions in Open-Domain Information-Seeking Conversations | Aliannejadi M. et al. | 1907.06554 | 2019 | Qulac 数据集:198 topic / 762 facet / 10K+ 问答对;只问一个好问题 P@1 提升超 170%,是本文阈值回测的数据来源 | 链接 |
| CLAM: Selective Clarification for Ambiguous Questions with Generative Language Models | Kuhn L. et al. | 2212.07769 | 2022 | "选择性澄清"的理论上游:模型很少主动澄清而直接给错答案;支撑第三节"区分该问与不该问" | 链接 |
动手之前先过一道闸门——该问的必问,不该问的闭嘴。
如果这篇对你有用,欢迎点个「收藏」,让更多做 Agent 的朋友看到;后续我会继续把"开放式澄清"那一环补上,并公开端到端评测结果。


评论前必须登录!
注册