 网硕互联帮助中心
👋 欢迎阅读
🔥 愿旖旎 · 个人主页
📘 学习专栏: 《算法专栏》《LangChain学习》《贪心算法》
🌄 钱塘江上潮信来,今日方知我是我
✨当前学习内容:LangGraph
📑 目录
-
一、前置讲解
-
二、LangChain 复盘与 LangGraph 引入
-
三、LangGraph 的核心概念
-
四、LangGraph 如何实现工作流
-
五、LangGraph 代码实现
-
六、复盘(附答案)
一、前置讲解
在进入正文前,先花 10 秒了解本篇会反复用到的核心概念,带着印象去读正文,学习效率更高。
🧠 前置知识一:Agent 与 Workflow
Agent 由 LLM 动态决策走向,Workflow 走预设流程,两者是两种编排思路。
📦 前置知识二:State(状态)
贯穿整个流程的共享数据,像快递包裹上的标签,所有节点都能读改。
🔵 前置知识三:Nodes(节点)
每个处理步骤就是一个函数:接收状态、返回状态更新。
➡️ 前置知识四:Edges(边)
节点之间的流动路径,分固定边与条件边。
🔁 前置知识五:Reducers(状态更新机制)
用 Annotated[类型, 合并函数] 决定新值是覆盖还是追加/累加。
二、LangChain 复盘与 LangGraph 引入
2.1 复盘
1. LangChain 基础与 RAG 流程
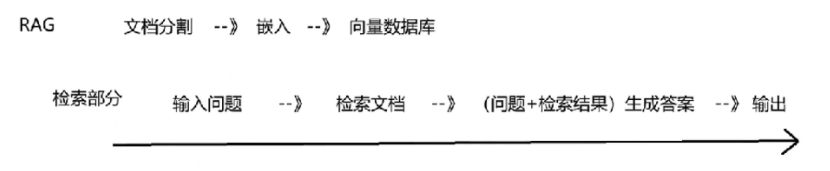
LangChain 是 AI 应用的基础框架,核心组件包括聊天模型、工具、文档加载器、检索器等,采用链式编程思维将步骤顺序串联。典型的 RAG(检索增强生成) 流程为:文档分割 → 嵌入 → 向量数据库;检索时用户输入问题 → 检索文档 →(问题+检索结果)生成答案 → 输出,这是最基本的 AI Demo 模式。
2. LangChain 链式编程的局限性与 LangGraph 的解决
链式流程线性且预先定义,难以处理分支、循环等复杂场景;在复杂 AI 系统中,常需人工介入处理异常(如缺少身份证信息时需人工补充),而链式遇到问题只能直接失败,无法暂停等待干预。
LangGraph 采用图式编程思维,将流程建模为图(节点和边),支持分支、循环、并行等复杂控制流,核心能力包括人工介入(可在流程中设置断点,暂停并等待人工输入或决策后继续)。
3. 学习路径
| LangChain | 掌握基础组件和链式编程,构建简单 Demo |
| LangGraph | 构建现代化复杂 AI 应用系统,包括编程思维提升和 AI 系统部署 |
简单说:LangChain 解决"怎么搭",LangGraph 解决"怎么搭得灵活、可靠且可维护"——实际项目中从简单链式起步,复杂场景升级为图式编排。
4. 总结:LangChain 阶段构建的 AI 系统特点
| 单次对话 | 无法长期记忆,上下文窗口有限 |
| 问答模式为主 | 交互较为直接 |
| 适用简单任务 | 如信息检索、基础问答 |
2.2 Agent Server(智能服务)
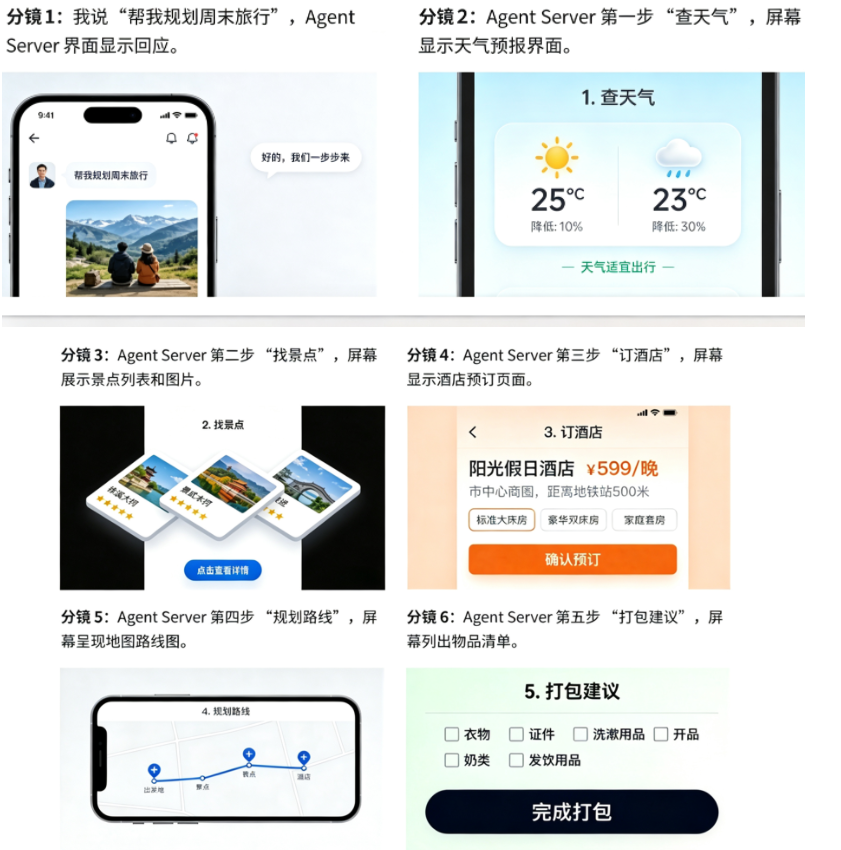
想象一个虚拟的"小助手",它不仅能回答问题,还能:
-
记住和你聊过的所有事情
-
执行一连串任务(如:查天气 → 推荐穿搭 → 提醒带伞)
-
中途可以等你给出反馈
-
长时间运行不会"忘记"
2.3 Agent Server 遇到的四大难题
| 状态丢失 | AI 处理长任务时容易"忘记"前面步骤 | 写长文章时电脑突然关机 |
| 难以调试 | 不知道 AI 为什么做出某个决定 | 黑盒子,看不到内部 |
| 无法干预 | 不能中途给 AI 指导 | 自动驾驶不能接管 |
| 部署困难 | 复杂 Agent Server 难以上线运行 | 手工制作 vs 工厂生产 |
2.4 LangGraph 的应对能力
1. 记忆大师
代码示例(对比语义):
# 传统AI:每次对话都是新的开始
AI回答("你好") → "你好!"
AI回答("我叫小明") → "很高兴认识你!"
AI回答("我叫什么?") → "我不知道你的名字"
# LangGraph Agent Server:记住一切
Agent Server("你好") → "你好!"
Agent Server("我叫小明") → "你好小明!"
Agent Server("我叫什么?") → "你叫小明!"
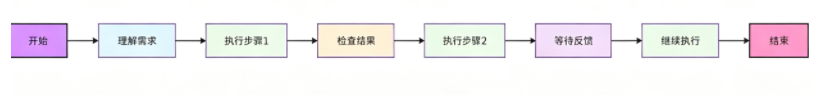
2. 流程清晰
3. 容错率高
| 持久执行 | 构建能从故障中恢复、长时间运行的 Agent Server |
| 人工介入 | 允许在流程中随时检查和修改 Agent Server 状态 |
| 强大的调试能力 | 与 LangSmith 集成,提供可视化追踪和深度洞察 |
| 生产就绪的部署 | 为有状态、长时工作流提供可扩展的部署方案 |
三、LangGraph 的核心概念
3.1 Agent(智能体)
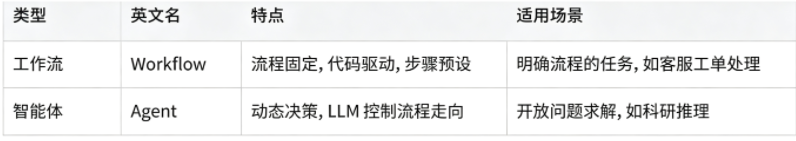
Agent(智能体) 是一个能够感知环境输入、自主决策、规划行动路径,并可调用工具或执行操作以达成目标的自主性软件实体。其核心在于:由大语言模型(LLM)动态控制流程走向。
想象你有一个超级聪明的程序员助手,你只需说一句:"把这个项目的单元测试覆盖率提升到 80%。" 然后他就自己去看代码、写测试、运行构建、检查结果……直到达标为止——中间不需要你插手。这个"能独立完成任务"的程序,就是我们所说的 Agent(智能体)。整个过程没有固定的流程图,而是它自己"想"出来的步骤——这就是典型的 Agent 行为。
3.2 Workflow(工作流)
Workflow(工作流) 是一个将复杂过程分解为定义明确、顺序执行的任务流程,并在其中自动化传递数据与任务状态,以完成特定目标。
如果说 Agent 是聪明的执行者,那工作流就是它的行动蓝图——它定义了"先做什么、后做什么、在什么条件下跳转或终止"。其核心在于:预设的、可重复的流程路径。
例如公司的报销流程:提交发票 → 领导审批 → 财务审核 → 财务结算 → 归档完成。
或一个自动化客服工单系统:用户提交问题 → 系统自动分类 → 分配给对应客服 → 客服处理 → 用户评价 → 工单关闭。
这种固定路径、整个过程沿预设流程运行,就是典型的工作流行为。LangGraph 实现的正是工作流!
3.3 工作流和 Agent 的区别
四、LangGraph 如何实现工作流
4.1 理论
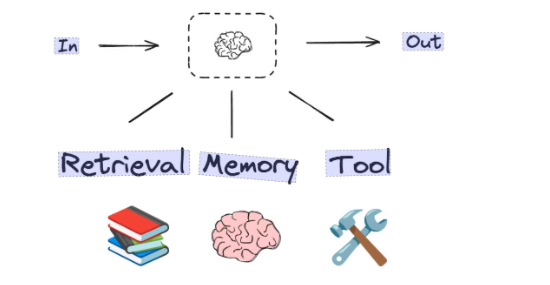
在 LangGraph 中,工作流基于 LLM 以及添加到其中的各种增强功能(如工具调用、结构化输出和短期记忆)而实现。
再次强调:LangGraph 是一个强大且灵活的 "Agent Server 操作系统内核"。它不关心我们具体用什么模型或提示词,而是为我们解决构建复杂、可靠、可交互的 Agent Server 时所面临的状态管理、流程编排、持久化和人工监督等底层工程难题。
4.2 理解图
如何实现工作流逻辑?图计算是一种用节点和边来表示复杂系统的方法。在 AI 领域,它特别适合构建多步骤、有状态的智能工作流。
想象一个快递配送系统,下图展示了包裹从输入(揽收站) 到输出(配送站) 的过程: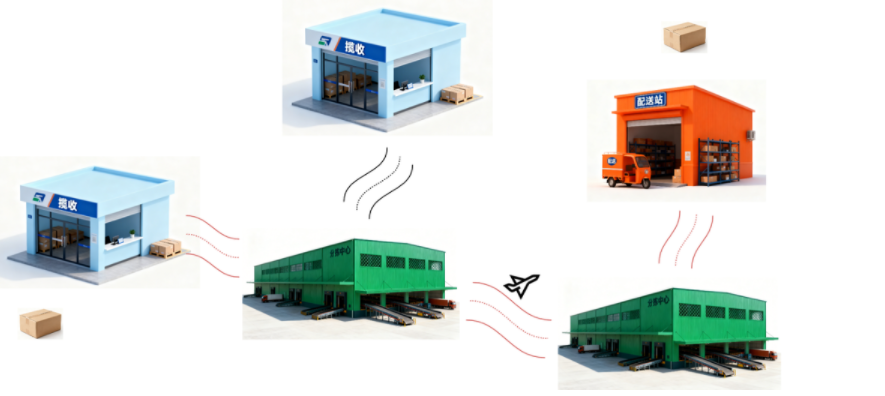
| 配送站、揽收站、分拣中心 | 节点(Node) |
| 运输路线 | 边(Edge) |
| 包裹信息 | 状态(State) |
| 完整配送网 | 图(Graph) |
4.3 工作流的核心概念
State(状态)
State 就像快递包裹上的标签,记录着包裹的当前位置、目的地、配送状态等信息。在整个配送过程中,所有站点都能查看和更新这个信息。(因此你可以理解为类的公共属性)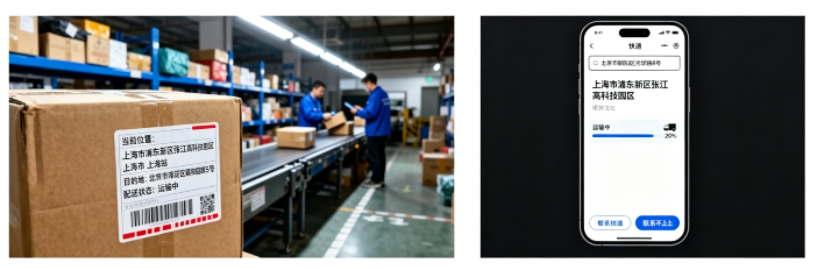
状态特性:
| 共享性 | 所有节点(快递站点) 都能读取和修改 |
| 持久性 | 在整个工作流(快递运输) 执行期间持续存在 |
| 结构化 | 有明确的字段定义 |
代码示例:
from typing import TypedDict
class PackageState(TypedDict):
# 包裹基本信息
package_id: str # 包裹id
origin: str # 始发站
destination: str # 目的地
# 配送状态
status: str # "待揽收", "运输中", "派送中", "已签收"
history: list[str] # 流转历史(字符串列表),列表中的每个字符串记录一次状态变更
total_distance: int # 总里程
# 配送详情
priority: str # "普通", "加急"
Nodes(节点)
节点就像快递配送网络中的各个站点,每个站点负责特定的处理步骤:
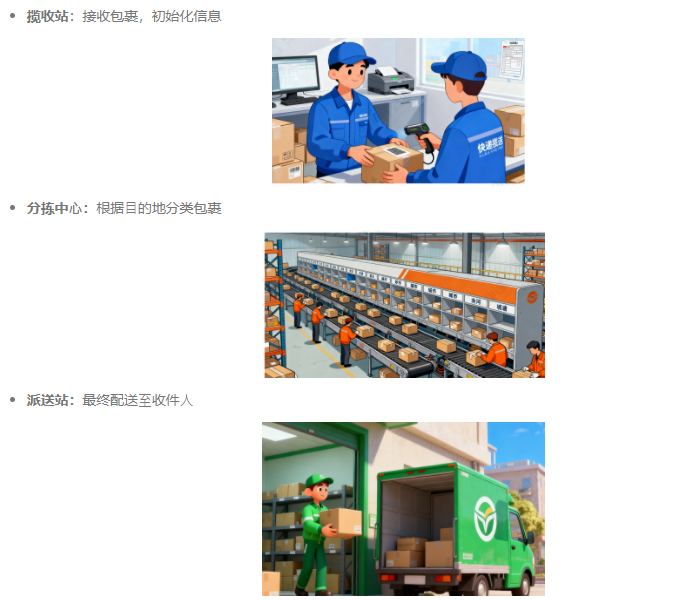
节点特征:
| 单一职责 | 每个节点只做一件事 |
| 输入输出 | 接收状态,返回状态更新 |
| 独立性 | 节点间不直接通信,通过 State 交互 |
代码示例:
def receive_package(state: PackageState):
"""
揽收站处理函数。
将包裹状态更新为"已揽收",并记录揽收地点(取自 state 的 origin 字段)。
Args:
state (PackageState): 当前包裹状态字典。
Returns:
dict: 更新后的状态字段,包括 status 和 history。
"""
return {
"status": "已揽收",
"history": [f"在{state['origin']}揽收"], # 记录揽收地点
}
def sort_package(state: PackageState):
"""
分拣中心处理函数。
根据 destination(目的地)将包裹分拣到对应的分拣中心。
Args:
state (PackageState): 当前包裹状态字典。
Returns:
dict: 更新后的状态字段,包括 status 和 history。
"""
# 从当前状态字典中提取目标地址,用于决定分拣方向
destination = state["destination"] # 获取目的地字符串,如 "北京朝阳区"
if "北京" in destination:
next_station = "北京分拣中心"
elif "上海" in destination:
next_station = "上海分拣中心"
else:
next_station = "其他地区分拣中心"
return {
"status": "已分拣",
"history": [f"分拣至{next_station}"], # 记录分拣结果
}
def final_delivery(state: PackageState):
"""
派送站处理函数。
将包裹状态更新为"已签收",并记录送达目的地。
Args:
state (PackageState): 当前包裹状态字典。
Returns:
dict: 更新后的状态字段,包括 status 和 history。
"""
return {
"status": "已签收",
"history": [f"已送达{state['destination']}"], # 记录送达地址
}
Edges(边)
边定义了包裹在站点之间的流动路径,就像快递公司的运输路线图:
| 开始/结束边 | 流程的开始和结束点 | 包裹的起始站与终点站 |
| 固定边 | 总是从 A 到 B | 揽收站 → 分拣中心(所有包裹都走) |
| 条件边 | 根据状态决定下一步 | 按目的地选择不同分拣中心 |
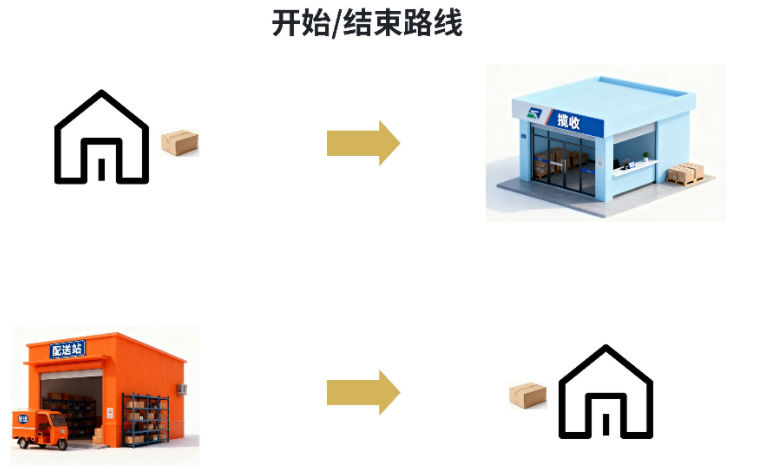
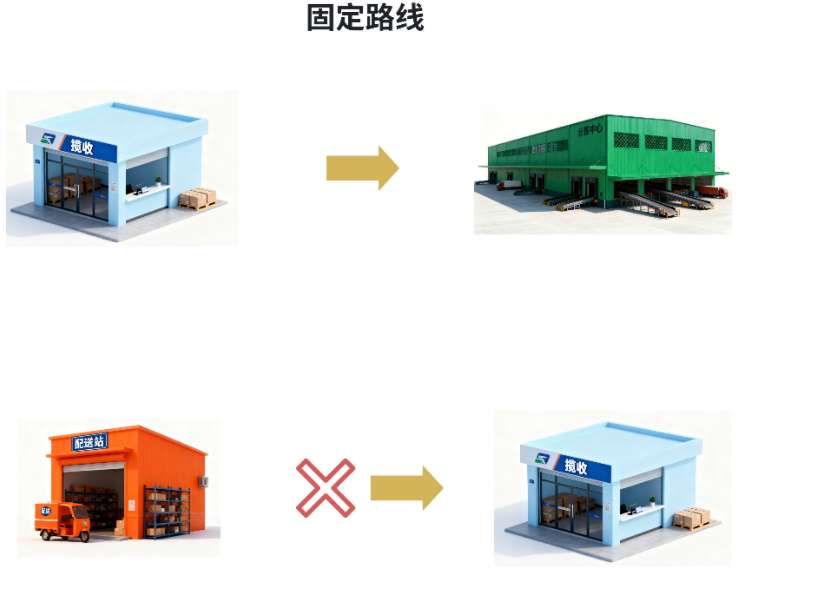
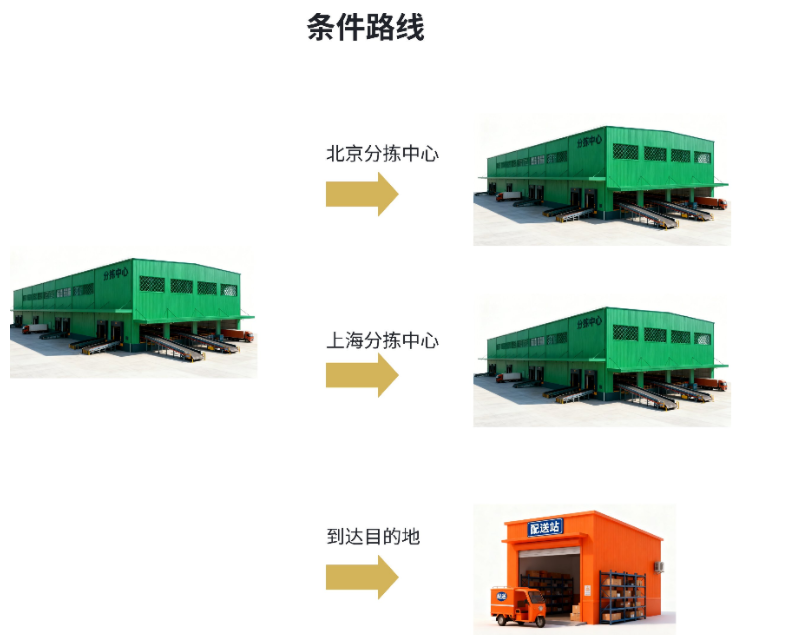
因此,LangGraph 通过节点(每个处理步骤)、边(步骤之间的连接)和状态(保存执行过程),即可构建出一个任务工作流(图)。
五、LangGraph 代码实现
步骤1:定义 State,设置快递的"包裹信息"
from typing import TypedDict, Annotated
from operator import add
# 1. 定义包裹状态
class PackageState(TypedDict):
# 包裹基本信息
package_id: str # 包裹 ID
origin: str # 始发站
destination: str # 目的地
# 配送状态
status: str # "待揽收", "运输中", "派送中", "已签收"
history: Annotated[list[str], add] # 流转历史(自动追加)
total_distance: Annotated[int, add] # 总里程(自动累加)
# 配送详情
priority: str # "普通", "加急"
【知识点】State 更新机制:Reducers
状态支持更新的关键是 Reducers。示例中使用 Annotated 类型为 history 和 total_distance 指定了 Reducer 函数(operator.add),定义了如何更新包裹信息——特别是当多个站点都要记录信息时,新值会追加到现有值中,而不是替换:
| status: str | 覆盖更新:每次新状态替换旧状态 |
| history: Annotated[list[str], add] | 追加更新:新的流转记录添加到历史列表 |
| total_distance: Annotated[int, add] | 数值累加:里程数累加 |
步骤2:定义 StateGraph 图,成立快递公司
-
StateGraph 是一个有状态图计算框架,基于有向图(Directed Graph) 模型构建,专门设计用于处理多步骤、有状态的工作流程。
-
StateGraph 用于将复杂的工作流程可视化、模块化,让开发者能够像设计快递配送网络一样设计软件系统。
-
需要使用 langgraph.graph.state.StateGraph 来定义。StateGraph 仅是一个构建器类,可以使用 State 来构建。
代码示例:
from langgraph.graph import StateGraph
# 2. 成立快递公司
delivery = StateGraph(PackageState)
步骤3:定义 Nodes,创建配送站点
在 LangGraph 中,节点就是一个 Python 函数(同步或异步)。注意:
-
节点接收状态作为参数
-
节点不需要返回整个状态模式,只需返回一个更新(即状态的部分字段)
代码示例:
# ========== 配送站点函数 ==========
# 这些函数模拟了包裹在配送流程中经过的不同站点(状态节点)
# 每个函数接收一个 PackageState 字典,并返回更新后的状态字段
def receive_package(state: PackageState):
"""
揽收站处理函数。
将包裹状态更新为"已揽收",并记录揽收地点(来自 state 的 origin 字段)。
"""
return {
"status": "已揽收",
"history": [f"在{state['origin']}揽收"], # 记录揽收地点
}
def sort_package(state: PackageState):
"""
分拣中心处理函数。
根据目的地(destination)将包裹分拣到对应的分拣中心。
"""
destination = state["destination"] # 获取目的地字符串
if "北京" in destination:
next_station = "北京分拣中心"
elif "上海" in destination:
next_station = "上海分拣中心"
else:
next_station = "其他地区分拣中心"
return {
"status": "已分拣",
"history": [f"分拣至{next_station}"], # 记录分拣结果
}
def final_delivery(state: PackageState):
"""
派送站处理函数。
将包裹状态更新为"已签收",并记录送达地址(来自 state 的 destination 字段)。
"""
return {
"status": "已签收",
"history": [f"已送达{state['destination']}"], # 记录送达地址
}
步骤4:添加 Nodes,建设配送站点
将各节点组织进图中——使用 add_node() 将新节点添加到 StateGraph。
add_node() 常用参数:
| node | 字符串 或 StateNode 对象 | 指定节点要运行的函数或可执行对象。传字符串时该字符串作为节点名称,此时用 action 参数作为实际执行函数;传 StateNode 对象时直接使用该对象定义节点 |
| action | StateNode 对象或 None(默认) | 定义与节点关联的动作(执行逻辑)。node 是字符串时 action 作为实际执行函数;node 已是 StateNode 时通常为 None |
代码示例:
# 4. 添加配送站点
delivery.add_node("揽收站", receive_package)
delivery.add_node("分拣中心", sort_package)
delivery.add_node("派送站", final_delivery)
步骤5:添加 Edges,规划运输路线
各节点(站点) 准备好后,则需要为快递流转规划路线(边)。
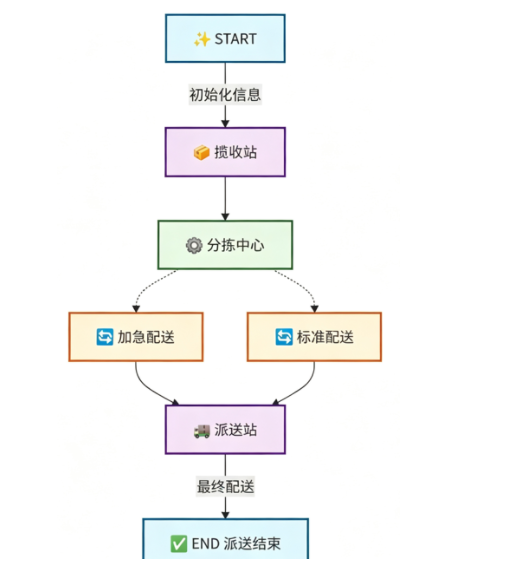
在 LangGraph 中:
| START 节点 | 特殊节点,表示将用户输入发送到图的节点,用于确定应该首先调用哪些节点 |
| END 节点 | 表示终端节点,指示哪些边在完成后没有后续动作 |
| 条件入口点 | 调用一个函数来确定用户输入到达时首先调用哪个节点 |
add_edge() 常用参数(固定边):
| start_key | 字符串 或 字符串列表 | 边的起始节点的键 |
| end_key | 字符串 | 边的结束节点的键 |
add_conditional_edges() 常用参数(条件边):
| source | 字符串 | 起始节点。退出此节点时,将运行此条件边 |
| path | Callable 或 Runnable | 决定下一个节点或多个节点的方法。未指定 path_map 时应返回一个或多个节点;返回 "END" 时图将停止执行 |
| path_map | 字典 / 字符串列表 / None | 【可选】将路径映射到节点名。省略时,path 返回的路径应为节点名 |
代码示例:
# ========== 新增节点 ==========
def standard_delivery(state: PackageState):
"""
标准配送节点。
将包裹状态更新为"运输中",记录标准陆运,总里程设为 500。
"""
return {
"status": "运输中",
"history": ["标准陆运"],
"total_distance": 500,
}
def express_delivery(state: PackageState):
"""
加急配送节点。
将包裹状态更新为"加急运输",记录空运加急,总里程设为 800。
"""
return {
"status": "加急运输",
"history": ["空运加急"],
"total_distance": 800,
}
# ========== 4. 添加配送站点 ==========
delivery.add_node("揽收站", receive_package)
delivery.add_node("分拣中心", sort_package)
delivery.add_node("标准配送", standard_delivery)
delivery.add_node("加急配送", express_delivery)
delivery.add_node("派送站", final_delivery)
# ========== 5. 设计配送路线 ==========
delivery.add_edge(START, "揽收站")
delivery.add_edge("揽收站", "分拣中心")
# 智能路由:根据优先级选择配送方式
def select_delivery(state: PackageState):
"""
智能路由决策函数。
根据包裹的 priority 字段决定下一步进入哪个配送节点:
– 若为 "加急",则进入 "加急配送"
– 否则进入 "标准配送"
Returns:
str: 下一个节点的名称。
"""
if state["priority"] == "加急":
return "加急配送"
else:
return "标准配送"
# 添加条件边:
# – source: 从 "分拣中心" 节点退出时触发
# – path: 调用 select_delivery 决定下一个节点
# – path_map: 明确列出所有可能的返回值(用于校验和可视化)
delivery.add_conditional_edges(
"分拣中心", # source:起始节点
select_delivery, # path:确定下一个节点的可调用对象
["加急配送", "标准配送"], # path_map:可能的返回值列表
)
delivery.add_edge("标准配送", "派送站")
delivery.add_edge("加急配送", "派送站")
delivery.add_edge("派送站", END)
步骤6:编译图,从公司创建到运行
在步骤2中,我们仅是构建出 StateGraph,还无法直接用于执行。LangGraph 要求:必须先编译图,然后才能使用它。编译提供了对图结构的一些基本检查,会验证:
| 可达性(TOP) | 从 START 到所有节点的可达性 |
| 可达性(BOTTOM) | 从所有节点到 END 的可达性 |
| 结构完整性 | 没有孤立节点或死循环 |
使用 compile() 方法即可编译图,将 StateGraph 编译为 CompiledStateGraph 对象。编译后的图实现了 Runnable 接口,可以异步调用、流式传输、批处理和运行。
代码示例:
# 6. 编译系统
delivery_system = delivery.compile()
完整代码
from typing import TypedDict, Annotated
from operator import add
from langgraph.graph import StateGraph, START, END
# ========== 1. 定义包裹状态 ==========
class PackageState(TypedDict):
"""包裹在整个配送流程中的状态数据结构。"""
# 包裹基本信息
package_id: str # 包裹 ID
origin: str # 始发站
destination: str # 目的地
# 配送状态
status: str # "待揽收", "运输中", "派送中", "已签收"
# Annotated[list[str], add] 表示该字段做状态更新时用 add 函数合并(追加而非覆盖)
history: Annotated[list[str], add] # 流转历史(自动追加)
# 同理,int 类型使用 add 会将新旧值累加
total_distance: Annotated[int, add] # 总里程(自动累加)
# 配送详情
priority: str # "普通", "加急"
# ========== 2. 成立快递公司(创建状态图) ==========
delivery = StateGraph(PackageState)
# ========== 3. 定义各个配送站点函数 ==========
def receive_package(state: PackageState):
"""揽收站:更新为"已揽收",记录揽收地点。"""
return {
"status": "已揽收",
"history": [f"在{state['origin']}揽收"],
}
def sort_package(state: PackageState):
"""分拣中心:按目的地分拣。"""
destination = state["destination"]
if "北京" in destination:
next_station = "北京分拣中心"
elif "上海" in destination:
next_station = "上海分拣中心"
else:
next_station = "其他地区分拣中心"
return {
"status": "已分拣",
"history": [f"分拣至{next_station}"],
}
def standard_delivery(state: PackageState):
"""标准配送:运输中,总里程 500。"""
return {
"status": "运输中",
"history": ["标准陆运"],
"total_distance": 500,
}
def express_delivery(state: PackageState):
"""加急配送:加急运输,总里程 800。"""
return {
"status": "加急运输",
"history": ["空运加急"],
"total_distance": 800,
}
def final_delivery(state: PackageState):
"""派送站:更新为"已签收",记录送达地址。"""
return {
"status": "已签收",
"history": [f"已送达{state['destination']}"],
}
# ========== 4. 添加配送站点(节点) ==========
delivery.add_node("揽收站", receive_package)
delivery.add_node("分拣中心", sort_package) # 注意:统一使用 "分拣中心"(避免异体字)
delivery.add_node("标准配送", standard_delivery)
delivery.add_node("加急配送", express_delivery)
delivery.add_node("派送站", final_delivery)
# ========== 5. 设计配送路线(边) ==========
def select_delivery(state: PackageState):
"""智能路由:按 priority 决定走加急还是标准配送。"""
if state["priority"] == "加急":
return "加急配送"
else:
return "标准配送"
# 顺序边:START → 揽收站 → 分拣中心
delivery.add_edge(START, "揽收站")
delivery.add_edge("揽收站", "分拣中心")
# 条件边:从 "分拣中心" 出发,由 select_delivery 决定下一步
delivery.add_conditional_edges(
"分拣中心", # source:起始节点
select_delivery, # path:确定下一个节点的可调用对象
["加急配送", "标准配送"], # path_map:可能的返回值列表
)
# 两条配送路径都汇入派送站,最后结束
delivery.add_edge("标准配送", "派送站")
delivery.add_edge("加急配送", "派送站")
delivery.add_edge("派送站", END)
# ========== 6. 编译系统 ==========
delivery_system = delivery.compile()
测试代码
# ========== 测试配送 ==========
# 准备两个测试包裹,分别对应"普通"和"加急"两种优先级
test_packages = [
{
"package_id": "P001",
"origin": "北京",
"destination": "上海",
"priority": "普通",
"history": [], # 初始流转历史为空
"total_distance": 0, # 初始总里程为 0
},
{
"package_id": "P002",
"origin": "广州",
"destination": "乌鲁木齐",
"priority": "加急",
"history": [],
"total_distance": 0,
},
]
# 遍历每个测试包裹,调用编译好的配送系统,打印最终状态、历史和总里程
for package in test_packages:
print(f"\\n配送包裹: {package['package_id']}")
result = delivery_system.invoke(package)
print("最终状态:", result["status"])
print("配送历史:", result["history"])
print("总里程:", result["total_distance"])
预期运行结果:
配送包裹: P001
最终状态: 已签收
配送历史: ['在北京揽收', '分拣至上海分拣中心', '标准陆运', '已送达上海']
总里程: 500
配送包裹: P002
最终状态: 已签收
配送历史: ['在广州揽收', '分拣至其他地区分拣中心', '空运加急', '已送达乌鲁木齐']
总里程: 800
💡 注意 history 是追加而非覆盖(靠 Reducer add),所以能看到完整的流转链路;total_distance 同理累加。
六、复盘(附答案)
💡 思考题
LangChain 链式编程有什么局限性?LangGraph 如何解决?
Agent(智能体)和 Workflow(工作流)的区别是什么?LangGraph 实现的是哪一个?
State、Nodes、Edges 分别是什么?请用快递配送的例子说明。
Reducers 是什么?Annotated[list[str], add] 和 status: str 在更新行为上有什么区别?
为什么图必须先 compile() 才能执行?编译会做哪些检查?
📝 答案
链式流程线性且预先定义,难以处理分支、循环等复杂场景;遇到异常只能直接失败,无法暂停等待人工介入。LangGraph 用图式编程思维:将流程建模为图(节点 + 边),支持分支、循环、并行等复杂控制流,并支持人工介入(设置断点暂停、等人工决策后继续)。
Workflow 走预设的、可重复的流程路径(如报销审批、客服工单),适合明确流程的任务;Agent 由大模型动态控制流程走向,灵活度高(如让 AI 自己想办法把单测覆盖率提到 80%)。LangGraph 实现的是工作流(Workflow)。
State = 快递包裹上的标签(贯穿全程的共享数据,所有节点可读可改,有结构化字段定义);Nodes = 揽收站/分拣中心/派送站(每个节点是一个函数,单一职责,接收状态、返回状态更新,节点间不直接通信);Edges = 运输路线(固定边如"揽收站→分拣中心",条件边如按目的地/优先级选择下一步,另有 START/END 特殊节点)。
Reducers 是状态更新的关键机制,用 Annotated[类型, 合并函数] 指定如何合并新值。status: str 是覆盖更新(新值替换旧值);Annotated[list[str], add] 是追加更新(新记录追加进列表);Annotated[int, add] 则做数值累加(多站点的里程会累加而不是互相覆盖)。
因为 StateGraph 只是构建器类,不能直接执行;compile() 会把它编译成 CompiledStateGraph(实现 Runnable 接口,支持异步调用、流式、批处理)。编译时做结构检查:START 到所有节点的可达性、所有节点到 END 的可达性、没有孤立节点或死循环。
🎯 闭幕
如果本文对你有帮助,欢迎:
👍 点赞 | ⭐ 收藏 | 👤 关注作者 | 💬 留言交流你的疑问或补充
你的每一次互动都是我继续更新的动力,我们下一篇见!🚀


评论前必须登录!
注册