 网硕互联帮助中心
2.2
拓扑特性分析
BalanceMode
的配置将
GPU
平均挂接 在
2
个
CPU
下
,GPU PCIe
总的上行带宽较高
;Com
monMode
在一定程度上能够满足
GPU
之间点对
点的通信
,
同时可保障足够的
CPU
与
GPU
之间
的
I/O
带宽
;Cascade Mode
只有一条
×16
链路
,
但由于
GPU
之间通过
PCIeSwitch
串接
,
提升了
点对点的性能
,
降低了延迟
。
对于双精度浮点运算
,
因
GPU
计算需要使用
处理器与主内存
,
由于
Dualroot
的拓扑上行带宽
与内存使用率提升
,
其性能会优于
Singleroot
的
拓扑
。
对于深度学习推理性能来说
,
具备并行计算能
力的
GPU
可以基于训练过的网络进行数十亿次
的计算
,
从而快速识别出已知的模式或目标
。
不同
拓扑下
GPU
的互联关系不同
,GPU
之间的沟通会
影响深度学习推理的整体性能
。
3
实验及结果分析
3.1
实验装置
为探究在不同应用条件下
3种拓扑的性能差
异
,
实验使用自研
AI
服务器
(NF5468M5)
搭建机
台进行测试
。
装置使用
2
颗
CPU,
规格为
IntelⓇ
XeonⓇ Gold6142,
主频为
2.60GHz;
使用
12
条
DDR4
内存
,
容量为
32GB,
主频为
2666 MHz;
使
用
8
颗
GPU,
规格为
NVIDIA Tesla-V100_32G。
3.2
实验结果分析
3.2.1
点对点带宽与延迟
对于
GPU
的
P2P
性能
,
可以使用带宽与延迟
来衡量
。PCIe3.0
的带宽为
16GB/s,
理想状况
下
,
实际应用中带宽可以达到理论带宽的
80%
左
右
。PCIe
的延迟主要取决于
PCIeTrace
的长度
、
走线路径 上 的 器 件 及 是 否 经 过
UPI、
是 否 跨
RC
(RootComplex)
等
。
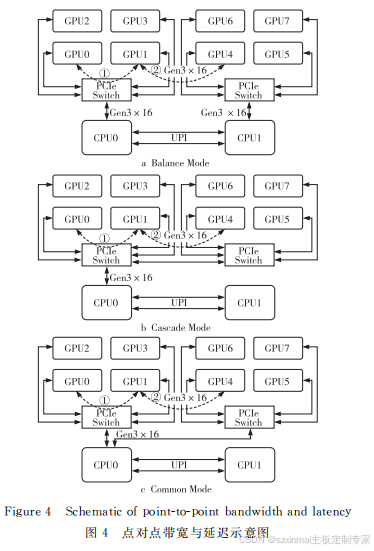
如图
4
所示
,
在
BalanceMode、CascadeMode
和
CommonMode3
种拓扑中
,
分别测试挂在同一
个
PCIeSwitch
下的
GPU (
如图
4
中线路
①)
和跨
PCIeSwitch
的
GPU(
如图
4
中线路
②)
的点对点
带宽与延迟
。
测试结果如表
1、
表
2
及图
5
所示
。
在同一个
PCIeSwitch
下
,
由于
GPU
之间的
传输距离是一样的
,
所以在点对点回路
①
中
,3
种
拓扑的带宽与延迟结果皆相近
;
对于跨
PCIeSwitc
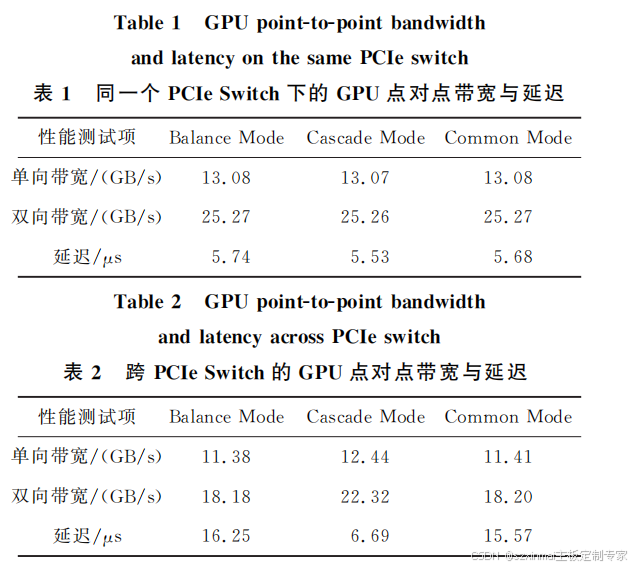
的
2
颗
GPU,
由于
CPU
间为
3UPILinks,
其信号
传输速度足够快
,
所以
BalanceMode
与
Common
Mode
的 结 果 相 近
,
而 对 于
Cascade Mode,
由 于
GPU
之间的沟通只需经过
PCIeSwitch,
传输路径
变短
,
其点对点延迟性能得以提升
;
同时
,
对于
In
telCPU
而言
,
一个
PCIe×16Port
为一个
RC,
不
同
RC
之 间 的 通 信 带 宽 比 同 一 个
RC
下
PCIe
Switch
之间的通信差
,
故
CascadeMode
的带宽也
得以提升
。
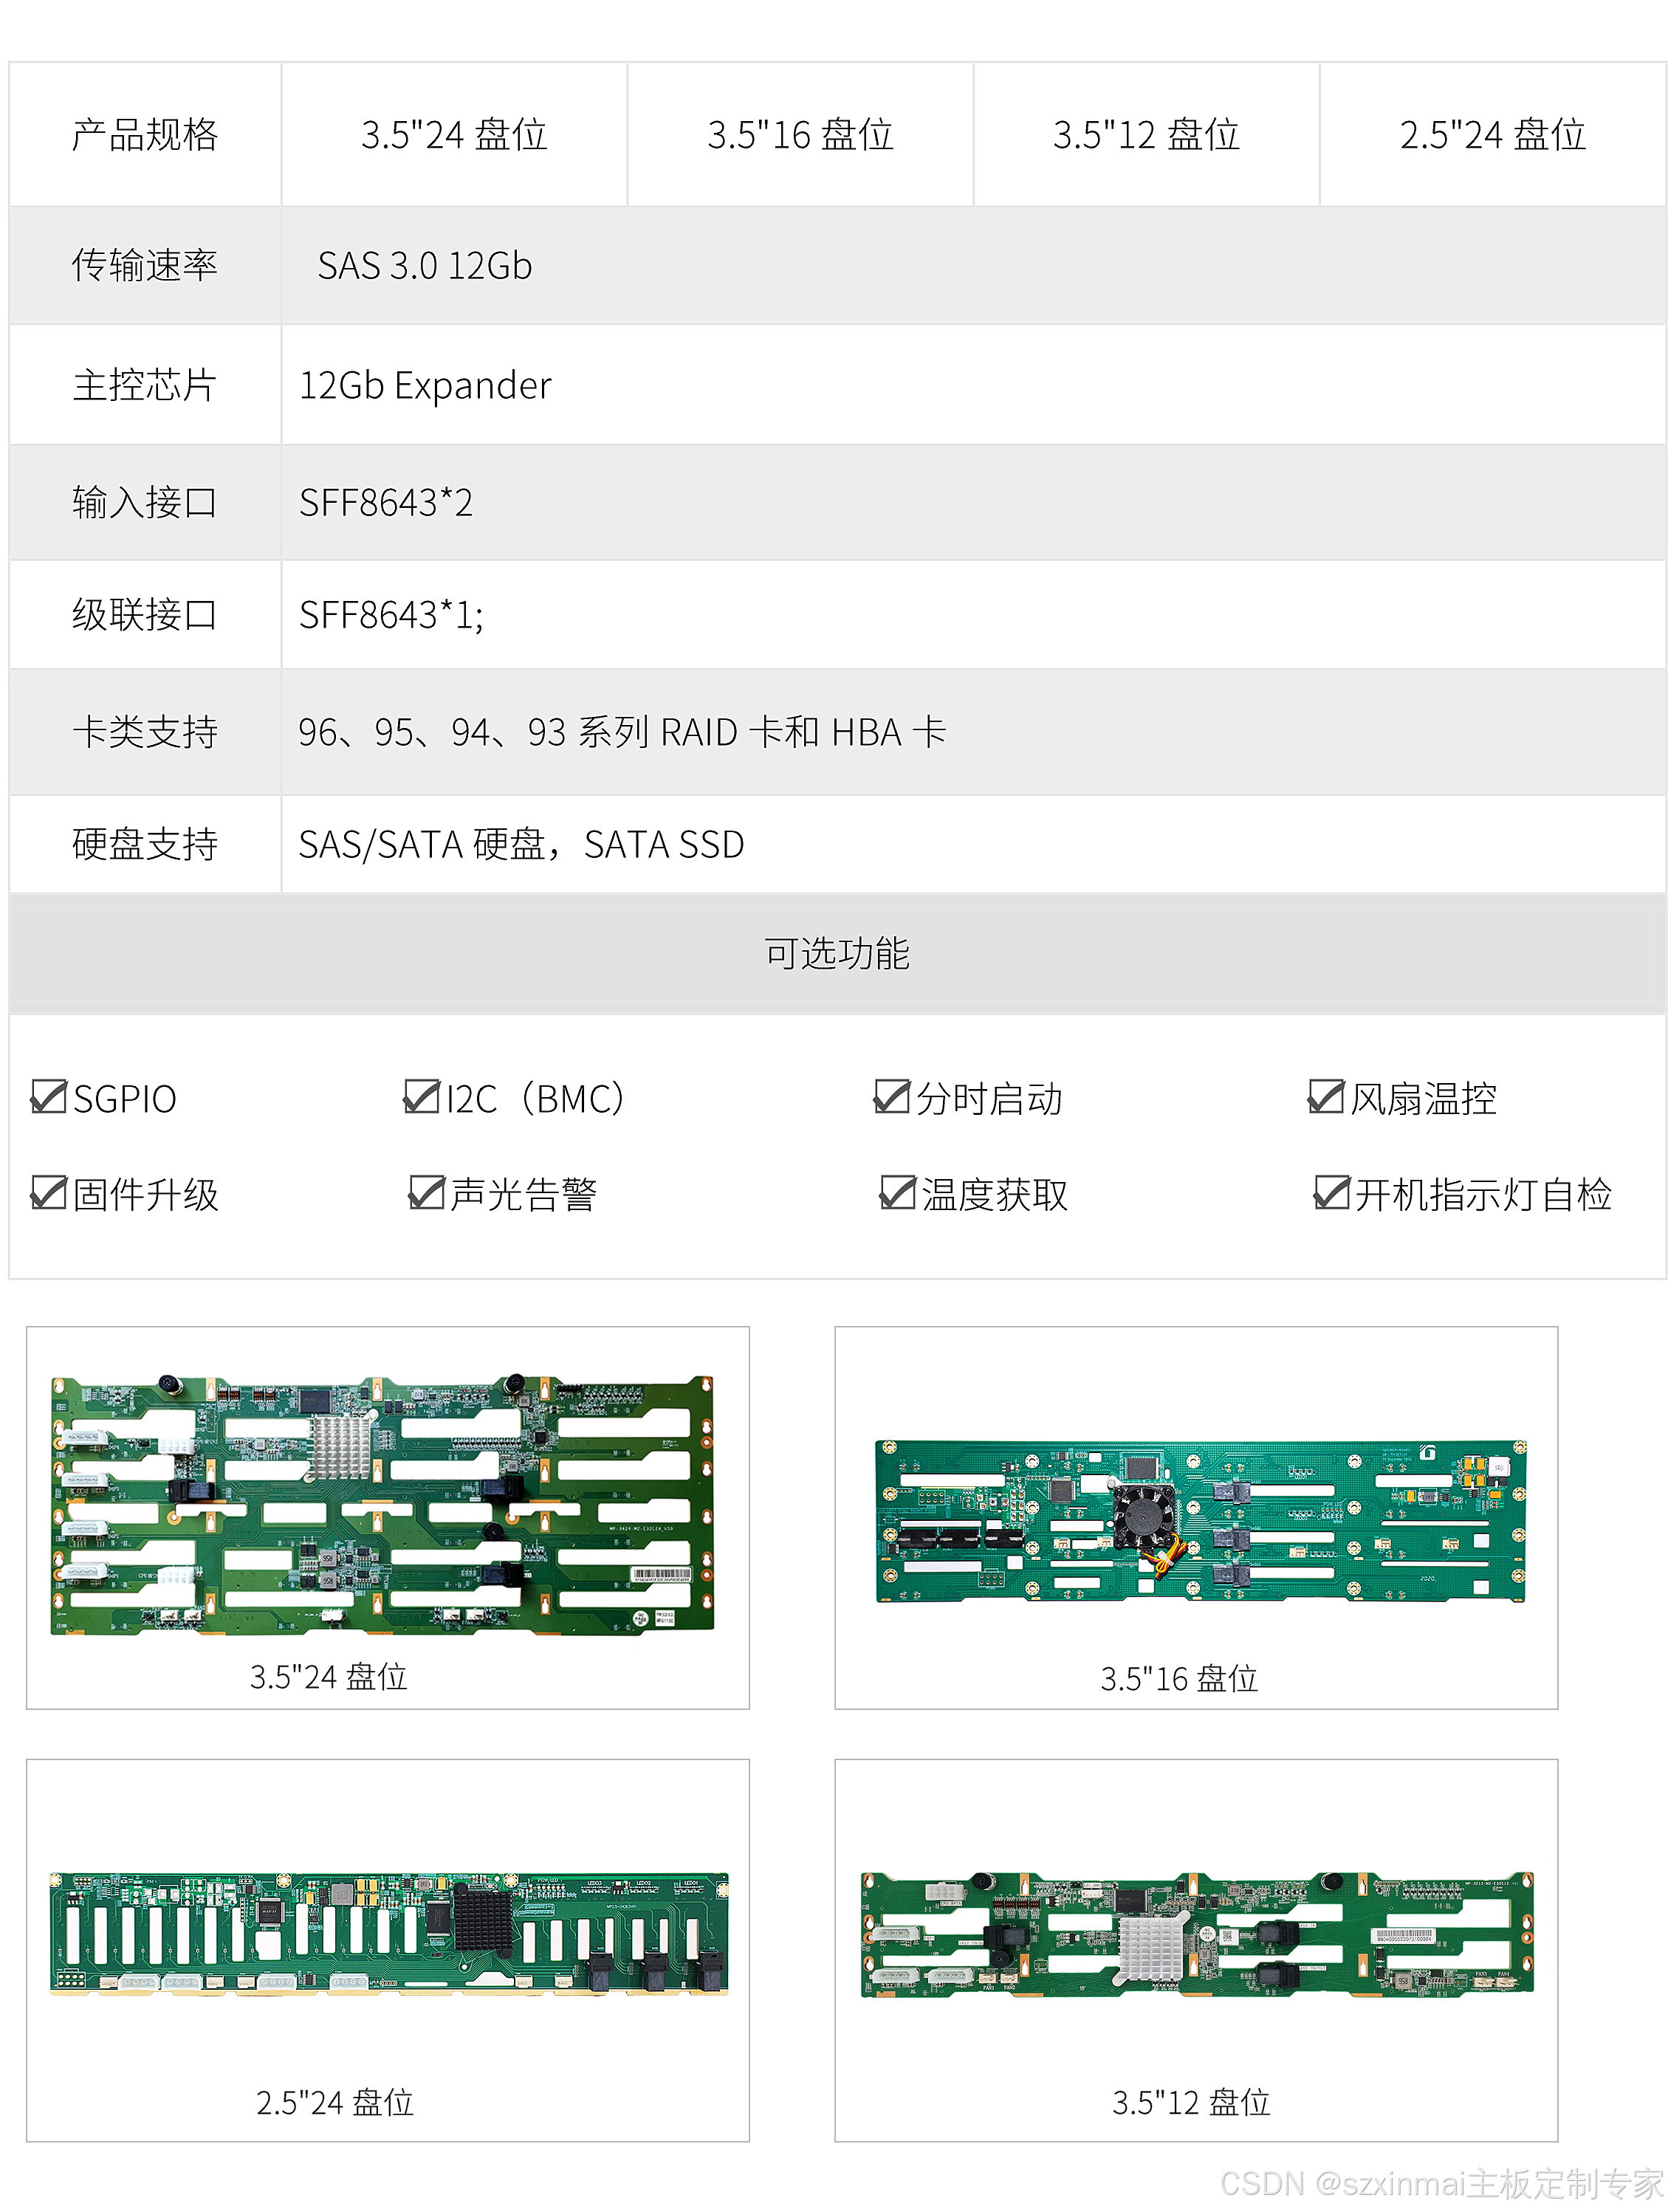
=========12Gb SAS Expander多盘位背板================
*硬盘热插拔功能;
*灯态支持硬盘上电,读写,报错;
*SPGIO硬盘报错功能;
*硬盘分时启动;
*风扇温度控制;
* I2C(BMC);


评论前必须登录!
注册