 网硕互联帮助中心
数据仓库介绍
将各个业务系统数据库中的数据,抽取到一个大的数据库(数据仓库),相当于可以将各个业务系统的数据整合到一起,然后对其中的数据进行加工分析处理,也方便后续关联查询。
例如:如果有的业务需要查询两个不同的业务库,没有数据仓库这个中转站,是办不到的。
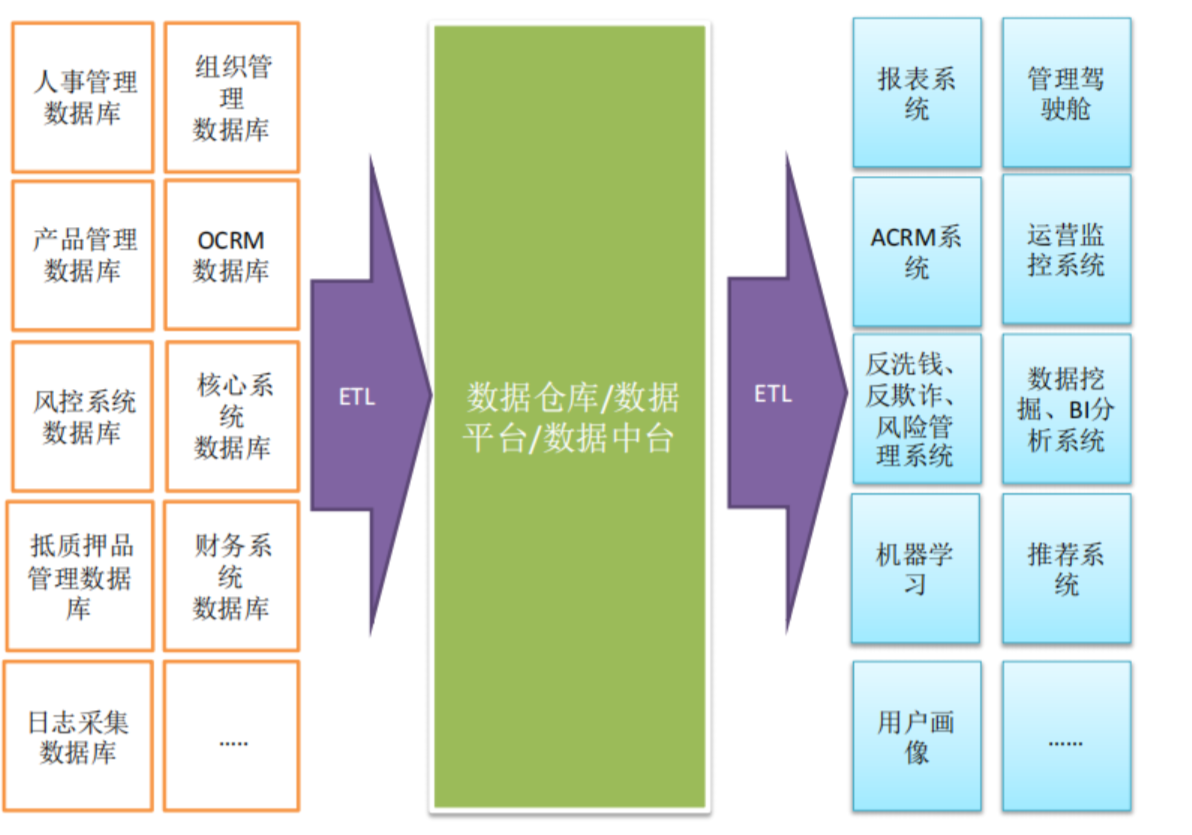
数据仓库架构
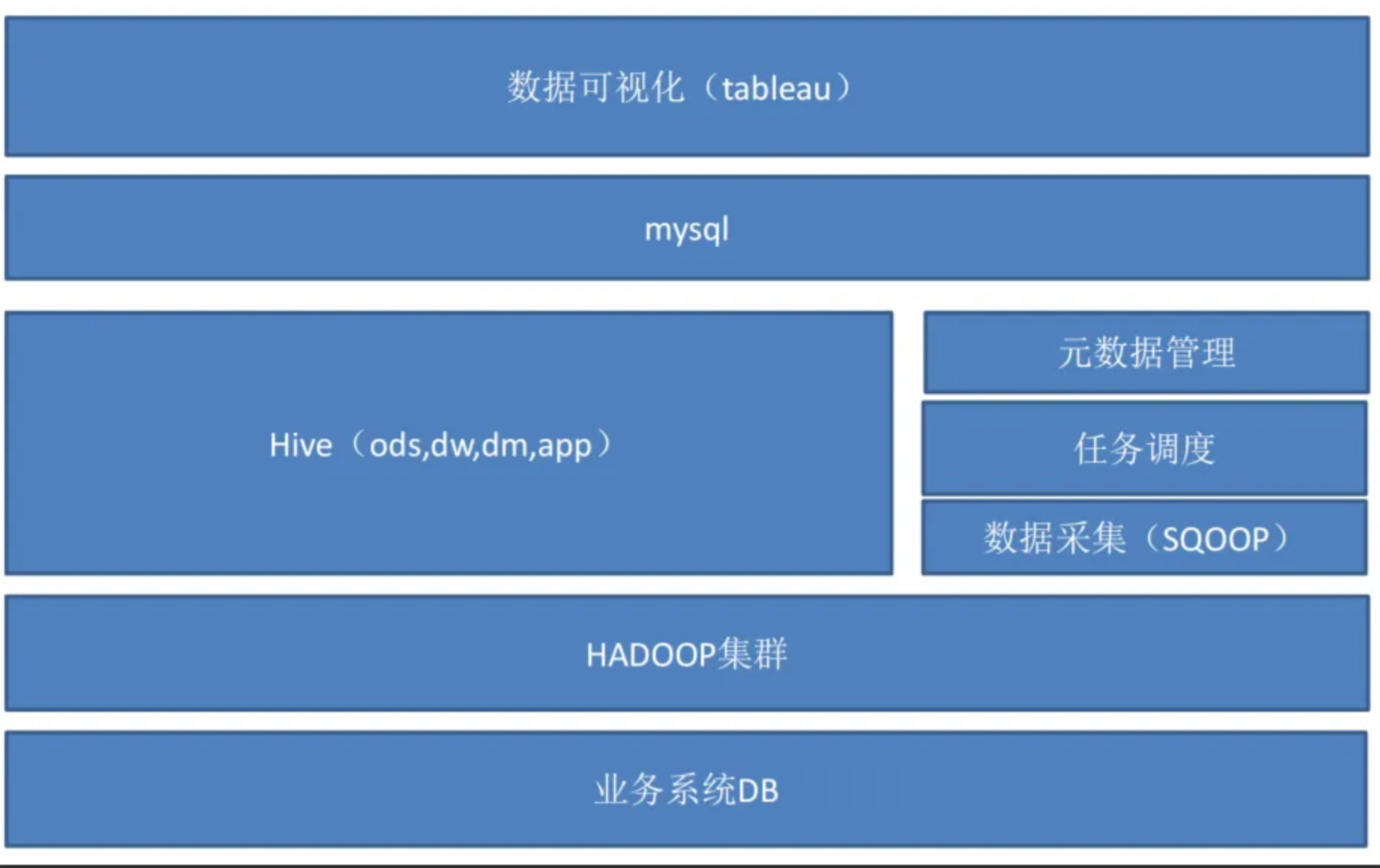
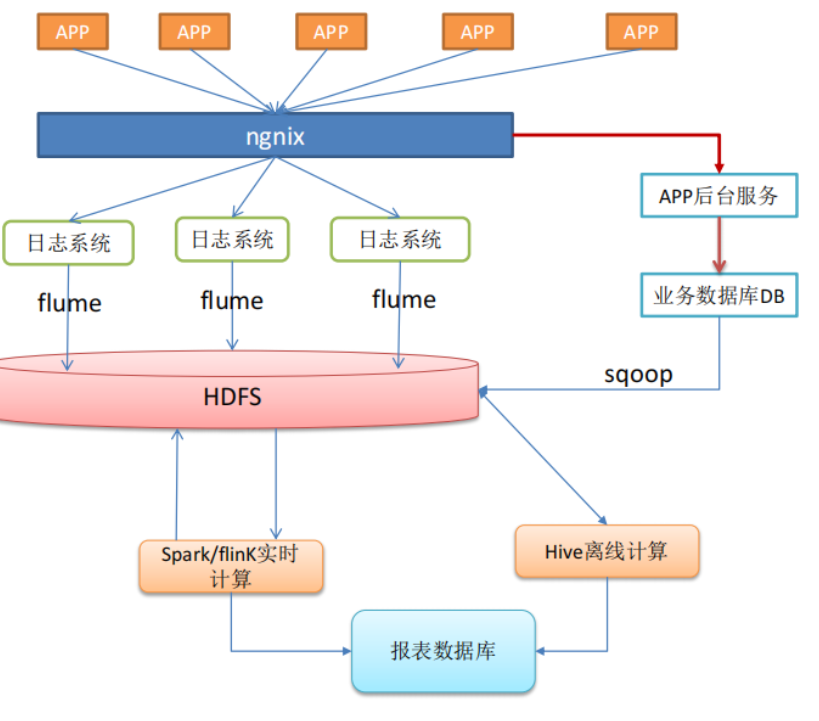
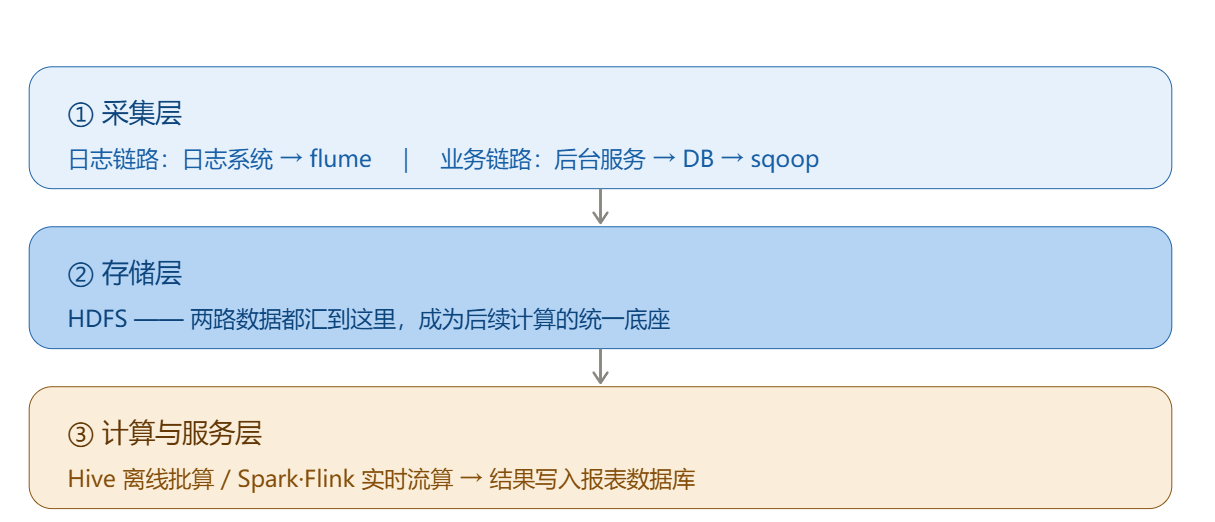
数据仓库分层
1、清晰的数据结构:每一层的作用不一样,目的是为了更好的定位和理解数据
2、方便数据血缘追踪,减少重复性的开发:三个不同的需求,都需要从5张表获取数据,都需求进行清洗和转换。
3、把复杂问题简单化
4、维护方便
ODS层:Operate data store,贴源层(原始数据层)
数据来源:业务库,埋点数据,消息队列、接口数据
建设方式:
1、与业务库表结构一致,一般情况下会在原业务库表名前面添加库前缀,或自定义前缀。
2、直接采集业务数据,不做转换处理,数据保留时间根据业务具体确定。
3、全量采集,第二天再次全量采集,前一天的数据不保留。大表优化可做增量。
Dim层: Dimension 维度层
DIM(Dimension)层是数据仓库的关键组成部分之一,它主要负责存储维度数据和规则,使数据仓库中的数据更易于理解和分析。
DWD层:Data WareHouse Detail 数据明细层
数据来源:ODS
建设方式:根据ODS层数据按主题性进行归类建模。
DWD,主要是将从业务数据库中同步过来的ODS层数据进行清洗和整合成相应的事实表。事实表作为数据仓库维度建模的核心,需要紧紧围绕着业务过程来设计。在拿到业务系统的表结构后,进行大概的梳理,再与业务方沟通整个业务过程的流转过程,对业务的整个生命周期进行分析,明确关键的业务步骤,在能满足业务需求的前提下,尽可能设计出更通用的模型。
四个基本概念:维度,事实,指标(度量),粒度。
客户注册事实表:一条客户注册记录就是一个事实,指标,客户注册量。
DWS层:Data WareHouse Servce 数据服务层(数据汇总层)
数据来源:DWD、Dim
对明细数据进行预加工,汇总,与关联,建立多维立方体的数据量,提高查询效率。
ADS层:Application Data Store 数据应用层
服务于终端用户,高度汇总。
DWD:一张事实表有20个维度,5个指标,DWS层就可能:10个维度,5个指标,APP层:3个维度,5个指标,
我们这个项目使用的是 维度建模
维度建模: 所有的表分为两类 1、事实表 2、维度表
ods 、dwd、dws、ads 一般存放的都是事实表
dim 一般存放的都是维度表
数据仓库建表规范
数据仓库建表命名规范
| ODS | ods_<源系统>_<源表名> | ods_erp_ekko、ods_mysql_order |
| DIM | dim_<实体> | dim_date、dim_shop、dim_product |
| DWD | dwd_<主题>_<业务过程> | dwd_trade_order_detail、dwd_user_login |
| DWS | dws_<主题>_<统计维度>_<周期> | dws_trade_user_1d、dws_trade_shop_30d |
| ADS | ads_<主题>_<业务场景> |
ads_trade_gmv_report、ads_trade_shop_rank_daily |
- 分层说明:各层的定位与特征(ODS 不改名、DIM 不带周期、DWD 不聚合、DWS 周期必填、ADS 一表一场景)
- 通用铁律:全小写、下划线分词、避开保留字等
- 周期后缀约定:_1d/_7d/_30d/_td/
dws_trade_user_1d → 今天交易额 (日报用)
dws_trade_user_7d → 近7天交易额 (周报用)
dws_trade_user_30d → 近30天交易额 (月报用)
dws_trade_user_td → 累计交易额 (用户主页用)
字段定义原则
相同的数据属性,如果在不同的表中出现,则应采取相同的字段名、数据类型、数据长度,数据精度;
uname 不管在哪个表只要出现用户名 必须都叫做uname
数字类型的数据必须为整数或浮点数,金额类型数据必须为浮点数
日期类型的数据:同一个字段的值其格式必须统一 YYYY-MM-DD YYYY/MM/DD
字段命名:要么都是英文,要么都是中文拼音缩写。
ods层数据开发
ods : 原始数据层,贴源层
数据来源是三方面的:
1、数据库数据
2、日志数据
3、第三方数据
1、 业务数据库的导入
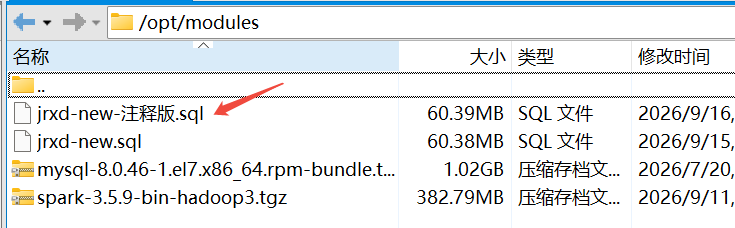
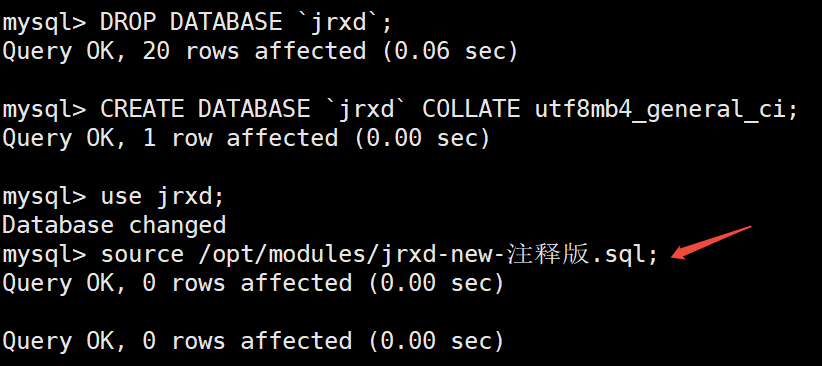
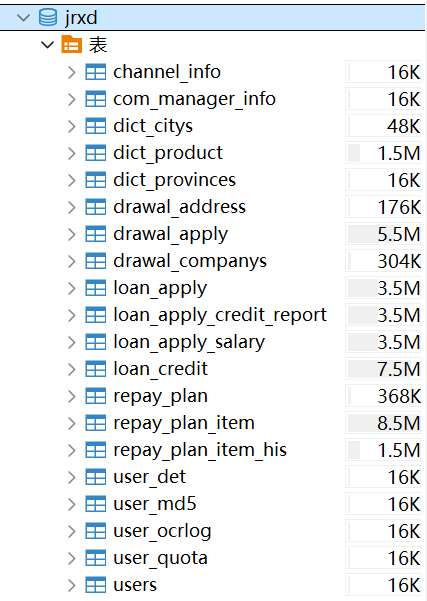
金融信贷业务的sql脚本上传至 linux 的/opt/modules 下,进入mysql客户端,创建数据库,并使用source导入数据
mysql -uroot -p123456;
DROP DATABASE `jrxd`;
CREATE DATABASE `jrxd` COLLATE utf8mb4_general_ci;
use jrxd;
source /opt/modules/jrxd-new-注释版.sql;
2、生成 hive 建表语句
在hive中创建一个数据库:
create database finance;
编写python脚本,连接mysql数据库,并查询jrxd库下的表字段信息,然后生成hive建表语句,具体脚本如下
# 给定一个数据库的名字和表的名字,自动生成hive的建表语句
import sys
import pymysql
# ============ 配置区 ============
# 连接参数
DB_HOST = 'bigdata001'
DB_USER = 'root'
DB_PASSWORD = '123456'
DB_DATABASE = 'information_schema'
DB_CHARSET = 'utf8mb4'
# 目标库名
TARGET_DB = 'jrxd'
# Hive 表名前缀(生成形如 ods_jrxd_xxx 的表名)
TABLE_PREFIX = 'ods_jrxd'
# 输出文件路径
OUTPUT_FILE = './hive_create_table.sql'
# 完善MySQL到Hive的类型映射(覆盖更多场景,符合生产规范)
MYSQL_TO_HIVE_TYPE_MAPPING = {
# 整数类型
'tinyint': 'TINYINT',
'smallint': 'SMALLINT',
'int': 'INT',
'integer': 'INT',
'bigint': 'BIGINT',
'bit': 'BOOLEAN', # MySQL bit(1) 对应Hive布尔值
# 浮点/定点类型
'float': 'FLOAT',
'double': 'DOUBLE',
'decimal': 'DECIMAL', # 保留DECIMAL类型(金融场景不建议转STRING)
'numeric': 'DECIMAL',
# 字符串类型
'varchar': 'STRING',
'char': 'STRING',
'text': 'STRING',
'tinytext': 'STRING',
'mediumtext': 'STRING',
'longtext': 'STRING',
'enum': 'STRING',
'set': 'STRING',
# 日期时间类型
'date': 'DATE',
'datetime': 'STRING', # 避时区问题,建议存字符串
'timestamp': 'STRING',
'time': 'STRING',
'year': 'INT',
# 二进制类型
'binary': 'BINARY',
'varbinary': 'BINARY',
'blob': 'BINARY',
'tinyblob': 'BINARY',
'mediumblob': 'BINARY',
'longblob': 'BINARY',
# 其他类型
'boolean': 'BOOLEAN',
'bool': 'BOOLEAN'
}
def connect_db():
"""连接数据库,返回连接对象。"""
conn = pymysql.connect(
host=DB_HOST,
user=DB_USER,
password=DB_PASSWORD,
database=DB_DATABASE,
charset=DB_CHARSET,
cursorclass=pymysql.cursors.DictCursor # 返回字典格式,更易读
)
# 校验连接存活(真实和mysql通信)
conn.ping()
print("MySQL连接成功!")
return conn
def get_table_info(conn, db_name):
"""获取指定库下所有基础表的信息,key 统一转为小写。"""
sql = """
SELECT table_schema, table_name, table_comment
FROM information_schema.`TABLES`
WHERE table_schema = %s
AND table_type = 'BASE TABLE'
ORDER BY table_name
"""
with conn.cursor() as cursor:
cursor.execute(sql, (db_name,))
result = cursor.fetchall()
return [_lower_keys(item) for item in result]
def get_all_column_info(conn, db_name):
"""一次性获取指定库下所有表的字段信息,按表名分组,key 统一转为小写。"""
sql = """
SELECT table_name, column_name, data_type, column_comment
FROM information_schema.`COLUMNS`
WHERE table_schema = %s
ORDER BY table_name, ordinal_position
"""
with conn.cursor() as cursor:
cursor.execute(sql, (db_name,))
result = cursor.fetchall()
columns_by_table = {}
for item in result:
item = _lower_keys(item)
table_name = item.pop('table_name')
columns_by_table.setdefault(table_name, []).append(item)
return columns_by_table
def _lower_keys(mapping):
"""将字典的 key 统一转为小写。"""
return {k.lower(): v for k, v in mapping.items()}
def _quote(value):
"""转义注释文本中的单引号,避免破坏 SQL 语法。"""
if value is None:
return ''
return str(value).replace("\\\\", "\\\\\\\\").replace("'", "''")
def generate_hive_ddl(db_name, table_name, table_comment, field_info):
"""根据表信息生成 Hive 建表语句。"""
hive_columns = []
for field in field_info:
column_name = field['column_name']
data_type = field['data_type'].lower()
column_comment = _quote(field['column_comment'])
hive_type = MYSQL_TO_HIVE_TYPE_MAPPING.get(data_type, 'STRING')
# 用反引号包裹列名,避免与 Hive 关键字冲突
hive_columns.append(f"`{column_name}` {hive_type} COMMENT '{column_comment}'")
table_comment = _quote(table_comment)
columns_str = ",\\n\\t".join(hive_columns)
return f"""CREATE TABLE IF NOT EXISTS `{db_name}`.`{TABLE_PREFIX}_{table_name}` (
\\t{columns_str}
)
COMMENT '{table_comment}'
ROW FORMAT DELIMITED
FIELDS TERMINATED BY ',';
"""
def main():
conn = None
try:
conn = connect_db()
tables = get_table_info(conn, TARGET_DB)
print("获取所有表信息:", tables)
columns_by_table = get_all_column_info(conn, TARGET_DB)
print("获取所有表字段信息:", columns_by_table)
ddl_list = []
for row in tables:
table_name = row['table_name']
field_info = columns_by_table.get(table_name, [])
create_hive_table_sql = generate_hive_ddl(
row['table_schema'],
table_name,
row['table_comment'],
field_info,
)
print("生成DDL语句:", create_hive_table_sql)
ddl_list.append(create_hive_table_sql)
# 一次性写入文件,减少 I/O 次数
with open(OUTPUT_FILE, 'w', encoding='utf-8') as f:
f.write('\\n'.join(ddl_list))
print("创建DDL完成")
except pymysql.MySQLError as e:
print(f"数据库操作失败: {e}", file=sys.stderr)
sys.exit(1)
except OSError as e:
print(f"文件操作失败: {e}", file=sys.stderr)
sys.exit(1)
finally:
if conn is not None:
conn.close()
if __name__ == '__main__':
main()
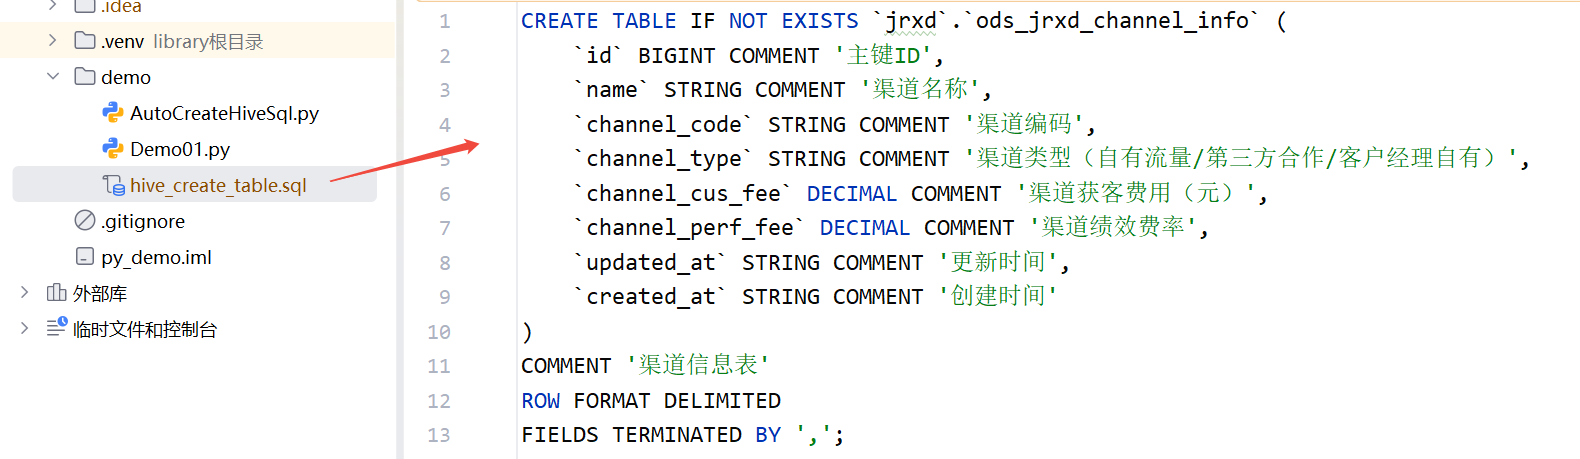
执行后生成DDL,在下面的文件


评论前必须登录!
注册