 网硕互联帮助中心
目录
一、AI 真正缺的不是更多日志,而是“决策记忆”
(一)数据安全解决了“信息去哪儿”,却没有解决“责任落在哪儿”
(二)“可解释模型”与“可解释决策”不是同一个问题
(三)从日志仓库走向 Evidence Graph
二、Semantica 的真正差异:把“决定”做成一等数据对象
(一)Decision Intelligence 不是日志包装,而是新的数据模型
1、一个决策对象至少需要四类证据
1.1 输入证据
1.2 规则与模型证据
1.3 人工与流程证据
1.4 输出与后果证据
2、可查询性比“存下来”更重要
3、Decision Object 的价值在于成为跨系统的“责任主键”
(二)W3C PROV-O:它解决互操作,不替你完成合规
1、为什么标准化 provenance 有价值
2、从“PROV-O compliant”到“regulatory defensible”中间还有五道门
2.1 法规映射
2.2 记录完整性
2.3 不可抵赖与访问控制
2.4 解释准确性
2.5 生命周期治理
(三)确定性推理的意义:把“规则判断”从语言模型里拿出来
三、它不是“又一个图数据库”:Semantica 更像责任语义层
(一)从架构看,图数据库只是底座之一
(二)本体治理决定图谱最终是“知识系统”还是“高级日志库”
1、本体为不同团队建立共同语言
2、本体不能“全自动生成后就不管”
(三)冲突检测与实体解析:被低估的风险控制能力
四、为什么信贷是最值得做 Decision Observability 的场景
(一)中国监管已经把“推理路径与阈值记录”写进高风险 AI 治理要求
(二)《个人信息保护法》把重大自动化决策的“说明权”放到了用户一侧
(三)美国的 adverse action 规则说明:复杂模型不是无法解释的借口
(四)欧盟 AI Act 进一步把个人信用评估置于高风险框架
五、如果把 Semantica 用在信贷系统,应该怎样落地
(一)第一阶段不要“改造核心审批”,先做 Shadow Decision Ledger
1、最小接入范围
1.1 四个强制事件
1.2 两个必须版本化的对象
1.3 一个不可妥协的原则
2、Shadow 阶段的三个验收问题
(二)第二阶段把“审计查询”做成产品,而不是数据工程项目
(三)第三阶段再引入确定性 policy gate 与 Agent 决策记录
1、策略一致性检查
2、Agent 工具调用的责任链
3、将“相似先例”作为一致性信号,而不是自动裁决依据
(四)第四阶段建立 Decision Quality 闭环
六、与 GraphRAG、Cognee、Graphiti、Neo4j 的关系:差异不是“有没有图”
(一)Microsoft GraphRAG:强项是从语料构图并改善检索,不是决策账本
(二)Cognee:更接近 Agent Memory / Knowledge Infrastructure
(三)Graphiti:时间感知的上下文图很强,但它首先是实时 Agent Memory
(四)Neo4j + GraphRAG:成熟图能力最强,但治理语义需要团队自己定义
(五)真正的选型维度应该是“你要治理什么对象”
七、生产化真正困难的地方,不在 API,而在治理成本
(一)本体设计是隐形的大项目
(二)“因果链”很容易被误用成“相关链”
(三)存得越全,隐私与数据最小化压力越大
(四)可用性与性能决定它能不能进入主链路
(五)最难的是组织责任:谁拥有“决策事实”
八、对 Semantica 的判断:值得关注,但不要把“合规”当作开箱即用功能
(一)它最有价值的不是知识图谱,而是“决策主键 + provenance + policy”组合
(二)在金融机构里,最合理的第一定位是“Decision Evidence Layer”
(三)建议用五个指标判断试点是否成功
(四)最终结论:AI 治理正在从 Model Governance 走向 Decision Governance
参考资料
干货分享,感谢您的阅读!
过去两年,企业部署 AI 的关注点主要集中在两条边界:数据能不能离开内网,以及模型能不能被自托管。但在信贷、保险、支付、反欺诈等高风险业务中,第三条边界正在迅速变得更重要——决策责任边界。系统不仅要回答“模型输出了什么”,还要回答“当时掌握了哪些事实、引用了哪一版规则、哪些模型与人工判断共同影响了结果、为什么采取这个动作、事后能否完整复现”。
Semantica 的价值,恰恰不在于再造一个图数据库,而在于尝试把 AI 决策从一次性推理结果,转换成可查询、可追溯、可复现、可治理的结构化对象。
本文基于截至 2026 年 8 月 18 日的公开仓库、官方文档与监管资料,对其技术定位、信贷落地路径、竞争边界与生产化风险进行系统分析。检索时点上,Semantica GitHub 主仓库约为 1.7k stars,而非 4.2k;PyPI 最新稳定版本为 0.6.0,发布时间为 2026 年 7 月 21 日。[1][7] 当前官方文档列出的 RDF 三元组后端主要为 Blazegraph、Apache Jena 与 RDF4J,标签属性图后端为 Neo4j、FalkorDB、Apache AGE 与 AWS Neptune;因此本文不把 Oxigraph 写成当前已正式列出的内置后端。[1][6] 同样,W3C PROV-O 是用于表达和交换 provenance(来源与衍生关系)的标准,不应被等同为“使用该格式即可自动满足监管要求”。[13]
一、AI 真正缺的不是更多日志,而是“决策记忆”
(一)数据安全解决了“信息去哪儿”,却没有解决“责任落在哪儿”
企业在引入大模型和 Agent 时,最先解决的往往是数据安全:是否调用公有云模型、敏感字段是否脱敏、推理是否能够部署在 VPC 或本地、提示词和响应是否会被第三方留存。这一层非常重要,但它本质上解决的是数据边界。
第二层是推理边界。越来越多团队采用自托管模型、私有推理网关、Inference Hooks、MCP 权限隔离、模型路由与调用审计,把“模型在什么环境里运行、允许访问哪些工具”控制起来。它解决的是执行边界。
问题在于,信贷决策并不会因为数据没有出境、模型运行在内网,就天然变得可解释。一次拒贷可能同时受到征信特征、收入稳定性、DTI 阈值、反欺诈信号、模型分数、政策版本、例外规则以及人工复核意见影响。传统日志通常只留下分散的技术事实:某个接口返回 200、某个模型输出 0.73、某条规则命中、某个用户点击了“拒绝”。它们能够证明“系统发生过什么”,却很难直接回答“这些事实怎样共同导致了最终决定”。
这就是第三条边界:决策责任边界。它要求系统把一次决定所依赖的事实、规则、模型、人员、时间和后续影响连接起来,形成一条可以被业务、风控、审计、合规和监管共同理解的证据链。
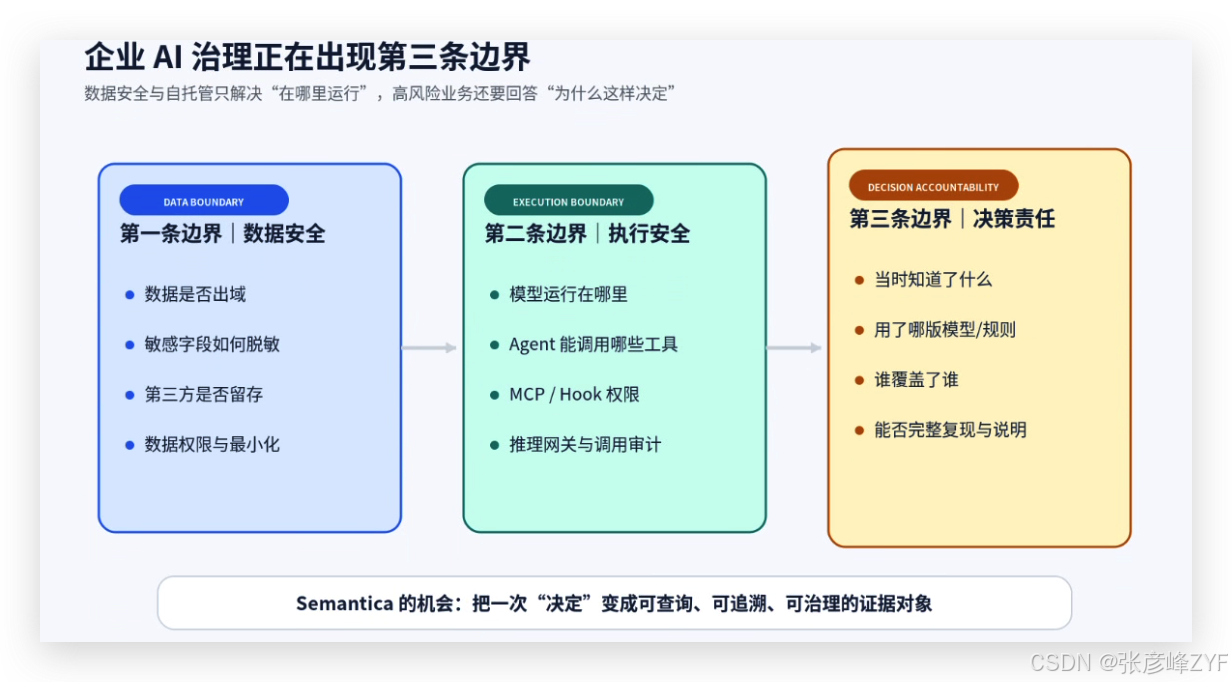
企业 AI 治理的三个边界。Semantica 所瞄准的是第三层——让“为什么做出这个决定”成为可计算、可检索的数据。
(二)“可解释模型”与“可解释决策”不是同一个问题
金融机构过去谈 Explainable AI,常把重点放在模型层。例如用特征重要性、SHAP、局部解释、单调约束或评分卡 reason code 回答:哪些变量影响了分数。这些方法仍然重要,但它们只能解释模型输出,不能天然解释业务决策。
一笔贷款被拒绝,可能并不是因为模型本身给出低分,而是因为模型给出“可接受”,但随后命中了反欺诈硬规则;也可能模型分数处于灰区,最终由人工复核否决;还可能由于某一版政策对自雇收入的核验要求发生变化,使同一客户在两个不同日期得到不同结果。若只保存模型解释,就会漏掉规则、流程、人工和版本因素。
因此,高风险 AI 系统真正需要的不是单一的“解释器”,而是一种决策观测系统:像可观测性平台观察服务调用链一样,观察一次业务决定从输入到输出经历了哪些节点,并且能够在数月后按当时状态重新理解它。
(三)从日志仓库走向 Evidence Graph
日志的天然单位是“事件”,图谱的天然单位是“实体与关系”。当审计问题从“某个接口何时被调用”变成“哪组事实导致了这次拒贷”,关系结构就比日志行更重要。
可以把高风险 AI 的审计记录抽象成一张 Evidence Graph(证据图谱):
-
申请(Application)连接到输入事实(Fact);
-
输入事实连接到数据来源和采集时间(Source / Provenance);
-
模型输出连接到模型版本、特征版本和阈值(Model / Version / Threshold);
-
规则命中连接到政策条款与生效区间(Rule / Policy / Valid Time);
-
人工动作连接到操作人、角色和复核意见(Human Review);
-
最终决定连接到原因、置信度、通知内容与后续结果(Decision / Outcome);
-
每个节点都保留“谁在何时基于什么产生了它”的 provenance。
这样一来,审计不再是从几十套系统拼日志,而是围绕“某次决定”遍历一张有语义的证据网络。
二、Semantica 的真正差异:把“决定”做成一等数据对象
(一)Decision Intelligence 不是日志包装,而是新的数据模型
Semantica 官方把 Decision Intelligence 定义为:记录、存储、追踪和查询 Agent 决策的一套机制。决策会作为知识图谱中的一等对象,保存 scenario、reasoning、outcome、confidence 等结构化字段,并可与上游原因、下游影响以及历史先例建立关系。[2]
这点看似只是“多存几个字段”,实际改变很大。传统系统常见的数据组织是:
申请表 → 模型服务日志 → 规则引擎日志 → 工作流日志 → 人工操作日志 → 最终状态
每个系统都知道自己发生了什么,却没有一个统一对象代表“这次业务决定”。Semantica 试图反过来组织数据:先把“Decision”定义为核心节点,再让事实、规则、模型、人员和结果围绕它形成关系。
1、一个决策对象至少需要四类证据
1.1 输入证据
输入证据回答“系统当时知道什么”。不仅包括客户原始字段,也包括经转换后的特征、外部数据返回值、知识库事实及其时间有效性。对信贷而言,尤其要区分事实发生时间与系统获知时间:客户在 6 月已经离职,但系统到 7 月才收到数据更新,这两种时间不能混为一谈。
1.2 规则与模型证据
规则与模型证据回答“系统依据什么进行判断”。需要记录模型版本、评分、阈值、规则版本、规则命中结果、例外条件,以及多模型融合方式。否则模型升级后,历史申请可能无法用新版本复现。
1.3 人工与流程证据
高风险信贷决策往往不是纯自动化。人工复核、额度调整、例外审批、二次验证都可能改变结果。因此需要记录操作角色、权限、操作原因、输入材料,以及人工决定是否覆盖模型或规则结论。
1.4 输出与后果证据
最终决定不是链路终点。是否放款、是否逾期、是否申诉成功、是否发生人工纠错,都是评价决策质量的重要后果。只有把 decision 与 outcome 连接起来,系统才能做“相似先例”和“决策影响”分析,而不是只做静态审计。
2、可查询性比“存下来”更重要
真正的审计价值来自查询。一个理想的决策图谱应支持:
-
查询过去 90 天所有因“收入稳定性不足”而进入人工复核的申请;
-
找到与当前自雇申请人最相似的历史决策,并比较最终表现;
-
找出某一版 DTI 政策上线后影响了哪些客户群体;
-
追踪某条错误数据从数据源进入特征、模型、规则,再进入最终决定的完整传播路径;
-
回看某一时点的政策与事实,而不是用今天的数据解释昨天的决定。
Semantica 当前提供 record_decision、find_similar_decisions / find_precedents、trace_decision_chain、analyze_decision_impact、check_decision_rules 等能力,方向正是把这些问题变成 API 或图查询。[1][2]
下面是一个最小化的信贷决策记录示例。它展示的是 Decision Intelligence 的编程模型,而不是完整生产方案;真实系统还应把 application_id、model_version、policy_version、source reference 等写入 metadata 或关联节点。
from semantica.context import ContextGraph
graph = ContextGraph(advanced_analytics=True)
decision_id = graph.record_decision(
category="credit_policy",
scenario="自雇申请人,DTI 62%,现金流近 6 个月稳定",
reasoning="超过自动审批 DTI 阈值,按当前政策进入人工复核",
outcome="escalate_to_manual_review",
confidence=0.87,
)
chain = graph.trace_decision_chain(decision_id)
similar = graph.find_similar_decisions("自雇申请人 高负债率", max_results=5)
compliant = graph.check_decision_rules({"category": "credit_policy"})
3、Decision Object 的价值在于成为跨系统的“责任主键”
金融系统已经有 application_id、customer_id、model_run_id、workflow_id。为什么还要 decision_id?因为这些 ID 分别对应业务对象或技术执行,而 decision_id 对应的是责任对象。
当监管、审计或投诉处理问“为什么拒绝 A-7291”时,最希望得到的不是五个系统的日志下载链接,而是一条以决策为中心的可验证链路。Decision Object 可以成为模型、规则、数据、人工与通知之间的责任主键,这是 Semantica 最值得关注的设计思想。
(二)W3C PROV-O:它解决互操作,不替你完成合规
Semantica 的 provenance 模块使用 W3C PROV-O 表达来源与衍生关系,并提供 lineage、source attribution、checksum 与导出能力。[3] PROV-O 的核心概念很适合审计:Entity 表示数据或对象,Activity 表示处理过程,Agent 表示执行者;通过 wasGeneratedBy、wasDerivedFrom、wasAssociatedWith 等关系,可以描述一个事实怎样从某个来源经过某项活动产生。[13]
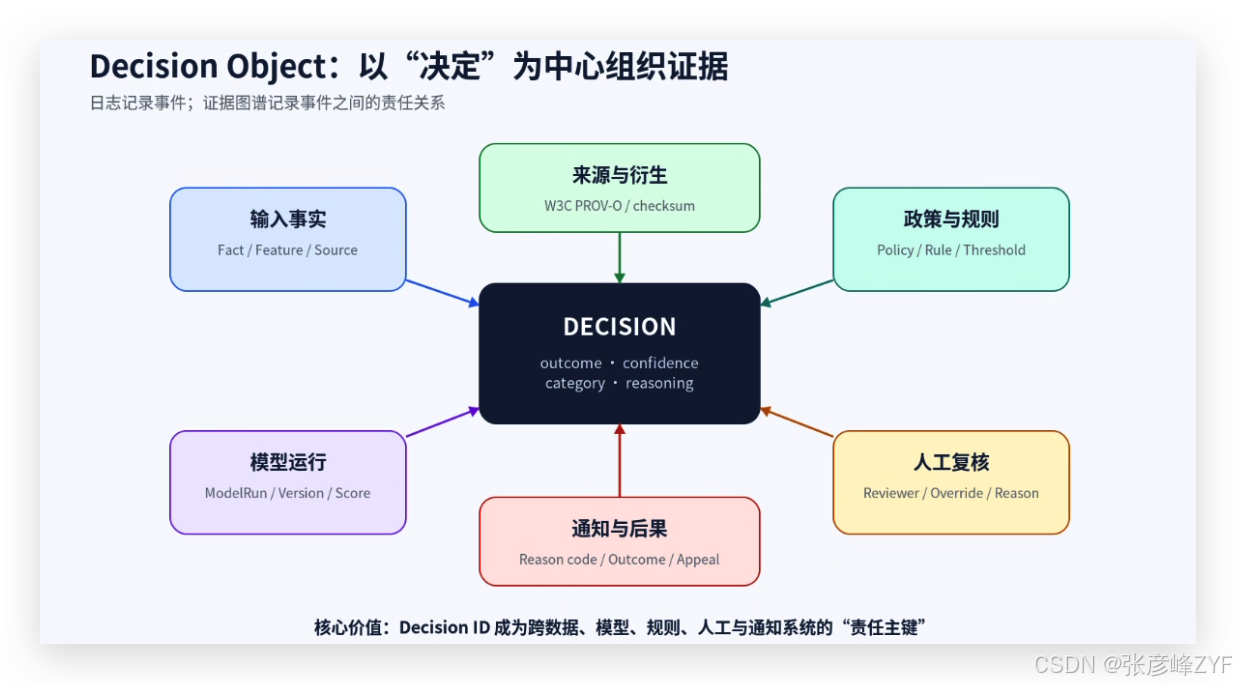
把 Decision 作为中心节点,可以把输入事实、模型、规则、人工复核、通知与结果串成一条 provenance 可追踪的证据链。
1、为什么标准化 provenance 有价值
第一,它降低审计数据被锁死在内部日志格式中的风险。第二,它让不同系统能够共享“来源、活动、执行者、衍生关系”的基本语义。第三,它适合在知识图谱中表达多跳因果或依赖关系。
但必须强调:PROV-O 是 provenance 表达与交换标准,不是金融监管的合规认证。 一个系统把错误的 reason code、缺失的输入事实或未经授权的人工修改写成完全合法的 PROV-O,也仍然可能不合规。
2、从“PROV-O compliant”到“regulatory defensible”中间还有五道门
2.1 法规映射
必须把图谱字段映射到具体监管义务。例如某一司法辖区要求提供具体拒贷原因,那么系统必须证明发给消费者的 reason code 与实际决策因素一致,而不是只证明“系统保存过一些原因字段”。
2.2 记录完整性
provenance 只有在输入、转换、模型、规则、人工、通知等关键节点都接入时才有意义。若只给 LLM 输出做 lineage,而核心规则引擎仍在图谱之外,证据链依然断裂。
2.3 不可抵赖与访问控制
checksum 能帮助发现篡改,但生产环境还需要写入权限隔离、密钥管理、时间戳可信性、审计日志、备份与恢复、删除策略等控制。完整性不是一个 hash 字段就能解决的。
2.4 解释准确性
“解释”必须与实际决策路径一致。尤其当模型复杂、采用 post-hoc explanation 时,必须验证解释是否忠实于模型,而不能把“听起来合理”当成“真实原因”。
2.5 生命周期治理
模型和规则会变化。合规需要版本管理、审批、验证、上线、监控、退役与历史回放。决策图谱必须与模型风险管理和政策治理衔接,而不是独立存在。
(三)确定性推理的意义:把“规则判断”从语言模型里拿出来
Semantica 提供前向/后向链、Rete、Datalog、SPARQL、时间推理等多种推理能力,并强调可生成推理路径。[4] 这对金融场景的意义,不是要用符号推理替代所有机器学习,而是帮助团队划分边界:
适合交给 LLM 的,是非结构化理解、信息抽取、辅助解释;适合交给确定性引擎的,是明确政策、阈值、资格条件、冲突检查和必须可重放的规则。
例如“客户提交的营业执照是否包含主营业务信息”可以让模型抽取;但“自雇客户若经营年限小于 12 个月则不得自动审批”应当成为版本化规则。这样做的收益是:相同事实与相同规则版本可以得到相同结果,审计时也能明确指出哪条规则触发。
三、它不是“又一个图数据库”:Semantica 更像责任语义层
(一)从架构看,图数据库只是底座之一
Semantica 官方架构是一条从 ingestion 到 knowledge graph,再到 ontology、reasoning、provenance、decisions,最后进入向量库、图存储与 REST/MCP/CLI 的流水线。[1][6] 当前文档显示,它同时支持多类存储:
| 向量存储 | FAISS、Pinecone、Weaviate、Qdrant、Milvus、PgVector,0.6.0 新增 SQLiteVec | 模糊语义检索、precedent search |
| 标签属性图 | Neo4j、FalkorDB、Apache AGE、AWS Neptune | 关系遍历、图分析、持久化 |
| RDF 三元组 | Blazegraph、Apache Jena、RDF4J | SPARQL、语义互操作、ontology/provenance |
| 企业数据源 | Snowflake;0.6.0 新增 Databricks Unity Catalog / Delta Lake 连接 | 接入结构化企业数据 |
| 上层智能 | Ontology、Reasoning、Provenance、Decision Intelligence | 语义、规则、溯源与决策治理 |
因此,把它理解成“图数据库替代品”是不准确的。它更像一个responsibility semantic layer(责任语义层):底层可以换存储,上层重点是统一“系统知道什么、依据什么、做了什么、谁参与、结果如何”的语义。
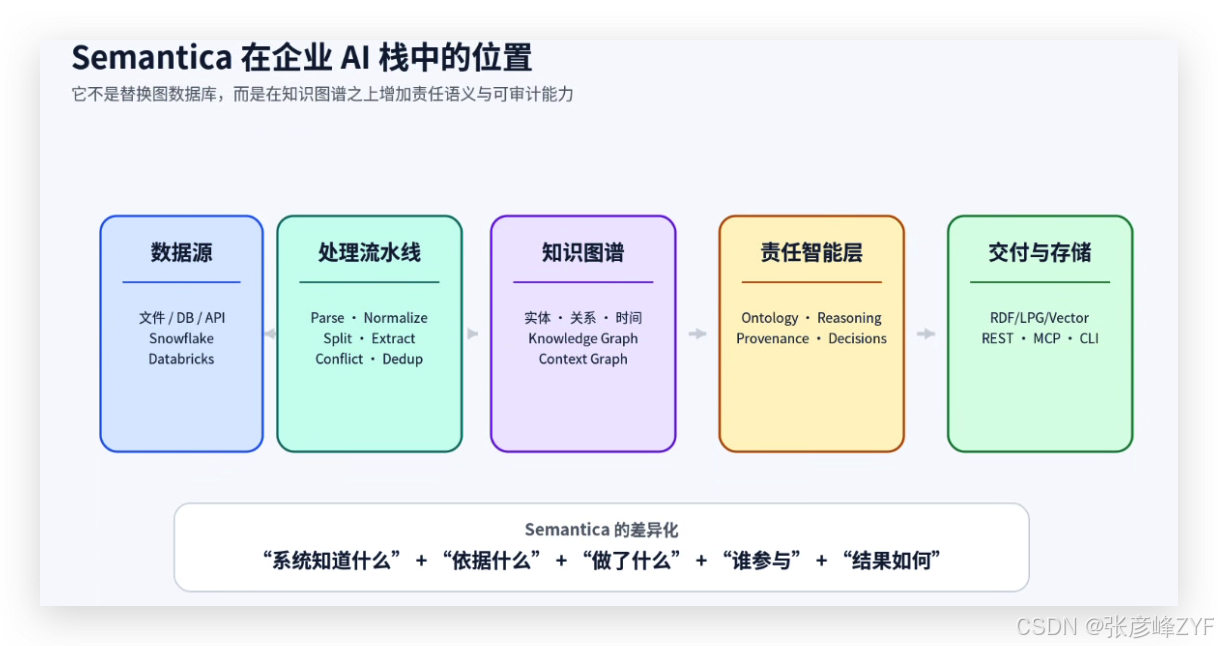
Semantica 的差异化不在存储本身,而在知识图谱之上的 Ontology、Reasoning、Provenance 与 Decision Intelligence。
(二)本体治理决定图谱最终是“知识系统”还是“高级日志库”
Semantica 提供 OWL 生成、SHACL 验证、SKOS 词汇管理以及 Ontology Hub 等能力。[5] 这类功能在 Demo 阶段看起来没有 record_decision 那么直观,却决定了生产系统能否长期维护。
1、本体为不同团队建立共同语言
信贷业务中的“收入”“可验证收入”“月均净收入”“申报收入”“核验收入”看起来都像一个字段,但合规含义不同。没有本体和词汇治理,研发、风控、数据和审计很容易用同一个名字表达不同概念,或用不同名字表达同一个概念。
SHACL 的价值,是把“哪些节点必须有哪些属性、属性类型是什么、关系是否允许”变成可执行约束。例如:任何最终拒贷 Decision 必须关联至少一个 Reason;任何 Reason 必须关联到实际命中的 Rule 或 ModelFactor;任何人工覆盖必须包含 reviewer、timestamp 和 override_reason。这样,图谱在写入阶段就能发现证据链缺口。
2、本体不能“全自动生成后就不管”
自动本体生成适合冷启动,但金融机构真正困难的是治理:谁有权增加一个 reason code?规则废弃后历史节点如何保留?不同国家的收入类型怎么对齐?相同概念在贷前与贷后是否拥有不同定义?
如果没有明确 owner、变更流程、版本号与兼容策略,本体会迅速膨胀,最终变成一个名字很多、关系很多、但没人敢改也没人能解释的“语义沼泽”。
(三)冲突检测与实体解析:被低估的风险控制能力
知识图谱最危险的问题之一不是“没有数据”,而是“同时存在多个互相冲突的数据,却被系统悄悄选了一个”。Semantica 的 conflict detection 与 entity resolution 试图在写入前识别重复实体、数值冲突、类型冲突、时间冲突和逻辑冲突。[6]
对信贷而言,这可以映射为非常具体的问题:
-
CRM 显示客户年收入 120 万,而最新流水核验只有 65 万;
-
两个数据源都叫“ACME Trading”,但一个是申请人公司,一个是供应商;
-
某客户的就业状态在 3 月是“受雇”,5 月变为“自雇”,模型却读取了旧快照;
-
同一政策在规则仓库和运营手册中存在不同阈值。
如果冲突在进入模型之前就被显式标记,并记录“为什么选择某个值”,审计质量会比事后解释高很多。这也是 Evidence Graph 的关键思想:不只记录答案,还记录不确定性、冲突与解决过程。
四、为什么信贷是最值得做 Decision Observability 的场景
(一)中国监管已经把“推理路径与阈值记录”写进高风险 AI 治理要求
2026 年 6 月 18 日,国家金融监督管理总局发布《关于银行业保险业人工智能安全开发应用的指导意见》(金发〔2026〕8号)。文件把涉及资金交易、资产评估、信贷审批、承保理赔、风险管理,以及直接影响客户利益或金融合约达成的生成式 AI 应用列为高风险场景,并要求加强准入、监测、人工监督和退出管理。[8]
更值得关注的是,文件对透明度与可解释性提出了非常工程化的要求:高风险场景应明确模型设计、数据使用、特征选择和输出逻辑;涉及客户权益或实质性财务影响的关键决策,需要设置人工复核节点,并完整保留原始数据、推理路径及阈值触发记录,确保责任可追溯;模型开发、变更和训练过程记录应长期保存。[8]
这意味着“可审计 AI”不再只是出一份模型卡或年审报告,而是要把证据留在系统运行过程中。Semantica 这样的 decision/provenance layer,与这一治理方向在结构上高度一致,但是否满足具体监管要求仍取决于机构自身的字段设计、流程接入、留存策略和控制体系。
(二)《个人信息保护法》把重大自动化决策的“说明权”放到了用户一侧
《个人信息保护法》第二十四条规定,通过自动化决策作出对个人权益有重大影响的决定时,个人有权要求个人信息处理者予以说明,并有权拒绝仅通过自动化决策作出决定。[9]
这条规则对信贷尤其重要。因为“给不给额度、给多少额度、以什么利率给”都会对个人产生实质影响。若企业在系统设计时只保留最终 score,而没有保存当时使用的数据、阈值、规则与人工干预,用户真正行使说明权时,企业就会发现“解释”只能依赖事后猜测。
Decision Graph 的价值,是把解释需要的素材在决策发生时冻结下来。它不能替代法律判断,但能显著降低“事后找不到证据”的运营风险。
(三)美国的 adverse action 规则说明:复杂模型不是无法解释的借口
美国 CFPB 在 2022 年与 2023 年的相关 Circular 中明确强调,使用复杂算法或 AI 并不会免除债权人提供具体且准确拒绝原因的义务;披露原因必须与实际被考虑或评分的因素相对应。[10]
这对技术架构有直接启示:解释层不能只是一个和决策系统松耦合的“文案生成器”。如果拒贷模型使用了 200 个特征,而系统最后让 LLM 根据客户画像生成三条听起来合理的理由,这种理由并不等于真实 principal reasons。真正可靠的方式,是从实际决策路径中提取原因:哪些模型因素、规则命中或人工判断真正改变了 outcome,然后再把这些结构化证据转换成消费者可理解的语言。
(四)欧盟 AI Act 进一步把个人信用评估置于高风险框架
欧盟 AI Act 把用于评估自然人信用状况或建立信用评分的 AI 系统列为高风险类型之一,并对高风险系统提出风险管理、数据治理、技术文档、记录、人类监督和持续监控等要求。[12]
不同司法辖区的法律并不相同,但方向非常一致:高风险 AI 的核心问题已经从“模型准不准”扩展到“系统能否持续证明自己如何做出决定”。 这正是 Decision Observability 的市场空间。
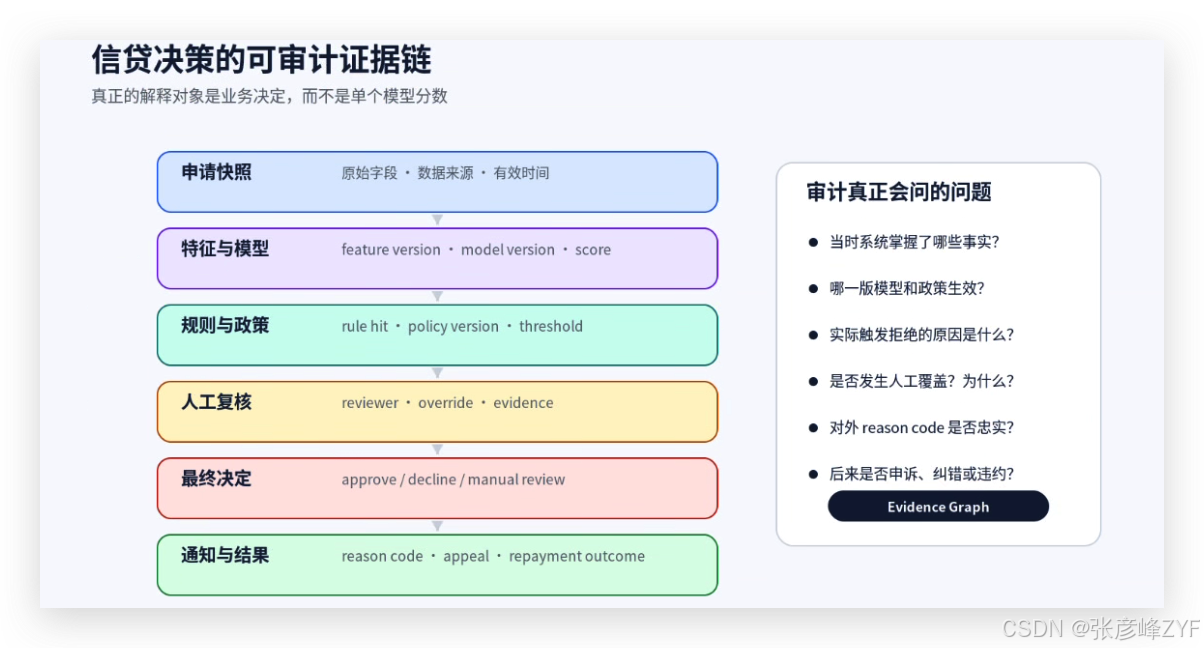
真正可审计的信贷决定需要同时连接数据、模型、规则、人工复核、通知与后果,而不是只保留一个模型分数。
五、如果把 Semantica 用在信贷系统,应该怎样落地
(一)第一阶段不要“改造核心审批”,先做 Shadow Decision Ledger
最容易失败的做法,是一开始就让知识图谱进入线上审批关键路径:所有模型、规则、数据、Agent 都必须先写图谱才能继续。这样会立刻引入延迟、可用性、Schema 与存储容量问题,并让业务团队把所有上线风险都归因于新基础设施。
更稳妥的方式是先做 Shadow Decision Ledger(影子决策账本):现有审批流程照常运行,Semantica 以旁路方式接收事件并构建决策证据图谱,不参与最终 approve/decline。这样可以先验证“能否完整还原决策”,而不是先验证“能否承载生产决策”。
1、最小接入范围
1.1 四个强制事件
第一批只接四类事件:application snapshot、model result、rule hit、final decision。每个事件必须带统一 application_id、decision_id 或可映射的 correlation id。
1.2 两个必须版本化的对象
模型版本与政策/规则版本必须显式记录。如果不能回答“这个申请使用的是哪一版模型和哪一版规则”,后续所有图谱能力都会失去审计意义。
1.3 一个不可妥协的原则
不要把完整原始 PII 复制进图谱。图谱应保存审计所需的最小字段、哈希/引用、脱敏值或受控指针;高敏原文仍留在原有受治理数据域。Semantica 可以是“证据索引与语义关系层”,不必成为新的敏感数据湖。
2、Shadow 阶段的三个验收问题
第一,随机抽取 100 笔审批,是否能在不查原系统日志的情况下重建关键决策路径?第二,当模型/规则版本发生变化时,历史决策能否仍按当时版本解释?第三,审计人员能否用业务语言提出查询,而不是依赖研发写脚本?
若这三点做不到,就不应急着把图谱接入实时控制。
(二)第二阶段把“审计查询”做成产品,而不是数据工程项目
一套 Evidence Graph 的价值,最终要通过可回答的问题体现。建议先建立 20~30 个高价值审计查询模板,例如:
-
某模型版本上线后,人工复核率是否显著提高;
-
某 reason code 在不同渠道和客群的占比是否异常;
-
过去一个月所有被人工 override 的申请,原始模型与规则结论是什么;
-
某外部数据源发生故障期间,哪些决定使用了 fallback 数据;
-
某条政策更新影响的历史决策数量与客户范围;
-
某次客户申诉对应的原始证据链是否完整;
-
同一客户在不同时间申请为何得到不同结果。
当这些查询可以稳定回答,知识图谱才从“有趣的数据结构”变成真正的风险基础设施。
(三)第三阶段再引入确定性 policy gate 与 Agent 决策记录
当团队已经验证决策账本稳定,可以逐步把部分控制前移。例如:
1、策略一致性检查
在 Agent 准备执行“调整额度”“进入催收下一阶段”“自动关闭案件”等动作前,把动作与当前 policy version 送入确定性规则引擎检查。规则失败时不让 Agent 自行解释,而是进入人工队列。
2、Agent 工具调用的责任链
Agent 的风险不只来自回答内容,还来自动作。一个催收 Agent 可能查询客户、选择话术、设定回访时间、触发短信、更新案件状态。每个关键动作应记录:触发原因、使用事实、工具参数、政策依据、模型/Agent 版本与结果。
3、将“相似先例”作为一致性信号,而不是自动裁决依据
Semantica 支持 precedent search,这很适合发现“相似申请为什么被不同处理”。但历史先例可能包含旧政策和历史偏差,因此不应该直接变成“过去都拒,所以这次也拒”。更合理的用法,是把相似先例作为一致性监控与人工复核信号。
(四)第四阶段建立 Decision Quality 闭环
决策图谱最大的长期价值,不是审计,而是把“当时为什么这样决定”与“后来结果怎么样”连接起来。
例如,审批 Agent 对一批边缘客户给出“人工复核”建议。如果半年后这些申请中被人工放行的客户表现良好,那么系统可以分析:究竟是哪个规则太保守、哪个模型区间误差更大、哪些人工 override 具有稳定正向价值。反之,如果某类例外审批的坏账显著更高,也可以追溯到具体规则、渠道或审批角色。
这就把 Decision Intelligence 从“事后合规记录”升级为“决策质量工程”。
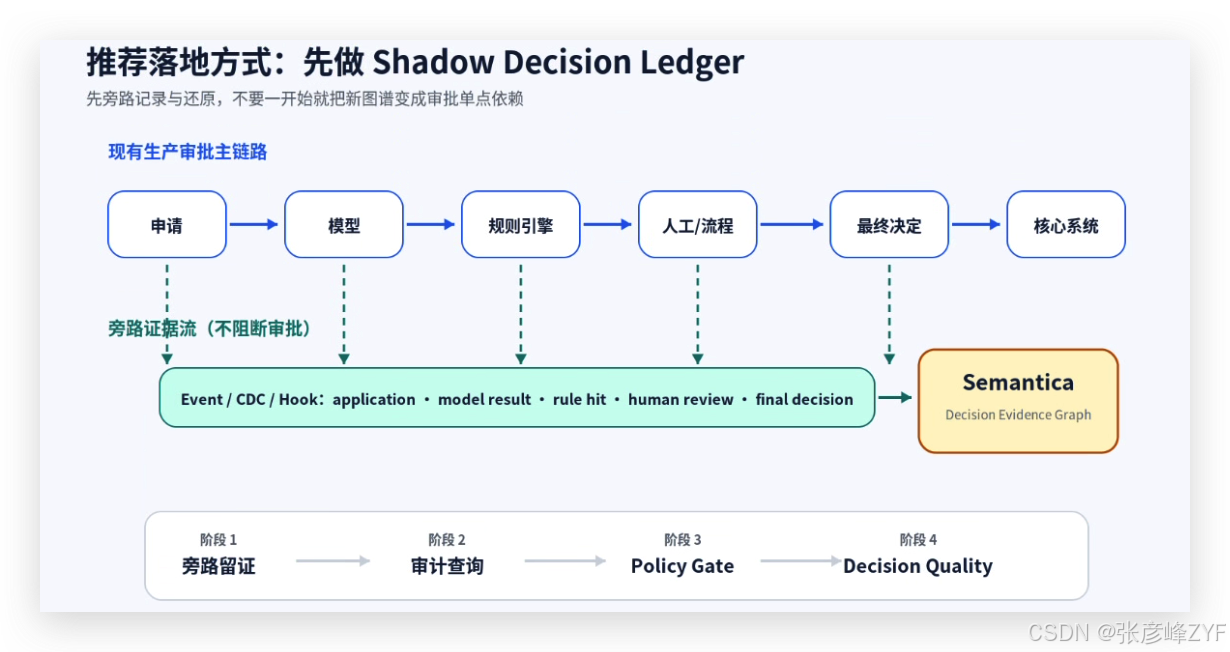
第一阶段采用旁路双写,先证明可还原、可查询、可治理,再逐步把 policy gate 与 Agent action 接入关键路径。
六、与 GraphRAG、Cognee、Graphiti、Neo4j 的关系:差异不是“有没有图”
(一)Microsoft GraphRAG:强项是从语料构图并改善检索,不是决策账本
Microsoft GraphRAG 是一个模块化的 graph-based RAG 数据处理与查询系统,核心流程是从非结构化文本抽取知识图谱、构建 community hierarchy 与摘要,再用于 global/local 等检索方式。[14] 它适合“从大量文档中获得跨文档结构化理解”,但其主要目标并不是保存业务系统每一次 actionable decision 的完整生命周期。
把 GraphRAG 描述为“与 Azure 生态绑定深”并不准确。官方开源仓库是 MIT License,而且 README 明确定位为研究/方法实现,并非必须依赖 Azure 的托管产品。[14] 更准确的比较是:GraphRAG 解决如何从语料组织知识以改善回答;Semantica 试图进一步解决系统基于这些知识做了什么决定,以及如何追责。
(二)Cognee:更接近 Agent Memory / Knowledge Infrastructure
Cognee 当前定位为 Agent 的开源 memory control plane,通过 ingestion、知识图谱、向量检索、ontology grounding 与跨会话记忆,为 Agent 提供持久上下文。[15] 它与 Semantica 的重叠明显高于 GraphRAG:两者都在做图+向量、知识结构和 Agent context。
差异更多在优先级。Cognee 更突出“让 Agent 记住并持续学习上下文”;Semantica 的产品叙事和 API 设计更突出 provenance、deterministic reasoning、decision lifecycle 与 policy checks。对于只想给客服 Agent 做跨会话记忆的团队,Cognee 可能更直接;对于要围绕审批、风控、人工 override 建审计证据的团队,Semantica 的决策对象更有针对性。
(三)Graphiti:时间感知的上下文图很强,但它首先是实时 Agent Memory
Graphiti 是 Zep 开源的 temporal context graph engine,重点是持续摄取 episode、维护实体与关系随时间的变化,并通过语义、关键词与图遍历组合检索,为 Agent 提供实时上下文。[16]
它与 Semantica 在 temporal graph、entity resolution、Agent context 上有交集。区别是 Graphiti 的中心问题更接近“现在什么是真的、之前什么是真的、关系何时变化”,Semantica 则进一步把“决定”作为显式业务对象,并围绕 policy、provenance 与 causal chain 组织能力。
(四)Neo4j + GraphRAG:成熟图能力最强,但治理语义需要团队自己定义
Neo4j 的官方 GraphRAG Python 包提供知识图谱构建、检索、pipeline 与多家 LLM 适配,底层图数据库的稳定性、查询语言、可视化和企业生态都非常成熟。[17]
如果企业已经拥有强大的知识工程和平台团队,完全可以在 Neo4j 上自行设计 Decision、Policy、ModelRun、HumanReview、Provenance 等 schema,并搭建同等甚至更深的治理系统。Semantica 的意义在于把这些能力预先包装成一个面向 AI accountability 的框架,从而降低从零设计的成本。
(五)真正的选型维度应该是“你要治理什么对象”
| 方案 | 核心治理对象 | 最适合的问题 | 相对弱项 |
| Microsoft GraphRAG | 文档知识与 community | 大语料跨文档检索、全局问题 | 业务决策生命周期不是核心 |
| Cognee | Agent 长期记忆与知识 | 持久上下文、跨会话记忆、知识基础设施 | 决策/政策审计不是唯一中心 |
| Graphiti | 随时间变化的 Agent context | 实时事件、时序关系、动态记忆 | 监管式决策对象需要额外建模 |
| Neo4j + 自建 | 任意企业图模型 | 高自由度、大规模成熟图应用 | Ontology/Provenance/Decision 需自行工程化 |
| Semantica | 知识 + provenance + decision | 高风险 AI 的责任链、规则与审计 | 年轻项目,生产案例与生态仍在形成 |
因此,Semantica 并不是要“打败所有 GraphRAG”。它更合理的定位是:当系统开始做会产生业务责任的动作时,为现有 AI 栈增加一个 accountability layer。
七、生产化真正困难的地方,不在 API,而在治理成本
(一)本体设计是隐形的大项目
Demo 里创建几个节点和关系很容易,生产环境需要回答的却是:什么叫“决定”?一个审批流程里是只有最终 approve/decline 算 Decision,还是每个中间判断都算?模型输出是 Fact、Observation 还是 Decision?人工复核是 Activity 还是 Decision?政策规则与模型阈值如何版本化?
这些问题没有唯一答案。错误的 schema 不会立刻报错,却会在半年后让查询变得极其复杂。建议从 5~8 个核心实体类型起步,而不是一开始就追求“把所有业务知识都图谱化”。
(二)“因果链”很容易被误用成“相关链”
图中 A 连接到 B,并不意味着 A 导致 B。尤其是 LLM 自动抽取关系时,“related_to”“mentioned_with”“preceded_by”不能轻易升级为“caused”。如果把所有流程前后关系都叫 causal chain,审计报告会产生虚假的因果确定性。
因此,建议把边分成至少三类:data dependency(数据依赖)、process sequence(流程顺序)、causal assertion(因果主张)。只有明确规则、实验或人工确认支持时,才使用因果语义。
(三)存得越全,隐私与数据最小化压力越大
Evidence Graph 很容易诱发“为了以后审计,什么都存”。这与数据最小化原则冲突。尤其在金融业务中,收入、账户、位置、设备、联系人等数据高度敏感。
合理架构通常不是把所有原始数据复制到图数据库,而是:
-
图谱保存稳定 ID、受控摘要、必要字段与来源引用;
-
高敏原文留在原有受治理系统;
-
通过短期授权或审计权限按需回取;
-
对查询结果实施字段级权限和用途控制;
-
明确不同证据类型的保留期与删除策略。
也就是说,provenance layer 必须与 privacy layer 一起设计。
(四)可用性与性能决定它能不能进入主链路
当 Semantica 只做旁路审计时,短暂不可用不会阻断审批;当它承担 policy gate 时,它就变成关键依赖。此时必须考虑:
-
图存储的高可用与故障切换;
-
写入幂等与事件重放;
-
schema migration;
-
决策记录与业务交易的一致性;
-
大规模 history query 的索引与归档;
-
在图谱不可用时是 fail-open 还是 fail-close;
-
事件积压后如何补写而不破坏时间顺序。
Semantica 0.6.0 仍是非常年轻的版本,虽然项目迭代速度快,也增加了 benchmark、Databricks connector、named graph 等能力,但企业在生产采用前仍应进行自己的容量、故障、升级与回滚验证。[7]
(五)最难的是组织责任:谁拥有“决策事实”
技术团队可以建图,但不能单独定义合规原因;风控团队能定义规则,却未必管理数据 lineage;审计团队知道要查什么,却不负责线上接口。最终必须建立跨职能 ownership:
-
数据团队负责 source lineage 与字段定义;
-
模型团队负责 model/version/feature/validation;
-
风控策略团队负责 rule/policy/reason code;
-
业务运营负责 human review 与 exception;
-
平台团队负责 decision ledger 的可靠性与权限;
-
合规/审计负责 evidence completeness 与查询模板。
如果没有这个组织结构,图谱最终会变成“平台团队一个人维护的漂亮 Demo”。
八、对 Semantica 的判断:值得关注,但不要把“合规”当作开箱即用功能
(一)它最有价值的不是知识图谱,而是“决策主键 + provenance + policy”组合
知识图谱、RDF、SHACL、Rete、Datalog、向量库都不是新技术。Semantica 的产品创新在于把它们围绕一个具体企业问题重新组合:AI 做了决定以后,如何留下结构化、可查询、可验证的责任链。
这使它特别适合三类系统:
第一类是会直接影响客户权益的 AI,例如信贷审批、额度、保险承保与理赔;第二类是会执行真实动作的 Agent,例如催收、交易监控、账户处置;第三类是多模型、多规则、多人工节点共同参与,传统日志已经难以复盘的复杂决策流程。
如果系统只是企业知识问答、内部搜索或简单 RAG,Semantica 可能过重;GraphRAG、向量库或更轻的 Agent memory 往往足够。
(二)在金融机构里,最合理的第一定位是“Decision Evidence Layer”
不建议一开始把 Semantica 定义成“统一知识图谱平台”或“下一代 AI 中台”。这会让项目范围无限扩大。更务实的定位是:
Decision Evidence Layer = 以决策为中心,统一保存关键输入引用、模型与规则版本、实际触发因素、人工干预、通知原因与后续结果,并提供可查询的 provenance。
这个边界足够窄,可以用 8~12 周的试点验证;又足够有价值,可以直接服务模型风险、内部审计、客户投诉、合规检查与策略复盘。
(三)建议用五个指标判断试点是否成功
Decision coverage:高风险决策中,有多少比例拥有完整 decision record;
Evidence completeness:每个决策是否都有数据来源、模型/规则版本、原因与人工节点;
Reconstruction time:从收到审计问题到还原完整决策链需要多长时间;
Reason fidelity:对外 reason code 是否能从实际决策路径直接导出,而非事后生成;
Replay consistency:在冻结数据与版本条件下,能否复现确定性规则与关键流程结论。
其中最重要的不是图中有多少节点,而是 reconstruction time 能否从“几小时/几天跨系统排查”下降到“分钟级查询”。
(四)最终结论:AI 治理正在从 Model Governance 走向 Decision Governance
过去的模型治理以“模型”为中心:数据是否合规、训练是否可靠、指标是否达标、版本是否验证。Agent 时代之后,单个模型已经不是完整责任主体。一个结果可能由检索、工具、规则、多个模型、知识库和人工共同生成。
因此,治理对象必须从 Model 扩展为 Decision:系统当时知道什么、采用什么政策、哪个组件产生了哪个中间结论、谁覆盖了谁、最终为什么采取行动、后来结果如何。
Semantica 仍是一个年轻项目,它是否能成为成熟企业基础设施,需要更多生产规模、稳定性与治理实践来证明。但它抓住了一个真实而且正在被监管强化的问题:未来高风险 AI 的竞争力,不只是“能做决定”,而是“能证明这个决定是怎样做出来的”。
这也是它比“多一个向量库、多一种 RAG、多一个 Agent 框架”更值得金融技术团队关注的原因。
参考资料
Semantica GitHub 主仓库:semantica-agi/semantica
Semantica 官方文档:Decision Intelligence
Semantica 官方文档:Provenance Module
Semantica 官方文档:Reasoning Module
Semantica 官方文档:Ontology Module
Semantica 官方文档:Architecture / Modules
PyPI:semantica 0.6.0 与发布历史
国家金融监督管理总局:《关于银行业保险业人工智能安全开发应用的指导意见》
中国人大网:《中华人民共和国个人信息保护法》
CFPB Circular 2022-03:复杂算法信贷决策的 adverse action 原因披露
Federal Reserve SR 11-7:Supervisory Guidance on Model Risk Management
EUR-Lex:Regulation (EU) 2024/1689 — Artificial Intelligence Act
W3C Recommendation:PROV-O — The PROV Ontology
Microsoft GraphRAG 官方 GitHub
Cognee 官方 GitHub
Graphiti(Zep)官方 GitHub
Neo4j GraphRAG for Python 官方文档


评论前必须登录!
注册