 网硕互联帮助中心
摘要:本文以一个真实场景——数据工场、知识工场、服务工场三个业务项目为例,介绍如何基于 QwenPaw Skill 设计一套\”通用测试智能体\”,通过**项目适配器(Project Adapter)**机制实现\”一套底座、多项目自适应\”的功能测试用例自动生成。文章覆盖架构设计、适配器内容、质量评估体系、落地代码与踩坑实践,适合测试开发工程师参考落地。
一、背景与痛点
在 AI 提效浪潮下,我所在的团队面临几个典型痛点:
核心思路
用 QwenPaw Skill 沉淀测试设计方法论,用项目适配器封装业务差异,用统一质量指标约束输出。
整体链路:
需求文档 + 详细设计 + 历史缺陷清单(多源输入)
↓
QwenPaw Skill 编排
(加载项目适配器)
↓
测试点推导(CoT) → 用例生成
↓
质量评估(统一指标打分)
↓
Excel 功能测试用例(项目定制模板)
Skill 执行时序图 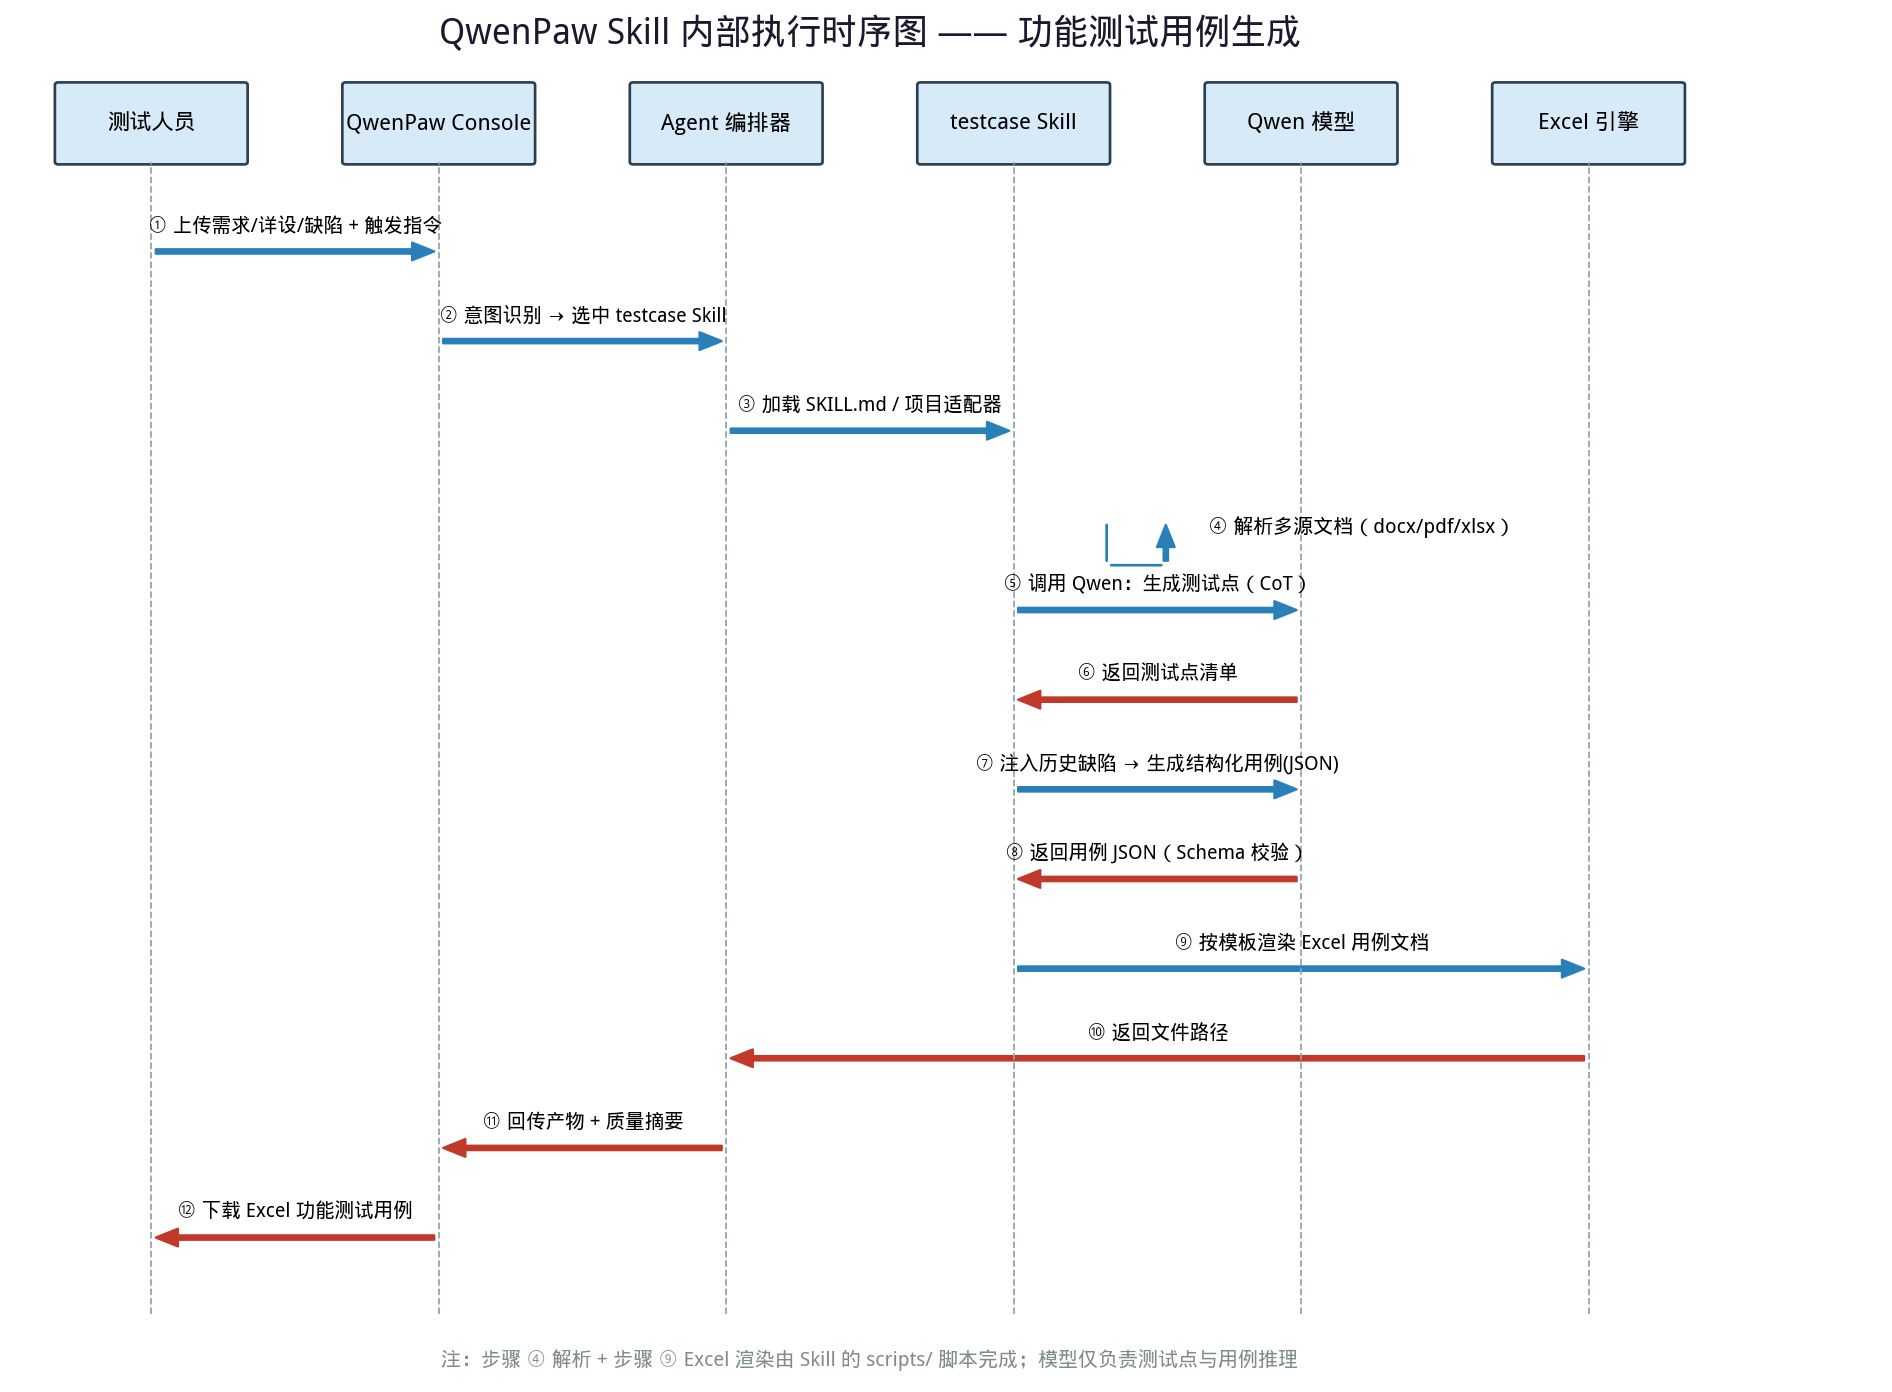
二、整体架构设计
2.1 技术选型
| Agent 编排 | QwenPaw | 个人开发友好,有 Console、Skill、工具调用,上手快 |
| 模型推理 | 本地 Qwen + vLLM / Ollama | 数据不出域,满足合规 |
| Skill | QwenPaw Skill(SKILL.md + scripts) | 把工作流、提示词、脚本沉淀为可复用资产 |
| 差异化解耦 | 项目适配器(YAML) | 配置驱动,核心零修改 |
| 输出渲染 | openpyxl | 按项目模板生成 Excel |
2.2 三层架构
┌─────────────────────────────────────────┐
│ QwenPaw Console (UI) │
├─────────────────────────────────────────┤
│ Agent 编排 / ReAct 调度 │
├─────────────────────────────────────────┤
│ ┌─────────┐ ┌─────────┐ ┌─────────┐ │
│ │ Skill │ │ 工具脚本 │ │ 质量评估 │ │
│ │ 核心逻辑 │ │ scripts │ │ evaluator│ │
│ └────┬────┘ └─────────┘ └─────────┘ │
│ │ 加载 │
│ ┌────┴─────┐ │
│ │ 项目适配器 │ ←── adapters/*.yaml │
│ └──────────┘ │
└─────────────────────────────────────────┘
↓
Excel 功能测试用例
关键解耦点:Skill 核心只负责\”流程编排 + 模型调用\”,所有业务差异(术语、模板、解析器、缺陷索引)收敛在项目适配器里。
项目适配器流程图 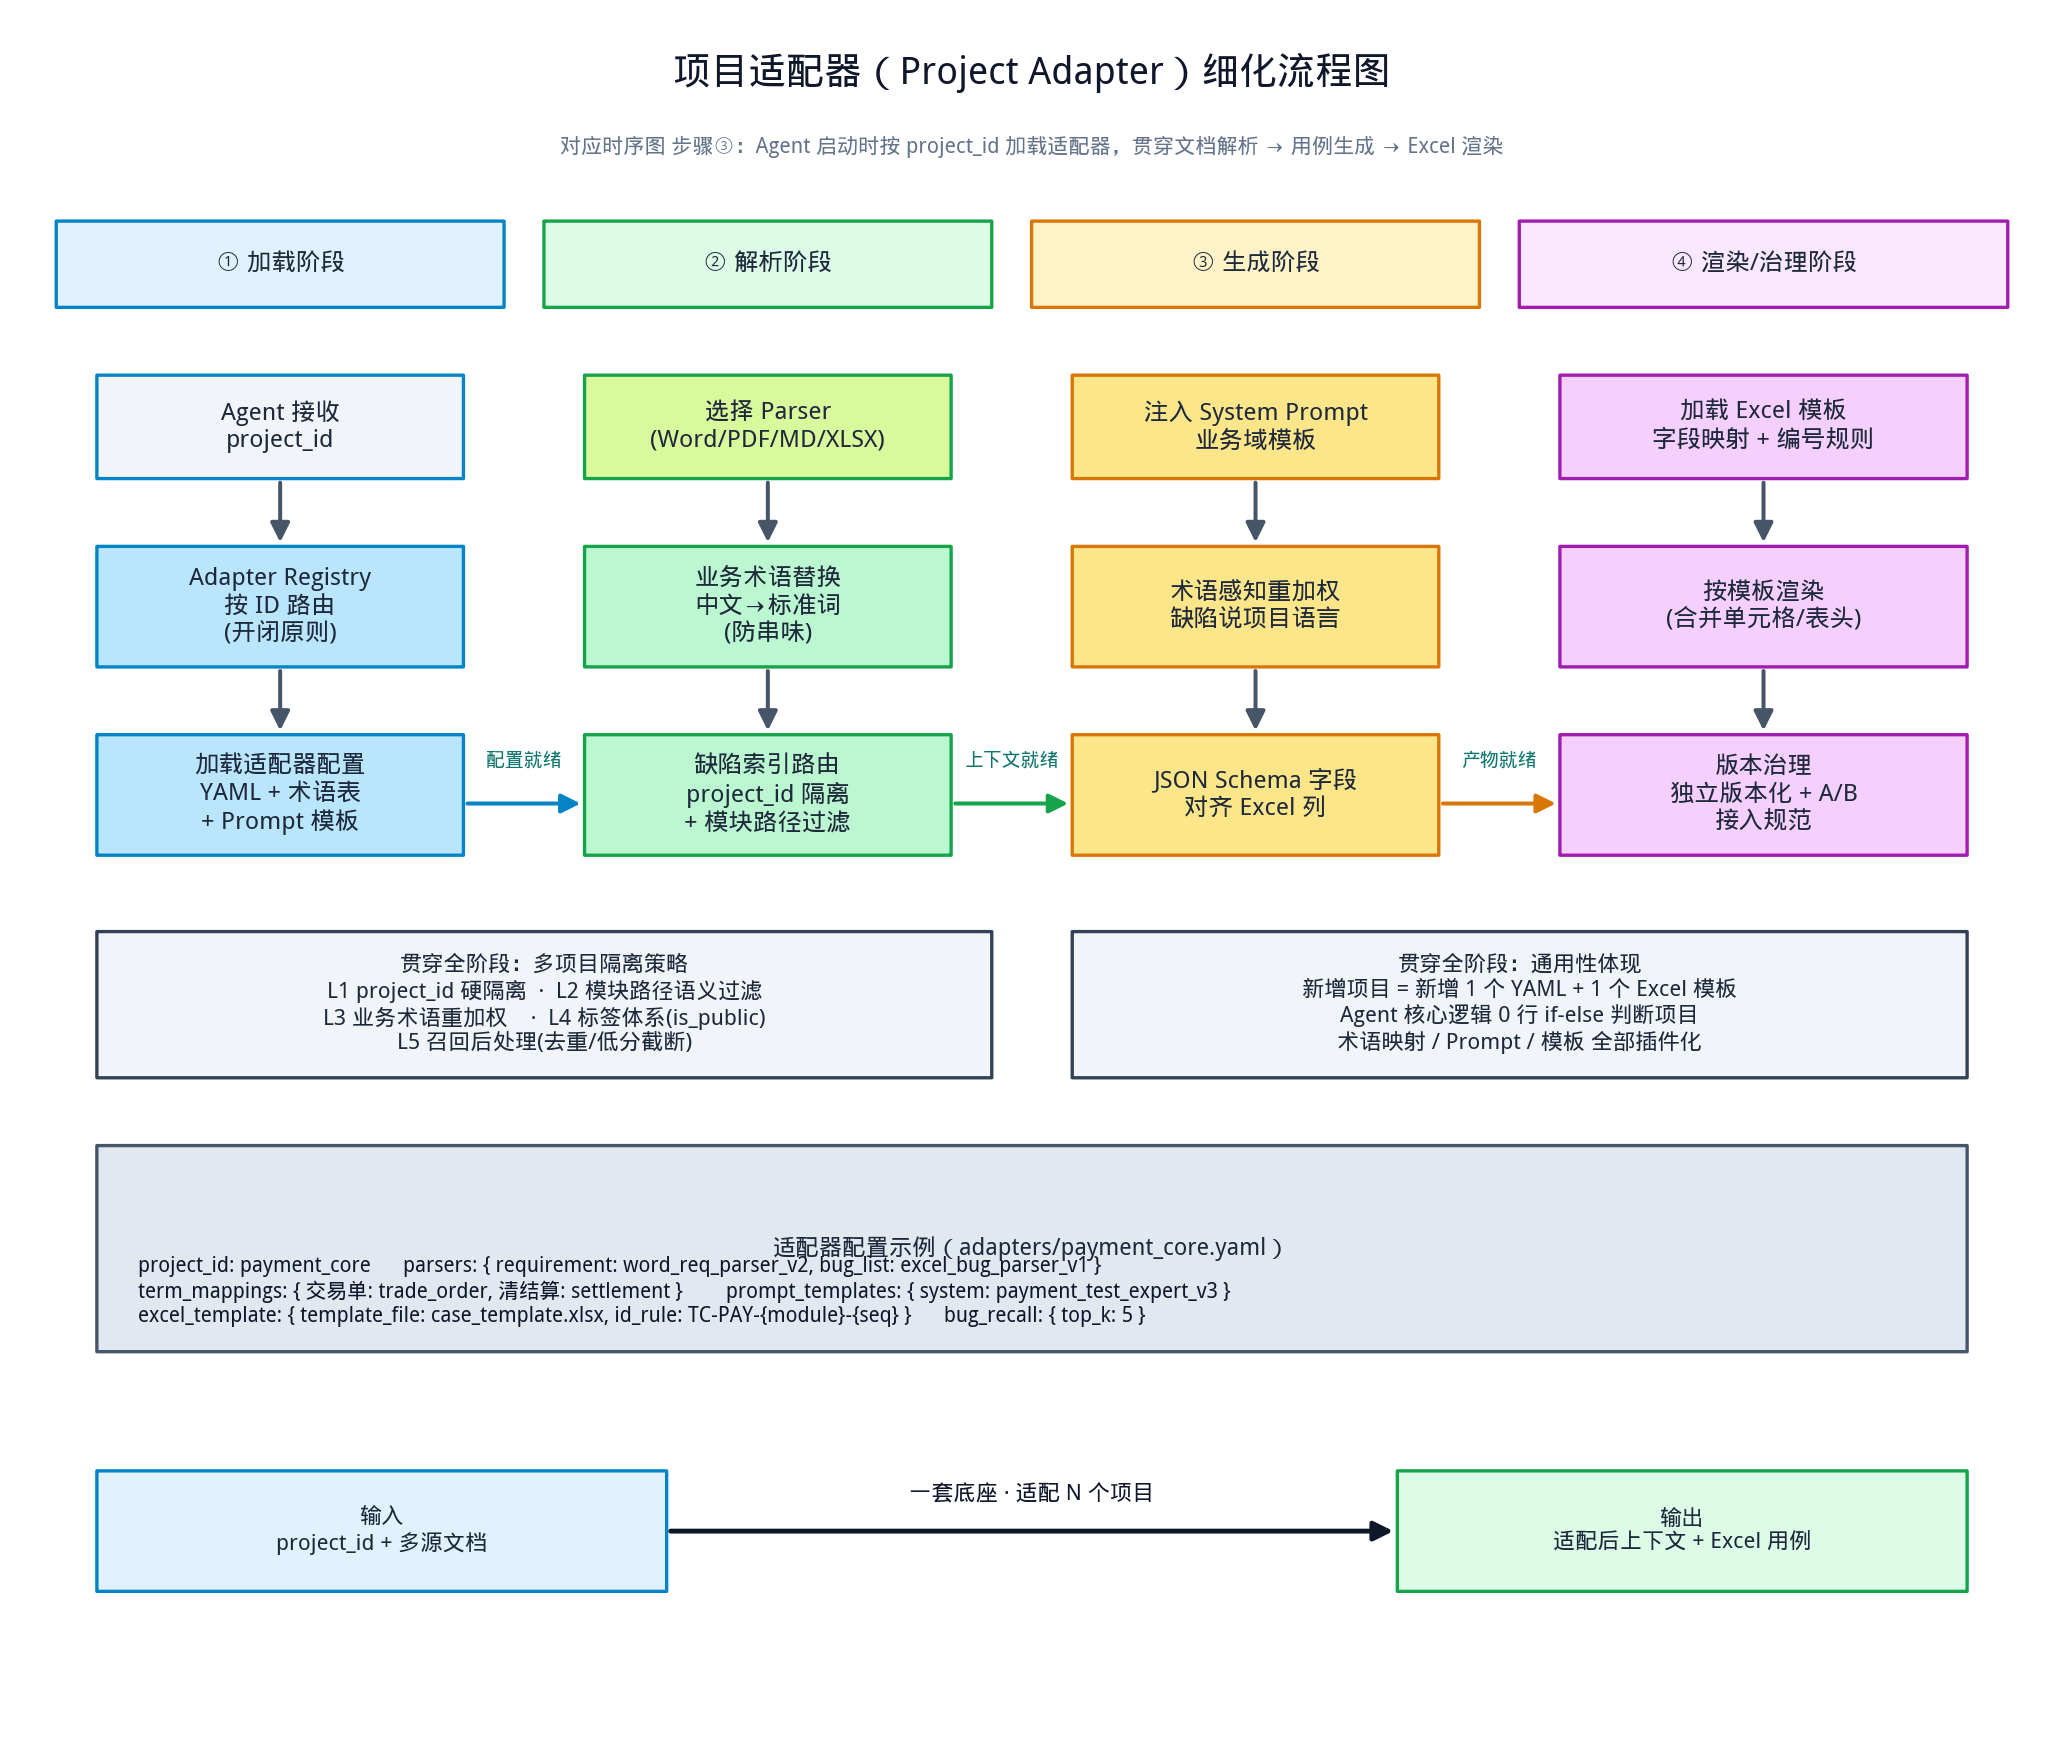
三、Skill 设计(SKILL.md)
3.1 目录结构
testcase_skill/
├── SKILL.md # 技能定义(触发、流程、约束)
├── scripts/
│ ├── load_adapter.py # 加载项目适配器
│ ├── parse_docs.py # 多源文档解析
│ ├── validate.py # JSON Schema 校验
│ ├── render_excel.py # Excel 渲染
│ └── quality_evaluator.py # 质量评估
├── prompts/
│ ├── test_point.cot.md # 测试点推导 CoT
│ └── test_case.md # 用例生成提示词
├── schemas/
│ ├── test_point.json
│ └── test_case.json
├── adapters/
│ ├── data_factory.yaml
│ ├── knowledge_factory.yaml
│ └── service_factory.yaml
├── references/
│ ├── testing_methodology.md
│ └── case_writing_guide.md
└── assets/
└── case_template.xlsx
3.2 SKILL.md 核心内容
—
name: functional–testcase–generator
description: 根据需求/详设/历史缺陷生成 Excel 功能测试用例
triggers:
– 生


评论前必须登录!
注册