 网硕互联帮助中心
在所有生物特征识别技术中,虹膜识别被公认为精度最高、稳定性最好的技术之一。虹膜是位于人眼黑色瞳孔和白色巩膜之间的环状区域,直径约11毫米,包含了极其丰富的纹理信息——隐窝、褶皱、色素斑、放射状条纹、冠状环等细节结构,其形态由胚胎发育过程中的随机因素决定,即使是同卵双胞胎的虹膜也完全不同,同一个人的左右眼虹膜也不相同。虹膜在出生后约8个月发育成熟,此后终身保持稳定(除极少数疾病和外伤外),不易被伪造和篡改。这些特性使得虹膜识别的误识率(FAR)可以低至百万分之一甚至千亿分之一,远高于人脸识别(约千分之一到万分之一)和指纹识别(约十万分之一),被广泛应用于边境通关、国家身份系统、金融高安全认证、监狱门禁等高安全要求场景。
然而,虹膜识别的高精度并非唾手可得——从人眼图像到身份判定,需要经过一套复杂而精密的算法流水线。一套完整的虹膜识别系统包括七大核心环节:图像采集(近红外成像获取高质量虹膜图像)、虹膜检测(在整幅图像中快速定位虹膜区域的大致位置)、精准定位(精确确定虹膜的内边界——瞳孔与虹膜的交界,和外边界——虹膜与巩膜的交界,以及上下眼睑边界)、分割(将虹膜像素从背景、眼睑、睫毛、反光、眼镜等干扰中精确分离出来)、归一化与增强(将环形虹膜区域展开为固定大小的矩形,消除瞳孔缩放和旋转的影响,并增强纹理对比度)、特征提取与编码(用2D Gabor小波等滤波器提取虹膜纹理特征,量化为二进制虹膜编码IrisCode)、匹配与识别(计算两个虹膜编码的汉明距离,与阈值比较判断是否为同一人)。这七个环节环环相扣,任何一个环节的误差都会传导到最终识别结果,因此全套算法的设计和优化是虹膜识别系统工程的核心。
本文将系统讲解虹膜识别全套算法的技术原理和工程实现,从近红外成像原理、虹膜检测粗定位、Daugman积分微分算子与Hough变换精准定位、传统主动轮廓与深度学习U-Net分割、Daugman橡胶片模型归一化、2D Gabor小波特征编码、汉明距离匹配与旋转补偿,到活体检测安全防护、主流数据集与开源工具、工程落地优化、应用场景与未来趋势,完整覆盖虹膜识别从图像到身份的全流程。无论你是计算机视觉算法工程师、生物识别系统开发者、安全产品经理,还是对虹膜识别技术感兴趣的研究者和从业者,这篇文章都能为你提供一份系统、深入、可落地的技术参考。
一、系统整体架构
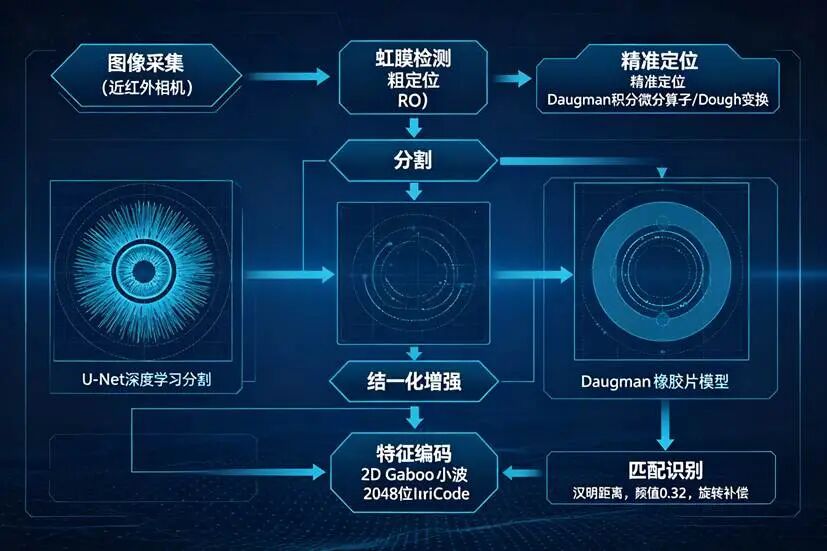
虹膜识别全套算法七层技术架构流程图:图像采集→虹膜检测→精准定位→分割→归一化增强→特征编码→匹配识别
一个完整的虹膜识别系统采用七层流水线架构,从下到上依次为:图像采集层、虹膜检测层、精准定位层、分割层、归一化与增强层、特征编码层、匹配识别层。这七层架构遵循"光学信号→数字图像→虹膜区域→精确边界→像素级分割→标准化纹理→二进制编码→身份判定"的信息处理流程,每一层职责清晰、模块化设计,可以独立优化和替换。前四层(采集/检测/定位/分割)负责从原始图像中提取出干净的虹膜像素区域,后三层(归一化/编码/匹配)负责将虹膜纹理转化为可比对的数字模板并完成身份判定。在实际系统中,还包括质量评估(贯穿各层,实时判断图像质量是否满足要求,不满足时引导用户重新采集)、活体检测(防止照片、视频、假眼等攻击)、模板管理(加密存储虹膜模板,支持1:N大规模检索)等辅助模块。
|
层级 |
核心职责 |
关键技术 |
输入→输出 |
|
1. 图像采集层 |
获取高质量虹膜图像,引导用户正确配合 |
近红外NIR成像(850nm LED照明,人眼不可见)、专用虹膜相机(高分辨率CMOS/CCD,微距镜头,自动对焦)、双目同步采集(左右眼同时获取,提升便利性和安全性)、质量引导(实时反馈距离/角度/光照/睁眼程度,语音/视觉提示)、图像格式(RAW/BMP/PNG/JPEG,通常保留近红外单通道灰度图) |
光学信号→虹膜数字图像(含整幅人眼区域,分辨率通常320×280至2000×2000) |
|
2. 虹膜检测层 |
在整幅图像中快速定位虹膜区域的大致位置,提取ROI |
基于投影的快速检测(水平/垂直灰度投影定位瞳孔暗区和虹膜环状区域)、形态学操作(阈值分割+腐蚀膨胀+连通域分析提取瞳孔候选区域)、深度学习检测(YOLO/SSD/Faster R-CNN/MTCNN检测人眼和虹膜区域,适合复杂背景和可见光图像)、ROI提取(以检测到的虹膜中心为中心裁剪固定大小区域,缩小后续处理范围)、跟踪(视频流中用KCF/光流跟踪虹膜位置,减少重复检测) |
整幅人眼图像→虹膜ROI区域(含虹膜+瞳孔+部分巩膜和眼睑,尺寸通常200×200至640×640) |
|
3. 精准定位层 |
精确确定虹膜内边界(瞳孔-虹膜交界)、外边界(虹膜-巩膜交界)、眼睑边界的参数 |
Daugman积分微分算子(Integro-differential Operator,在参数空间搜索使圆周积分导数最大的圆,是最经典的定位方法,精度高但计算量大)、Hough变换(Canny边缘检测+圆形Hough变换投票,适合边缘清晰的图像,速度快但对噪声和遮挡敏感)、Wildes算法(边缘检测+Hough变换+主动轮廓细化)、主动轮廓模型(Snakes/Level Set,从粗定位结果演化到精确边界,适合非圆形和遮挡情况)、眼睑边界定位(抛物线/圆弧拟合上下眼睑,用边缘检测+RANSAC拟合)、深度学习定位(Hourglass/UNet回归边界热图或直接回归圆参数,鲁棒性强) |
虹膜ROI图像→内圆参数(圆心x,y+半径r_pupil)+外圆参数(圆心x,y+半径r_iris)+上下眼睑曲线参数 |
|
4. 分割层 |
将虹膜像素从背景、眼睑、睫毛、反光、眼镜等干扰中精确分离,生成虹膜掩码 |
传统方法(基于内外圆和眼睑边界的几何掩码,直接用圆和抛物线定义虹膜有效区域,简单快速但对非理想边界和遮挡处理粗糙)、主动轮廓模型(Snakes/Level Set,从初始边界演化到精确虹膜边界,处理非圆形和局部遮挡)、区域生长(从虹膜种子区域生长,利用灰度相似性分离)、深度学习分割(U-Net/U-Net++/FCN/Mask R-CNN/SegNet,端到端像素级分类,分为虹膜/瞳孔/巩膜/眼睑/睫毛/反光/背景等类别,F1可达0.96-0.98,远超传统方法的0.75-0.85)、注意力机制(通道/空间注意力聚焦虹膜纹理区域,提升遮挡和低对比度下的分割精度)、多尺度特征融合(融合浅层细节和深层语义,提升小结构和边界分割精度)、遮挡处理(睫毛检测与修复、反光检测与插值、眼镜检测与去除) |
虹膜ROI图像+边界参数→虹膜像素掩码(二值/多类别mask,标注每个像素是否为有效虹膜及遮挡类型) |
|
5. 归一化与增强层 |
将环形虹膜展开为固定大小矩形,消除瞳孔缩放和旋转影响,增强纹理对比度 |
Daugman橡胶片模型(Rubber Sheet Model,将虹膜环形区域从极坐标映射到固定大小的矩形坐标,如64行x512列,消除瞳孔大小变化和距离变化的影响,是最经典的归一化方法)、瞳孔缩放不变性(映射时以瞳孔边界为内圆、虹膜外边界为外圆,不同瞳孔直径下都映射到相同矩形尺寸)、旋转归一化(估计虹膜旋转角度并校正,或匹配时用循环移位补偿旋转)、图像增强(直方图均衡化HE/CLAHE限制对比度自适应直方图均衡化、Retinex去光照、伽马校正、高斯模糊去噪、锐化增强纹理)、质量评估(清晰度评估拉普拉斯方差/梯度、遮挡比例、反光面积、瞳孔直径比、虹膜可见度、对比度,质量不达标时拒绝并提示重新采集) |
虹膜ROI图像+虹膜掩码→归一化虹膜纹理图(固定尺寸如64×512,灰度图,纹理清晰)+质量评分+有效区域掩码 |
|
6. 特征编码层 |
提取虹膜纹理特征,量化为二进制虹膜编码IrisCode和掩码 |
Daugman 2D Gabor小波(用多尺度多方向的2D Gabor滤波器对归一化虹膜纹理进行卷积,提取相位信息,将相位量化为2位二进制编码,生成2048位IrisCode加2048位掩码,是最经典的特征编码方法)、相位量化(只保留Gabor响应的相位符号而丢弃幅度,对光照变化和对比度变化鲁棒,这是虹膜编码的核心思想)、Log-Gabor滤波器(对数Gabor,在高频区域有更好的响应,提取更丰富的纹理特征)、小波包变换(多分辨率分解,提取不同频带特征)、LBP局部二值模式(统计局部纹理模式,计算简单速度快)、SIFT/SURF特征点(局部不变特征,适合非理想图像)、深度学习特征(用CNN/ViT提取虹膜深度特征,或端到端学习度量空间,生成固定长度特征向量,对遮挡和低质量图像鲁棒性更强)、模板标准化(ISO/IEC 19794-6虹膜数据交换格式,统一编码格式和元数据) |
归一化虹膜纹理图+有效掩码→虹膜编码IrisCode(二进制位串,通常2048-16384位)+掩码(标记每位是否有效,遮挡区域对应位标记为无效) |
|
7. 匹配识别层 |
计算两个虹膜编码的相似度,与阈值比较判断是否为同一人,支持1:1验证和1:N识别 |
汉明距离匹配(Hamming Distance,计算两个IrisCode对应有效位中不同位的比例,是最常用的匹配方法,同一人汉明距离约0.05-0.2,不同人约0.45-0.5,服从二项分布,阈值通常设为0.30-0.35,Daugman经典阈值0.32)、旋转补偿(匹配时将一个编码循环移位±15度(对应矩形图约±15列),取最小汉明距离,补偿采集时的头部旋转和眼球转动)、掩码处理(只计算两个掩码都标记为有效的位,遮挡区域不参与匹配,避免遮挡影响匹配结果)、分数归一化(将汉明距离转换为相似度分数或置信度)、其他匹配方法(加权欧氏距离、归一化互相关、马氏距离,适合非二进制特征)、深度学习度量学习(用孪生网络/三元组损失/ArcFace学习判别性度量空间,直接输出相似度,对复杂场景更鲁棒)、1:N大规模检索(海明空间索引如BK-tree/多探针LSH/倒排索引,将百万级库检索时间从秒级降到毫秒级;分库分表、GPU并行加速)、性能指标(FAR错误接受率/FRR错误拒绝率/EER等错误率/ROC曲线/DET曲线,识别速度,模板大小) |
待识别IrisCode+库模板→匹配分数(汉明距离/相似度)+判定结果(同一人/不同人)+候选列表(1:N场景) |
这七层架构的设计有几个关键特点:①由粗到精的定位策略——先用快速检测粗定位虹膜区域(缩小处理范围),再用精确算子定位内外边界,最后用分割细化像素级掩码,兼顾速度和精度;②几何与数据驱动双轨并行——传统方法(Daugman算子、Hough变换、橡胶片模型、Gabor小波、汉明距离)经过三十年验证,理论扎实、可解释性强、计算高效,仍是工业界主流;深度学习方法(U-Net分割、CNN特征、度量学习)在遮挡、低质量、可见光等复杂场景下鲁棒性更强,是当前研究热点和升级方向;生产系统通常采用"传统方法为主+深度学习为辅"的混合架构;③质量评估贯穿全流程——每一层都需要判断中间结果质量是否达标(图像是否清晰、定位是否准确、分割是否完整、归一化后纹理是否可辨),不达标时及时拒绝并引导用户重新采集,避免低质量模板入库导致后续识别失败;④旋转与缩放不变性设计——橡胶片模型消除瞳孔缩放和距离变化,循环移位补偿旋转,相位量化对光照鲁棒,这些设计使得虹膜编码在不同采集条件下保持稳定;⑤模块化可替换——每一层都可以独立升级(如分割从传统几何掩码升级到U-Net,特征从Gabor升级到深度学习特征),不影响其他层,便于技术迭代和系统维护。
二、虹膜图像采集与预处理
2.1 近红外成像原理
虹膜识别几乎全部使用近红外(Near Infrared, NIR)成像而非可见光成像,这是由虹膜的光学特性决定的。可见光(400-700nm)下,虹膜的可见颜色(蓝、绿、棕、黑)由虹膜基质层中的黑色素含量决定——浅色虹膜(蓝/绿)黑色素少,纹理在可见光下可见;但深色虹膜(棕/黑,占全球人口大多数,尤其是亚洲和非洲人群)黑色素多,在可见光下纹理被色素掩盖,几乎看不到细节,无法用于识别。而在近红外波段(通常700-900nm,最常用850nm),黑色素的吸收显著降低,近红外光能够穿透虹膜基质层,揭示出深层的纹理结构——无论虹膜在可见光下是什么颜色,在近红外图像中都呈现出丰富的纹理细节(隐窝、褶皱、放射纹、色素斑等)。因此,近红外成像使得虹膜识别对所有人种、所有虹膜颜色都有效,这是虹膜识别能够全球推广的关键技术选择。
近红外成像系统通常由以下部分组成:①近红外LED光源——围绕镜头环形排列的850nm(或760nm/940nm)红外LED,提供均匀、无阴影的主动照明,功率在安全范围内(IEC 62471光生物安全标准,属于豁免组或低风险组),人眼不可见(850nm刚好在可见光谱边缘,人眼几乎看不到红光,不会引起不适或瞳孔收缩);②高灵敏度CMOS/CCD图像传感器——对近红外波段有高量子效率(通常在传感器前移除红外截止滤光片,或使用专门的近红外增强传感器),能够捕捉微弱的近红外反射信号;③微距光学镜头——短焦距、大光圈、高分辨率的微距镜头,工作距离通常10-30厘米,景深较浅,需要自动对焦或用户引导确保虹膜在焦平面上;④图像采集与处理单元——控制LED照明时序(常亮或频闪,频闪可降低功耗和热累积)、传感器曝光和增益、图像预处理(去噪、坏点校正、色彩插值),输出数字图像。
近红外图像的典型特征:①灰度图像——近红外传感器通常输出单通道灰度图(不使用Bayer色彩插值,因为近红外下颜色信息无意义且会降低分辨率),灰度值反映虹膜对近红外光的反射率;②高对比度纹理——瞳孔在近红外下呈深黑色(几乎不反射),巩膜呈亮白色(高反射),虹膜呈中灰色且纹理丰富,三者灰度差异大,便于边界检测;③低噪声——主动近红外照明提供了充足且均匀的光线,传感器可以用低增益和短曝光,图像噪声低;④对眼镜和反光敏感——眼镜片在近红外下可能产生反光(specular reflection),形成亮斑遮挡虹膜纹理,需要在分割和掩码中处理;⑤对睫毛和眼睑敏感——睫毛在近红外下呈黑色条状阴影,遮挡虹膜上部纹理,需要检测和掩码。
近年来,可见光虹膜识别(Visible Spectrum Iris Recognition, VSIR)也成为研究热点——利用普通手机/电脑的RGB可见光摄像头采集虹膜图像,不需要专用近红外硬件,成本低、部署方便、用户体验好(可以在使用手机时无感采集)。但可见光虹膜识别面临巨大挑战:深色虹膜纹理不可见、光照变化大、运动模糊严重、图像分辨率低(手机摄像头非微距设计)、眼镜反光和屏幕光干扰等。目前可见光虹膜识别主要通过深度学习方法(超分辨率重建、纹理增强、域适应NIR→VIS、鲁棒特征提取)来缓解这些问题,在受控条件下已经可以达到可用精度,但在非受控日常场景下的精度仍显著低于近红外专用设备。未来趋势是近红外与可见光融合、多光谱成像、以及手机内置近红外摄像头(部分高端手机已用于虹膜解锁,如三星Galaxy系列)。
2.2 采集设备与协议
虹膜采集设备根据形态和应用场景分为几类:①桌面式/立式虹膜采集仪——独立设备,带专用近红外摄像头和LED照明,用户站/坐在设备前,双目同时采集,用于边境通关、银行柜台、政务大厅等固定场景,采集质量最高(分辨率通常1000×1000以上,虹膜像素直径200以上);②手持虹膜采集终端——便携式设备,类似平板电脑或手持PDA,带近红外摄像头,用于现场执法、移动办公、野外采集等场景;③嵌入式虹膜模组——小型化模组(摄像头+LED+处理板,尺寸可小到几厘米),集成到门禁、门锁、手机、ATM、自助终端等设备中,是目前应用最广的形态;④手机虹膜识别——部分高端手机(三星Galaxy S8/S9/S10/Note系列、华为Mate 20 RS等)内置近红外虹膜摄像头,用于手机解锁和安全支付,采集距离近(20-30cm)、速度快(小于1秒),但分辨率和采集质量低于专用设备。
采集协议与用户引导是影响采集质量的关键环节。理想的虹膜采集需要用户满足:眼睛睁开(不眯眼、不被头发/帽子遮挡)、注视摄像头(虹膜中心正对镜头,减少偏角)、距离合适(通常15-30cm,在景深范围内)、不戴墨镜(普通近视/远视眼镜可以但可能有反光,隐形眼镜可以但彩色隐形眼镜会改变纹理需要检测)、环境光不太强(避免阳光直射导致近红外信号被淹没和瞳孔缩小)。采集系统通常通过实时质量引导帮助用户达到这些条件:①视觉反馈——屏幕上实时显示摄像头画面,用框/圆/十字标注虹膜检测位置,用颜色(绿/黄/红)表示质量是否达标,用箭头/文字提示用户移动方向(靠近/远离/左移/右移/抬头/低头);②语音反馈——语音提示"请注视摄像头""请靠近一点""请摘下墨镜"等,适合不看屏幕的用户;③自动捕获——当质量评估达到阈值时自动捕获图像,不需要用户按键,提升体验和一致性;④多帧选择——连续采集多帧(通常5-20帧),选择质量最高的一帧用于注册/识别,或多帧融合提升鲁棒性;⑤活体检测联动——采集同时进行活体检测(见后文),防止照片/视频/假眼攻击。
采集质量的量化指标通常包括:①虹膜像素直径——虹膜在图像中的像素直径,建议大于150像素(注册)和100像素(识别),直径越大纹理越清晰;②清晰度——虹膜区域的梯度/拉普拉斯方差,大于阈值表示清晰,模糊图像纹理不可辨;③虹膜可见度——未被眼睑/睫毛/反光/眼镜遮挡的虹膜面积比例,建议大于60-70%;④瞳孔直径比——瞳孔半径与虹膜半径之比,建议在0.2-0.7之间(瞳孔过小或过大都影响归一化和纹理);⑤偏角——虹膜平面与摄像头光轴的夹角,建议小于20-30度(偏角过大导致虹膜透视变形和外侧被眼睑遮挡);⑥对比度——虹膜与瞳孔/巩膜的灰度差,大于阈值表示边界清晰。这些指标综合为一个质量分数(0-100),注册时要求质量分数大于80-90,识别时大于60-70(识别可以容忍稍低质量,因为只需要与已注册模板匹配)。
2.3 图像预处理
采集到的原始近红外图像在进入检测和定位之前,通常需要进行基础预处理,提升图像质量并减少后续处理难度:①去噪——近红外图像虽然噪声低,但传感器在高增益或短曝光下仍有噪声,用高斯模糊(小核3×3,去噪同时保留边缘)、中值滤波(去除椒盐噪声和坏点)、双边滤波(去噪同时保边)、非局部均值去噪(NLM,效果好但计算慢)等方法;②坏点校正——传感器可能有坏点(常亮或常暗像素),用邻域插值或坏点表校正;③光照校正——近红外LED照明虽然均匀,但仍可能有中心亮边缘暗的渐晕(vignetting),用平场校正(Flat Field Correction,拍摄均匀白纸图像作为增益参考,逐像素校正增益)或Retinex算法(估计光照分量并去除,保留反射分量即纹理)校正不均匀光照;④对比度增强——原始图像对比度可能偏低,用直方图均衡化(HE,全局增强)、CLAHE(限制对比度自适应直方图均衡化,分块增强且限制对比度放大倍数,避免噪声放大,是最常用的方法)、伽马校正(调整灰度曲线,增强中灰区域纹理)等方法增强虹膜纹理对比度;⑤几何校正——镜头畸变(微距镜头可能有桶形或枕形畸变),用棋盘格标定得到畸变参数,校正图像几何;⑥分辨率处理——如果图像分辨率过高(如4000×3000),先降采样到合适尺寸(如1000×1000)减少计算量;如果分辨率过低,用超分辨率重建(深度学习方法如SRGAN/ESRGAN,或传统插值如双三次)提升纹理可见度;⑦ROI粗裁剪——如果整幅图像包含大量背景(如全脸或上半身),先用人脸/人眼检测粗裁剪出人眼区域,减少后续处理范围。预处理的目标是输出一幅噪声低、光照均匀、纹理清晰、尺寸合适的人眼灰度图像,供后续虹膜检测和定位使用。
三、虹膜检测(粗定位)
虹膜检测(Iris Detection)的任务是在整幅人眼图像(或全脸图像)中快速找到虹膜区域的大致位置和范围,输出一个包含虹膜的感兴趣区域(ROI),供后续精准定位和分割使用。检测不需要精确到像素级边界,只需要快速、鲁棒地框出虹膜区域,缩小后续处理范围(从整幅图像几百到几千像素缩小到ROI几百像素,计算量减少一个数量级以上)。虹膜检测的方法分为传统计算机视觉方法和深度学习方法两大类。
3.1 基于投影和形态学的快速检测
传统虹膜检测利用近红外图像中瞳孔和虹膜的灰度特性设计快速算法:①瞳孔暗区定位——在近红外图像中,瞳孔是最暗的区域(几乎不反射近红外光),灰度值远低于虹膜、巩膜和皮肤。通过全局阈值分割(Otsu自动阈值或固定阈值,如灰度小于30的区域)得到二值图,其中最大的暗色连通域通常就是瞳孔;②形态学操作——对二值图进行腐蚀(去除小噪点和睫毛)、膨胀(填充瞳孔内部的反光小孔)、开运算(先腐蚀后膨胀,分离瞳孔与睫毛等暗色连接)、闭运算(先膨胀后腐蚀,填充瞳孔内部孔洞),得到干净的瞳孔连通域;③连通域分析——计算各连通域的面积、周长、圆形度(4π面积/周长²,圆形接近1)、质心,选择面积在合理范围(不能太小如噪点,不能太大如闭眼/头发)、圆形度高(瞳孔近似圆形)、位置在图像中上部的连通域作为瞳孔候选;④水平/垂直灰度投影——对图像的水平行和垂直列计算灰度均值,瞳孔区域在投影图上表现为深谷(低灰度),通过寻找投影图中的深谷定位瞳孔的行范围和列范围;⑤虹膜区域估计——以瞳孔质心为中心,根据瞳孔半径估计虹膜外半径(虹膜外半径通常是瞳孔半径的2-4倍,因人因年龄因光照而异,通常取经验值如瞳孔半径x3),向外扩展得到包含完整虹膜的矩形ROI;⑥验证与回退——验证ROI内是否包含环形虹膜结构(瞳孔暗色+虹膜中灰+巩膜亮色的同心圆结构),如果检测失败(如闭眼、严重遮挡、图像质量差),返回失败并提示用户重新采集。传统方法的优势是计算极快(毫秒级,适合嵌入式设备)、不需要训练数据、可解释性强;劣势是对复杂背景、可见光图像、严重遮挡、非理想光照鲁棒性差,可能误检(把暗色痣、阴影、墨镜误判为瞳孔)。
3.2 基于深度学习的检测
深度学习方法将虹膜检测视为通用目标检测问题,用目标检测网络在图像中检测人眼或虹膜区域,在复杂场景下鲁棒性远高于传统方法:①检测网络——常用YOLO系列(YOLOv5/v8/v9/v11,速度快精度高,适合实时)、SSD(单发多框检测器,速度快)、Faster R-CNN(两阶段检测,精度高但速度稍慢)、MTCNN(多任务级联卷积神经网络,同时检测人脸和关键点,适合全脸图像中的人眼检测)、RetinaNet(焦点损失解决类别不平衡);②检测目标——可以检测整个人眼区域(包含眉毛、眼睑、虹膜、巩膜),也可以直接检测虹膜环形区域(更精确但标注成本高),还可以检测瞳孔中心和虹膜中心关键点(用于后续定位初始化);③训练数据——需要标注的虹膜/人眼检测数据集,公开数据集如CASIA-Iris、IITD、UBIRIS、MICHE(移动设备虹膜)等提供图像但不一定有检测框标注,需要自行标注(用LabelImg/CVAT标注人眼/虹膜框),或用传统方法自动生成粗标注再人工修正;④数据增强——训练时使用随机亮度/对比度/噪声(模拟不同近红外成像条件)、随机旋转/缩放/平移(模拟不同头部姿态和距离)、随机遮挡(模拟眼睑/睫毛/眼镜/头发遮挡)、Mosaic增强(多图拼接提升小目标检测)、可见光-近红外域适应(如果需要支持可见光图像);⑤推理优化——模型量化(INT8)、剪枝、蒸馏,部署到嵌入式NPU/FPGA/手机NPU,实现实时检测(30fps以上);⑥跟踪联动——视频流中,第一帧用检测网络定位虹膜,后续帧用轻量级跟踪器(KCF/CSRT/光流/关键点跟踪)跟踪虹膜位置,跟踪失败时重新触发检测,大幅降低计算量(检测只在1/N帧运行)。深度学习检测的优势是鲁棒性强(对复杂背景、遮挡、低质量、可见光都能稳定检测)、精度高(召回率和准确率可达95%以上)、可端到端训练优化;劣势是需要标注数据和训练、模型较大(需轻量化才能嵌入式部署)、可解释性弱于传统方法。生产系统通常采用"深度学习检测+传统方法验证"的混合策略,兼顾鲁棒性和可靠性。
3.3 ROI提取与质量初判
检测到虹膜位置后,需要提取ROI并进行初步质量判断:①ROI裁剪——以检测到的虹膜中心(或瞳孔中心)为中心,裁剪一个固定大小的正方形区域(如320×320或640×640,确保包含完整虹膜+瞳孔+部分巩膜和眼睑,外扩比例通常为虹膜估计半径的1.5-2倍),如果虹膜靠近图像边缘,用镜像填充或零填充避免越界;②ROI内质量初判——在ROI内快速评估:是否有足够大的暗色瞳孔区域(瞳孔面积占比大于2%)、虹膜环形结构是否存在(瞳孔外是否有中灰色环形区域)、是否严重模糊(拉普拉斯方差是否大于阈值)、是否有大面积反光(高亮像素占比是否小于10%);质量不达标时直接返回失败,不进入后续耗时的精准定位和分割,提升系统整体效率;③多帧选择——视频流中连续采集多帧,对每帧做检测和质量初判,选择质量最高的1-3帧进入后续精准处理,避免单帧偶然质量差导致识别失败;④ROI元数据记录——记录ROI在原图中的位置(x,y,width,height)、缩放比例、检测置信度,供后续坐标映射(将ROI内的定位结果映射回原图坐标)和可视化使用。ROI提取将后续处理从整幅图像缩小到几百像素的局部区域,是整套算法中"由粗到精"策略的关键第一步,大幅提升了处理速度和定位精度(排除了背景干扰)。
四、精准定位(内外边界精确定位)
精准定位(Precise Localization)是虹膜识别中最关键的环节之一,其任务是精确确定虹膜的三个边界参数:①内边界——瞳孔与虹膜的交界(近似圆形,参数为圆心坐标x_p,y_p和半径r_p);②外边界——虹膜与巩膜的交界(近似圆形,参数为圆心坐标x_i,y_i和半径r_i,注意内外圆的圆心通常不重合,瞳孔相对于虹膜有偏心,尤其是在注视方向偏离光轴时);③眼睑边界——上下眼睑与虹膜的交界(近似抛物线或圆弧,参数为抛物线的顶点和开口,用于标记被眼睑遮挡的虹膜区域)。精准定位的精度直接影响后续归一化和特征提取的质量——定位偏差几个像素就可能导致归一化后纹理错位,匹配时汉明距离显著上升。最经典的定位方法是Daugman积分微分算子和Hough变换,近年来深度学习方法也取得了优异效果。
4.1 Daugman积分微分算子
Daugman积分微分算子(Integro-Differential Operator)由John Daugman于1993年提出,是虹膜识别领域最经典、使用最广泛的定位方法,其核心思想是在三维参数空间(圆心x,y和半径r)中搜索,找到使沿圆周的灰度积分的径向导数最大的圆——因为在真实边界处,从圆内到圆外灰度发生突变(瞳孔内暗→虹膜中灰,虹膜中灰→巩膜亮),圆周积分的径向导数在边界处达到峰值。算子的数学表达式为:max_{r,x0,y0} | G_σ(r) * d/dr ∮_{r,x0,y0} I(x,y) / (2πr) ds |,其中I(x,y)是图像灰度,G_σ(r)是高斯平滑函数(标准差σ,用于平滑噪声和细微纹理,使边界峰更突出),∮是沿圆心(x0,y0)半径r的圆周积分,除以2πr是归一化(消除半径对积分值的影响),d/dr是对半径求导(检测灰度突变),max是在所有(r,x0,y0)参数组合中取最大值。
Daugman算子的工作流程:①参数空间初始化——定义半径搜索范围(瞳孔半径r_p通常5-80像素,虹膜半径r_i通常30-200像素,根据图像分辨率调整)、圆心搜索范围(整个ROI或粗检测得到的瞳孔中心附近)、搜索步长(半径步长1像素,圆心步长1-2像素,步长越小精度越高但计算量越大);②粗搜索——先用较大步长(如半径步长5、圆心步长5)和较大高斯σ(如σ=5)快速扫描参数空间,找到几个候选峰值位置;③精搜索——在候选峰值附近用小步长(半径步长1、圆心步长1)和较小高斯σ(如σ=2-3)精细搜索,精确定位边界参数;④先内后外——先定位瞳孔内边界(瞳孔暗区边界最明显,容易定位),再以瞳孔圆心为初始参考定位虹膜外边界(外边界对比度较低且可能被眼睑遮挡,需要以瞳孔圆心为中心缩小搜索范围);⑤高斯σ选择——σ越大平滑越强、对噪声越鲁棒但边界定位越模糊(可能偏移1-2像素);σ越小定位越精确但对噪声和纹理越敏感(可能被局部纹理干扰产生假峰)。通常内边界用较小σ(2-3),外边界用较大σ(4-6,因为外边界被眼睑遮挡且对比度低,需要更强平滑)。
Daugman算子的优势:①精度高——在高质量近红外图像上,内外边界定位精度可达亚像素级(误差小于1像素),是目前定位精度最高的方法之一;②鲁棒性较强——高斯平滑抑制了噪声和局部纹理干扰,圆周积分利用了全局信息(不是单个边缘点),对局部遮挡(如睫毛遮挡部分外边界)有一定容忍度;③直接输出圆参数——不需要后处理(如Hough变换需要从投票空间提取圆参数),算子最大值对应的参数就是边界参数。劣势:①计算量大——需要在三维参数空间穷举搜索,即使有粗精两级搜索,计算量仍较大(尤其是高分辨率图像),在嵌入式设备上可能需要优化(如用粗检测缩小搜索范围、用积分图加速圆周积分、用GPU并行计算);②对严重遮挡和非圆形边界敏感——如果外边界被眼睑大面积遮挡(超过1/3圆周),或虹膜因疾病/手术非圆形,圆周积分可能被遮挡区域误导,定位偏差;③初始值依赖——如果粗检测给出的瞳孔中心偏差较大,精搜索可能陷入局部最大值(定位到错误的圆,如眼眶边缘或眼镜框)。尽管有这些不足,Daugman积分微分算子因其高精度和鲁棒性,仍然是绝大多数商用虹膜识别系统的核心定位算法,OSIRIS等开源实现也采用此方法。
4.2 Hough变换方法
Hough变换(Hough Transform)是另一种经典的圆形边界定位方法,其核心思想是将图像空间中的圆形检测转化为参数空间中的投票峰值检测——图像中每个边缘点对所有可能经过该点的圆在参数空间中投一票,得票最多的参数组合就是最可能的圆。虹膜定位中使用圆形Hough变换(Circular Hough Transform, CHT),工作流程如下:①边缘检测——用Canny边缘检测器(或Sobel/Prewitt)对图像进行边缘检测,得到二值边缘图(边缘点为1,非边缘为0)。Canny边缘检测包括高斯平滑去噪、Sobel梯度计算、非极大值抑制(细化边缘)、双阈值滞后(强弱边缘连接),能得到较干净的边缘图;②感兴趣边缘筛选——在边缘图中,根据粗检测得到的瞳孔/虹膜位置和半径范围,筛选出可能属于瞳孔/虹膜边界的边缘点(排除眼睑、睫毛、眼镜框等无关边缘),减少后续投票计算量和干扰;③参数空间投票——对每个边缘点,在三维参数空间(圆心x,y,半径r)中对所有经过该点的圆投一票。为了减少计算量,通常固定半径范围和步长,对每个半径r,边缘点(x,y)对应的圆心轨迹是一个以(x,y)为圆心、r为半径的圆,在参数空间中对该圆上的所有点累加投票;④峰值提取——在参数空间中寻找投票数最高的峰值,峰值对应的(x,y,r)就是检测到的圆参数。通常先找瞳孔内边界(瞳孔边缘对比度高、边缘完整,投票峰明显),再在瞳孔圆心附近找虹膜外边界(外边缘可能被眼睑遮挡,投票峰可能不明显,需要限制搜索范围和用形状先验);⑤ refinement细化——Hough变换得到的圆参数精度受投票步长限制(通常1-2像素),可以在Hough结果基础上用主动轮廓模型(Snakes)或Daugman算子在小范围内精搜,提升到亚像素精度。
Hough变换的优势:①对遮挡和断裂边缘鲁棒——即使部分边界被眼睑/睫毛遮挡(边缘不完整),剩余的边缘点仍能在参数空间投票出正确的圆,这是Hough变换相比Daugman算子的重要优势(Daugman算子依赖完整圆周积分);②对噪声和杂边有一定容忍——投票机制本身具有统计鲁棒性,少量噪声边缘点不会显著影响峰值位置;③可以同时检测多个圆——参数空间中可以有多个峰值,适合同时检测瞳孔和虹膜(甚至双眼);④计算可优化——用梯度方向信息减少投票范围(每个边缘点只对梯度方向指向的圆心投票,而不是整圆投票,计算量大幅减少,称为梯度Hough变换)、用粗精两级搜索、用GPU并行。劣势:①精度低于Daugman算子——受投票步长和边缘检测质量限制,Hough变换定位精度通常1-3像素,低于Daugman的亚像素级,需要后处理细化;②对边缘检测质量依赖大——如果Canny边缘检测参数不合适(阈值过高漏检边缘、过低引入杂边),投票峰可能偏移或出现假峰;③参数空间内存大——三维参数空间(x,y,r)的累加数组内存占用大,高分辨率图像下需要优化(如分块处理、降分辨率投票再精搜);④假峰问题——眼镜框、眼眶、眼睑边缘可能产生与虹膜圆半径相近的假峰,需要用形状先验(瞳孔在虹膜内部、两圆近似同心)和位置先验排除。Hough变换常用于对遮挡鲁棒性要求高的场景,或作为Daugman算子的初始化/备选方法,两者结合可以兼顾精度和鲁棒性。
4.3 Wildes算法与其他定位方法
除了Daugman算子和Hough变换,还有几种有代表性的定位方法:①Wildes算法(Richard Wildes于1997年提出)——采用"边缘检测+Hough变换+主动轮廓细化"的级联策略:先用Canny边缘检测得到边缘图,用Hough变换在参数空间投票得到瞳孔和虹膜的粗圆参数,然后用主动轮廓模型(Active Contour,即Snakes)从粗圆开始演化,精确拟合内外边界(允许边界非完美圆形,处理局部形变和遮挡)。Wildes算法的优势是结合了Hough的鲁棒性和主动轮廓的精确性,对非理想边界和遮挡处理较好;劣势是计算量较大(Hough+Snakes两级处理),Snakes演化可能收敛到局部最优。Wildes算法是继Daugman之后最有影响力的虹膜识别算法框架之一,很多后续工作基于此框架改进。
②主动轮廓模型(Snakes/Level Set)——将边界建模为一条可演化的曲线,从初始位置(粗检测或Hough结果)开始,在图像梯度(吸引曲线到边缘)、内部能量(保持曲线光滑)、外部约束(限制形状为近似圆)的共同作用下演化到精确边界。Level Set方法用水平集函数表示曲线,能自然处理拓扑变化(如边界断裂和合并),适合被眼睑严重遮挡的情况。主动轮廓方法的优势是精度高(亚像素级)、能处理非圆形和局部遮挡、可加入多种先验约束;劣势是对初始位置敏感(初始离真实边界太远会收敛到错误位置)、计算量大(演化需要多次迭代)、参数调节复杂(内部能量和外部能量的权重需要调优)。
③基于回归的深度学习定位——用深度学习网络直接回归边界参数,或预测边界热图再拟合圆:·参数回归网络——用CNN(如ResNet/MobileNet)输入ROI图像,直接输出瞳孔和虹膜的圆心坐标和半径(共6个参数),用L1/L2损失训练,端到端回归,速度快但精度受限于回归精度;·热图回归网络——用Hourglass/U-Net等网络预测瞳孔边界和虹膜边界的高斯热图(边界处响应高),再从热图中用Hough变换或圆拟合提取圆参数,热图方法比直接回归精度更高(保留了空间信息),是目前人体姿态估计和人脸关键点检测的主流方法,迁移到虹膜边界定位效果好;·分割后拟合——先用语义分割网络(见第五章)得到虹膜/瞳孔/巩膜的像素级掩码,再从掩码中用Hough变换或最小二乘圆拟合提取边界参数,这种方法将定位和分割统一,精度高且鲁棒,是当前研究趋势;·多任务网络——同时做检测(人眼/虹膜框)、定位(边界参数/热图)、分割(像素掩码)、质量评估(质量分数),一个网络输出多个任务结果,共享特征提取,计算效率高,适合嵌入式部署。深度学习定位方法在遮挡、低质量、可见光、非理想成像等复杂场景下鲁棒性显著优于传统方法,是当前虹膜识别算法升级的重要方向,但传统方法(Daugman/Hough)在高质量近红外图像上精度仍最高且可解释性强,生产系统通常采用"传统方法为主+深度学习为辅/兜底"的混合策略。
4.4 眼睑边界定位
除了虹膜内外圆边界,还需要定位上下眼睑边界,因为眼睑会遮挡虹膜的上部和下部(通常遮挡20-40%的虹膜面积),被遮挡区域没有有效虹膜纹理,需要在后续归一化和掩码中标记为无效。眼睑边界定位方法:①抛物线/圆弧拟合——上下眼睑通常近似抛物线形(上眼睑开口向下,下眼睑开口向上)或圆弧形,用边缘检测(Canny/Sobel)在虹膜外边界附近提取眼睑边缘点,再用RANSAC(随机抽样一致性,鲁棒拟合,排除睫毛和噪点)或最小二乘法拟合抛物线(y = ax²+bx+c)或圆弧参数;②积分微分算子扩展——Daugman算子可以扩展为检测抛物线形眼睑边界,在抛物线参数空间(顶点位置、开口大小、曲率)搜索使沿抛物线积分导数最大的参数;③主动轮廓——用Snakes/Level Set从初始眼睑位置演化到精确眼睑边界,加入形状约束(上眼睑在虹膜上部、曲率范围合理)和灰度梯度约束;④深度学习分割/关键点——用语义分割网络直接分割眼睑区域(像素级),或用关键点检测网络预测眼睑轮廓点(如上下眼睑各10-20个点),再拟合曲线,深度学习方法对睫毛遮挡和低对比度鲁棒性强;⑤掩码生成——根据拟合的眼睑曲线,生成虹膜有效区域掩码:位于上下眼睑之间、内外圆之间的区域为有效虹膜,被眼睑覆盖的区域标记为无效(在归一化矩形图中对应行标记为遮挡)。眼睑定位的精度直接影响有效虹膜区域的大小——如果眼睑定位偏松(把眼睑区域误判为有效虹膜),会引入眼睑皮肤纹理作为噪声,导致匹配误判;如果偏紧(把有效虹膜误判为遮挡),会减少有效纹理位数,降低识别区分度。通常采用"偏紧"策略(宁可多标记一些遮挡,也不引入噪声),因为虹膜纹理信息冗余度高(2048位中只要有几百位有效就足以区分),少量遮挡不影响识别。
4.5 定位精度评估与优化
定位精度的评估指标:①边界交并比(IoU)——定位得到的圆与真实标注圆(人工标注的内外边界)的交集与并集之比,IoU大于0.95为优秀,大于0.90为良好;②圆心误差——定位圆心与真实圆心的欧氏距离(像素),小于1像素为亚像素级优秀,小于2像素为良好;③半径误差——定位半径与真实半径的绝对差(像素),小于1像素为优秀;④眼睑曲线误差——定位眼睑曲线与真实标注的平均距离(像素),小于2像素为良好;⑤定位成功率——在测试集中成功定位(不失败、不明显偏移)的比例,高质量近红外图像上应大于99%,复杂场景(可见光/遮挡/低质量)大于95%。
定位优化策略:①粗精两级搜索——先用大步长粗搜索缩小范围,再用小步长精搜索,兼顾速度和精度;②多尺度策略——先在降分辨率图像上粗定位(速度快),再在原始分辨率上精定位(精度高);③先内后外+约束——先定位瞳孔(对比度高、边缘完整),再以瞳孔圆心为中心、半径为参考,在合理范围内搜索虹膜外边界(外圆半径通常为瞳孔半径的2-4倍,两圆心偏差通常小于虹膜半径的10-20%),减少搜索空间和假峰;④高斯σ自适应——内边界用小σ(精确定位),外边界用大σ(抗遮挡抗噪声),或根据图像质量自适应调整σ(模糊图像用大σ,清晰图像用小σ);⑤多帧融合——视频流中对多帧的定位结果取平均或加权融合(质量高的帧权重高),减少单帧偶然误差;⑥失败检测与回退——如果定位结果不合理(如瞳孔半径大于虹膜半径、两圆心偏差过大、圆在图像外、边界处灰度差过小),判定为定位失败,切换方法(如Daugman失败则用Hough)或提示用户重新采集,避免错误定位传导到后续环节;⑦深度学习兜底——传统方法定位失败或置信度低时,用深度学习定位网络兜底,提升复杂场景下的成功率。定位是整套算法的基础,定位精度直接决定后续归一化和匹配的上限,因此生产系统通常在定位环节投入最多的优化effort,采用多方法融合和多策略回退确保高成功率和高精度。
五、虹膜分割
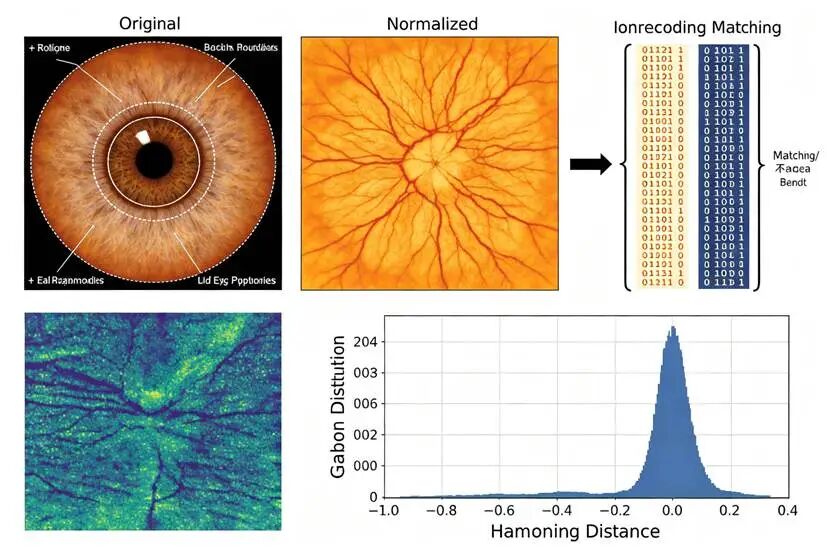
虹膜识别算法原理与效果对比:原始图像内外边界定位→归一化矩形纹理展开→虹膜编码匹配汉明距离计算→Gabor小波与汉明距离分布
虹膜分割(Iris Segmentation)的任务是将虹膜像素从图像中精确分离出来,生成像素级的虹膜掩码(mask),标注每个像素是否属于有效虹膜区域,以及遮挡类型(眼睑、睫毛、反光、眼镜、背景等)。精准定位给出的是虹膜内外边界的圆参数和眼睑曲线参数,基于这些几何参数可以直接生成一个几何掩码(圆和抛物线定义的区域),这是最简单的分割方法。但几何掩码假设虹膜边界是完美的圆形和抛物线,且没有考虑睫毛、反光、眼镜框、局部虹膜病变等非理想情况,在复杂场景下分割精度不足。因此,更精确的分割需要用传统图像分割方法或深度学习语义分割方法,生成像素级的精确掩码。分割精度直接影响后续归一化和特征提取——如果把非虹膜像素(如巩膜、眼睑、睫毛、反光)误判为有效虹膜,会引入噪声纹理导致匹配误判;如果把有效虹膜像素误判为遮挡,会减少有效特征位数降低区分度。
5.1 传统分割方法
传统虹膜分割方法基于几何模型和图像灰度特性:①几何掩码法——直接用精准定位得到的内圆(瞳孔边界)、外圆(虹膜边界)、上下眼睑曲线生成掩码:位于外圆内、内圆外、上下眼睑之间的像素标记为有效虹膜,其余标记为无效(瞳孔/巩膜/眼睑/背景)。这种方法最简单、速度最快(只需几何计算,不需要图像处理),在高质量近红外图像上效果可接受;但对非圆形边界、局部遮挡、睫毛、反光处理粗糙,分割精度有限。②主动轮廓模型(Snakes/Level Set)——从几何掩码的边界开始,用Snakes(参数化主动轮廓)或Level Set(几何主动轮廓)演化到精确的虹膜边界。Snakes用一条参数化曲线,在内部能量(光滑性、弹性)和外部能量(图像梯度,吸引曲线到边缘)作用下演化;Level Set用水平集函数隐式表示曲线,能自然处理拓扑变化(如边界被睫毛断裂后再合并)。主动轮廓方法能处理非完美圆形边界和局部形变,精度高于纯几何掩码;但对初始位置敏感、计算量大、参数调节复杂。③区域生长与分水岭——从虹膜种子区域(几何掩码中心区域)开始,根据灰度相似性(邻域像素灰度差小于阈值)向周围生长,直到遇到边界(灰度突变)或图像边缘。分水岭算法将图像视为拓扑地形,灰度值为高度,从种子区域注水,分水岭线即为区域边界。区域生长方法简单直观,但对噪声和灰度不均匀敏感,可能过度生长(侵入巩膜或眼睑)或生长不足(遗漏边缘虹膜)。④基于灰度阈值的分割——利用近红外图像中瞳孔(暗)、虹膜(中灰)、巩膜(亮)的灰度差异,用Otsu自动阈值或多阈值分割将图像分为三类,再结合形态学操作(腐蚀膨胀去除噪点、连通域分析选择最大区域)得到虹膜区域。这种方法速度快,但对光照不均匀和灰度重叠(如浅色虹膜与巩膜灰度接近、深色虹膜与瞳孔灰度接近)处理差。⑤混合方法——生产系统通常将多种传统方法结合:先用几何掩码得到粗分割,再用主动轮廓或区域生长在边界附近细化,最后用形态学操作和连通域分析清理掩码(去除小噪点、填充孔洞)。传统方法的优势是不需要训练数据、可解释性强、计算量可控;劣势是在遮挡、低质量、可见光、非理想成像等复杂场景下精度和鲁棒性不足,F1分数通常在0.75-0.85之间(据文献统计),难以满足高安全要求。
5.2 深度学习分割方法
深度学习语义分割方法将虹膜分割视为像素级分类问题,用卷积神经网络(CNN)端到端学习从图像到掩码的映射,在复杂场景下精度和鲁棒性显著优于传统方法,是当前虹膜分割的研究热点和升级方向。主流网络架构包括:①U-Net——最经典的医学图像分割网络,由编码器(下采样提取语义特征)和解码器(上采样恢复空间分辨率)组成,中间通过跳跃连接(skip connection)将编码器的浅层细节特征传递到解码器,融合深层语义和浅层细节,适合小样本和精细边界分割。U-Net在虹膜分割上表现优异,F1可达0.96-0.98,是目前最常用的虹膜分割网络。②U-Net++——U-Net的改进版,通过嵌套的密集跳跃连接和深度监督,减少编码器和解码器特征的语义差距,提升分割精度,在虹膜分割上比U-Net略有提升(F1高0.5-1%)。③FCN(全卷积网络)——将分类网络的全连接层替换为卷积层,实现端到端像素级预测,是语义分割的开创性工作,但分割边界较粗糙,在虹膜分割上精度低于U-Net。④Mask R-CNN——两阶段实例分割网络,先检测目标(人眼/虹膜框),再在框内预测实例掩码,适合同时做检测和分割,多任务共享特征,计算效率高,但掩码精度略低于U-Net。⑤SegNet/DeepLab系列——SegNet用编码器-解码器结构和池化索引上采样;DeepLab用空洞卷积(atrous convolution)扩大感受野和条件随机场(CRF)细化边界,在大目标和复杂场景下表现好,但计算量较大。⑥注意力机制增强——在U-Net等基础网络上加入通道注意力(SE Block、CBAM)、空间注意力、自注意力(Transformer),让网络聚焦虹膜纹理区域和边界,抑制眼睑、睫毛、反光等干扰,在遮挡和低对比度场景下提升分割精度。⑦多尺度特征融合——融合不同层级的特征(浅层细节+深层语义),用特征金字塔网络(FPN)、空洞空间金字塔池化(ASPP)等结构,提升对不同大小虹膜和细节结构的分割能力。⑧轻量级网络——为嵌入式和移动端部署,用MobileNet/EfficientNet/ShuffleNet作为编码器骨干,或用知识蒸馏、模型剪枝、量化压缩U-Net,在保持精度的同时将模型压缩到几MB、推理时间降到几毫秒。
深度学习虹膜分割的训练要点:①标注数据——需要像素级标注的虹膜图像,公开数据集如CASIA-Iris、IITD、UBIRIS等通常只有图像没有像素标注,需要自行标注(用LabelMe/CVAT标注虹膜/瞳孔/巩膜/眼睑/睫毛/反光/背景等类别),或用传统方法自动生成粗标注再人工修正。标注类别通常分为:有效虹膜、瞳孔、巩膜、上眼睑、下眼睑、睫毛、反光、眼镜、背景,共8-10类;也可以简化为二分类(有效虹膜/非虹膜),但多类别分割能提供更丰富的遮挡信息。②数据增强——训练时使用:随机亮度/对比度/伽马(模拟不同近红外成像条件)、随机噪声(高斯/椒盐,模拟传感器噪声)、随机旋转/缩放/平移(模拟不同头部姿态和距离)、随机遮挡(模拟眼睑/睫毛/眼镜/头发遮挡)、弹性形变(模拟虹膜非刚性形变)、MixUp/CutMix(混合样本提升泛化)、可见光-近红外域适应(如果需要支持可见光图像,用CycleGAN/域对抗训练将NIR知识迁移到VIS)。③损失函数——常用交叉熵损失(CE)、Dice损失(解决类别不平衡,虹膜像素占比小)、Focal Loss(聚焦难分样本,如边界和遮挡区域)、边界损失(Boundary Loss,用距离场惩罚边界偏差)、组合损失(CE+Dice+Focal,加权组合)。多类别分割用加权交叉熵(给虹膜和边界类别更高权重)。④训练策略——预训练(在ImageNet或大规模虹膜数据上预训练编码器,再在目标数据集微调)、早停(验证集损失不再下降时停止,防止过拟合)、学习率调度(余弦退火/ReduceLROnPlateau)、数据平衡(确保不同质量、不同遮挡程度的样本均衡)、交叉验证(K折交叉验证评估泛化性能)。⑤评估指标——像素准确率(Pixel Accuracy)、交并比(IoU/Jaccard)、Dice系数(F1分数,2TP/(2TP+FP+FN))、边界F1(Boundary F1,评估边界定位精度)、 Hausdorff距离(最大边界偏差)。高质量近红外图像上U-Net的IoU可达0.95以上,F1 0.96-0.98,远超传统方法的0.75-0.85。
深度学习分割的优势:①精度高——F1 0.96-0.98,IoU 0.95+,边界定位精确,能处理传统方法难以处理的遮挡和低质量图像;②鲁棒性强——对眼睑/睫毛/反光/眼镜/光照不均/运动模糊/可见光等复杂场景都能稳定分割,泛化能力强;③端到端——不需要手动设计特征和参数,数据驱动,标注数据足够时性能持续提升;④多任务——可以同时输出分割掩码、边界热图、质量分数、检测框,一个网络完成多个任务。劣势:①需要标注数据——像素级标注成本高(每张图标注需要5-15分钟),公开标注数据集少;②模型较大——原始U-Net几十MB,需要轻量化才能嵌入式部署;③可解释性弱——黑盒模型,分割错误难以分析和调试;④域迁移问题——在NIR上训练的模型直接用于VIS或不同设备时性能下降,需要域适应;⑤边缘情况——极端遮挡(如闭眼、眼镜严重反光)、疾病虹膜(如白内障、虹膜异色)、人工虹膜(美瞳、虹膜修复手术)等训练数据中少见的情况,模型可能失败。生产系统通常采用"深度学习分割为主+传统几何掩码兜底"的策略:深度学习模型输出像素级掩码,如果模型置信度低或分割结果明显不合理(如虹膜面积异常、边界不连续),回退到几何掩码,确保系统稳定性。
5.3 遮挡处理
虹膜图像中常见的遮挡类型和处理方法:①眼睑遮挡——上下眼睑遮挡虹膜上部和下部,是最常见的遮挡(通常遮挡20-40%虹膜面积)。处理:通过眼睑边界定位(见4.4节)生成眼睑掩码,将被眼睑覆盖的区域标记为无效,不参与后续特征提取和匹配。眼睑遮挡是"良性遮挡"——被遮挡区域完全没有虹膜纹理,标记为无效即可,不会引入噪声。②睫毛遮挡——上眼睑的睫毛向下投射,在虹膜上部形成黑色条状阴影,遮挡部分虹膜纹理。处理:·检测——用阈值分割(睫毛在近红外下呈深黑色条状,灰度低于虹膜)、形态学操作(细长结构元素的开运算提取睫毛)、深度学习分割(多类别分割中单独标注睫毛类别)检测睫毛区域;·掩码——将睫毛区域标记为无效;·修复(可选)——如果睫毛遮挡面积不大,可以用周围虹膜纹理插值修复(如Telea算法、Navier-Stokes修复、深度学习修复如LaMa),生成完整的虹膜纹理图用于可视化,但修复区域在匹配时仍应标记为无效(修复纹理是假的,不能用于身份识别)。③反光(Specular Reflection)——近红外LED光源在角膜、眼镜片、隐形眼镜上反射形成的亮斑,在图像中呈纯白色(灰度饱和),遮挡下方虹膜纹理。处理:·检测——用阈值分割(灰度大于250或饱和像素)、连通域分析(反光通常是几个小的圆形/椭圆形亮斑)、深度学习分割(单独标注反光类别)检测反光区域;·掩码——将反光区域标记为无效;·修复(可选)——用周围纹理插值修复反光区域,用于可视化;·硬件缓解——在采集端用偏振滤光片(减少角膜和眼镜反光)、多角度LED照明(分散反光位置)、抗反光镀膜镜头,从源头减少反光。④眼镜遮挡——框架眼镜的镜框可能遮挡虹膜边缘,镜片可能产生反光和畸变。处理:·镜框检测——用边缘检测和形态学操作检测镜框(深色弧形结构),标记为遮挡;·镜片反光——同反光处理;·建议——采集时建议用户摘下眼镜(如果可能),或使用抗反光镜片和偏振照明;隐形眼镜(透明)通常不影响,但彩色隐形眼镜(美瞳)会改变虹膜纹理,需要检测并拒绝(见活体检测章节)。⑤头发/帽子/手遮挡——用户的头发刘海、帽子帽檐、手等可能遮挡眼睛和虹膜。处理:在检测和质量评估阶段检测大面积遮挡,提示用户移开遮挡物重新采集,不尝试修复(大面积遮挡无法可靠修复)。⑥运动模糊/离焦模糊——用户移动或对焦不准导致图像模糊,虹膜纹理不可辨。处理:在质量评估阶段检测模糊(拉普拉斯方差低于阈值),拒绝并提示重新采集,不尝试用去模糊算法恢复(去模糊可能引入伪纹理,影响识别安全性)。遮挡处理的核心原则是:能标记为无效的就标记(不引入噪声),能在采集端避免的就避免(硬件和用户引导),只有用于可视化时才修复(修复区域不参与匹配)。虹膜纹理信息冗余度高(2048位编码中只要有几百位有效就足以区分百万级人群),因此30-40%的遮挡通常不影响识别精度,关键是准确标记遮挡区域避免噪声。
5.4 分割质量评估
分割质量评估用于判断分割结果是否可靠,不可靠时回退到几何掩码或提示重新采集:①掩码完整性——有效虹膜区域面积占理论虹膜面积(外圆面积减内圆面积)的比例,大于50-60%为可接受,大于70%为良好;如果有效面积过小(如小于30%),说明遮挡太严重,拒绝。②边界连续性——虹膜外边界和内边界是否连续(没有大的断裂),用边界像素的连通性和曲率变化评估,边界断裂可能意味着分割失败或严重遮挡。③形状合理性——分割得到的虹膜区域是否近似环形(外圆内圆之间),面积、长宽比、偏心度是否在合理范围;如果形状明显异常(如只有一半虹膜、虹膜区域侵入巩膜或瞳孔),判定为分割失败。④边界灰度差——分割边界两侧的灰度差是否足够大(瞳孔-虹膜边界灰度差大于20,虹膜-巩膜边界灰度差大于15),灰度差小说明边界不清晰,分割可能不准。⑤深度学习置信度——如果用深度学习分割,网络输出的softmax概率/熵可以作为置信度,平均置信度大于0.9为可靠,低于0.7为不可靠;也可以用测试时增强(TTA,多次翻转/缩放预测取平均)的一致性作为置信度(一致性高说明分割稳定)。⑥与几何掩码的一致性——深度学习分割结果与几何掩码的IoU,如果IoU大于0.9说明两者一致,分割可靠;如果IoU小于0.7说明两者差异大,可能其中一个失败,需要人工判断或回退。分割质量评估是整套算法的"安全网"——确保只有高质量的分割结果进入后续归一化和特征提取,低质量结果及时拒绝或回退,避免错误传导导致识别失败。
六、归一化与图像增强(标准判断)
归一化(Normalization)是虹膜识别中最具特色的环节之一,其任务是将环形的虹膜区域展开为固定大小的矩形图像,消除不同采集条件下的几何变化,使得同一个人的虹膜在不同时间、不同设备、不同距离、不同瞳孔大小下采集的图像,归一化后具有相同的尺寸和纹理位置,从而可以直接比较。用户提到的"标准判断"即指归一化(标准化)和质量判断——将虹膜纹理标准化到统一坐标系,并判断标准化后的纹理质量是否满足识别要求。如果不归一化,同一个人的虹膜在瞳孔放大和缩小时纹理位置会径向移动,匹配时汉明距离会显著上升,无法识别。Daugman提出的"橡胶片模型"(Rubber Sheet Model)是最经典的归一化方法,至今仍是绝大多数虹膜识别系统的标准做法。
6.1 Daugman橡胶片模型
Daugman橡胶片模型的核心思想是将虹膜环形区域视为一个可以均匀拉伸的橡胶片,将其从极坐标映射到固定大小的矩形坐标。具体来说,对于虹膜区域内的任意一点,其位置可以用极坐标(r,θ)表示,其中r是相对于瞳孔边界的径向距离(r=0在瞳孔边界,r=1在虹膜外边界),θ是角度(0到2π)。橡胶片模型将(r,θ)线性映射到矩形坐标(x,y),其中x对应角度θ(水平方向,通常0到511列),y对应径向距离r(垂直方向,通常0到63行)。映射公式为:对于归一化矩形中的每个像素(x,y),对应原始图像中的位置为:I(x,y) = (1-r)·I_pupil(θ) + r·I_iris(θ),其中r = y/height(径向比例,0到1),θ = 2π·x/width(角度,0到2π),I_pupil(θ)是角度θ处瞳孔边界上的点坐标,I_iris(θ)是角度θ处虹膜外边界上的点坐标。换句话说,对于每个角度θ,从瞳孔边界点到虹膜外边界点之间的线段被均匀采样为height个点(如64个),所有角度的采样线排列起来就形成了width×height的矩形归一化图(如512×64)。
橡胶片模型的关键特性:①瞳孔缩放不变性——无论瞳孔放大还是缩小,瞳孔边界(r=0)和虹膜外边界(r=1)之间的区域总是被映射到相同的矩形尺寸,因此同一个纹理特征(如某个隐窝)在瞳孔大小不同时,归一化后位于相同的矩形位置(径向比例相同),消除了瞳孔缩放的影响。这是虹膜识别能够在不同光照(光照变化导致瞳孔大小变化)下稳定识别的关键。②距离不变性——用户离摄像头远时虹膜在图像中小,近时大,但归一化后都映射到相同尺寸,消除了采集距离的影响。③旋转表示——角度θ映射到水平坐标x,因此头部旋转或眼球转动会导致归一化图的水平位移(整个纹理向左或向右移动),这可以通过匹配时的循环移位(见第八章)来补偿,不需要在归一化阶段校正。④内外圆心偏心处理——瞳孔圆心和虹膜圆心通常不重合(瞳孔相对虹膜有偏心,尤其是注视方向偏离光轴时),橡胶片模型在每个角度θ分别计算瞳孔边界点和虹膜外边界点(用各自的圆心和半径),因此自然处理了偏心,不需要假设两圆同心。⑤非圆形边界处理——如果用主动轮廓或深度学习分割得到了非圆形的精确边界,可以在每个角度θ用实际边界点坐标(而不是圆参数计算),橡胶片模型同样适用,不限于圆形边界。⑥采样与插值——原始图像中的采样点可能不是整数坐标,用双线性插值(最常用,效果和速度平衡)或双三次插值(质量更高但稍慢)获取灰度值。归一化图的典型尺寸是64行×512列(Daugman原始设置),也可以用32×256(更快,纹理细节稍少)或128×1024(更精细,计算量大),64×512是精度和速度的最佳平衡,被OSIRIS等主流实现采用。
6.2 瞳孔缩放不变性与生理约束
瞳孔缩放不变性是橡胶片模型最重要的特性,但需要注意几个生理约束:①瞳孔缩放范围——人眼瞳孔直径在强光下约2-3mm,弱光下约7-8mm,虹膜外径约11-12mm,因此瞳孔半径与虹膜半径之比在0.17(强光,瞳孔小)到0.67(弱光,瞳孔大)之间变化。橡胶片模型在这个范围内都能有效归一化,但瞳孔过大时(r_pupil/r_iris > 0.6),虹膜环形区域过窄,纹理信息量减少,识别精度可能下降;瞳孔过小时(比值小于0.2),瞳孔边界附近的纹理可能因瞳孔边界模糊而定位不准。采集时通常控制光照使瞳孔直径比在0.3-0.5之间(最佳范围)。②虹膜纹理的径向拉伸——真实虹膜纹理在瞳孔缩放时并不是完全均匀拉伸的(虹膜基质有弹性,但纹理的相对位置变化并非完全线性),橡胶片模型假设均匀拉伸是一种近似,在极端瞳孔变化下可能有少量纹理错位。研究表明,在正常瞳孔变化范围内(比值0.2-0.6),均匀拉伸假设的误差很小(归一化后纹理错位小于2-3像素),匹配时的循环移位和容错阈值可以吸收这些误差;极端变化下可以用非线性映射(如根据虹膜生理模型调整径向采样密度)进一步提升精度,但复杂度高,实际系统很少用。③瞳孔边界的可见性——深色虹膜在近红外下瞳孔边界清晰(瞳孔黑、虹膜中灰,对比度高),但浅色虹膜或有虹膜病变时边界可能模糊,定位误差会传导到归一化。用深度学习分割得到精确的瞳孔边界掩码,可以提升归一化精度。④采集时的瞳孔一致性——注册和识别时尽量保持相似的光照条件(瞳孔大小相近),可以减少归一化误差,提升匹配精度。高安全系统(如金融)通常在采集端控制光照强度,确保瞳孔大小在最佳范围。
6.3 旋转归一化与角度估计
头部旋转和眼球转动会导致虹膜在图像中旋转,归一化后表现为矩形图的水平位移(角度θ偏移)。处理旋转有两种策略:①匹配时循环移位补偿(最常用)——不在归一化阶段校正旋转,而是在匹配时将一个虹膜编码在水平方向循环移位±15度(对应512列中约±21列,因为360度对应512列,15度对应512×15/360≈21列),计算所有移位下的汉明距离,取最小值作为最终匹配分数。这种方法简单、鲁棒,不需要精确估计旋转角度,且循环移位自然处理了角度的周期性(0度和360度相同),是Daugman原始方法和绝大多数商用系统的标准做法。移位范围通常±15到±30度(覆盖正常头部旋转范围),移位步长1列(1度对应约1.4列,1列对应约0.7度,步长1列精度足够)。②归一化阶段旋转校正(可选)——如果需要在归一化阶段就校正旋转(如用于可视化或减少匹配时的移位范围),需要先估计旋转角度:·特征点法——检测虹膜中的稳定特征点(如隐窝、色素斑),匹配注册和识别图像中的特征点,估计旋转角度;·纹理相关法——将归一化图在水平方向自相关,找到最大相关位移作为旋转角度(但这需要先有参考角度,通常用于注册时建立基准);·几何法——利用眼睑的倾斜角度(上下眼睑连线的倾斜)估计头部旋转,但眼睑倾斜与虹膜旋转不完全一致,精度有限。旋转校正后,归一化图的纹理位置与注册模板对齐,匹配时只需要小范围移位(±5度)。但旋转校正需要精确估计角度,估计误差反而可能引入额外错位,因此实际系统通常更倾向于用匹配时循环移位的策略,简单可靠。③大角度旋转——如果旋转角度超过±30度(如严重侧头),虹膜会被眼睑严重遮挡(外侧虹膜被眼睑覆盖),且透视变形大,此时应拒绝识别并提示用户正视摄像头,而不是尝试校正。
6.4 图像增强
归一化后的虹膜纹理图虽然尺寸统一,但可能存在对比度低、光照不均、噪声等问题,需要图像增强提升纹理可辨性:①直方图均衡化(HE)——全局调整灰度分布,使直方图均匀分布,提升整体对比度。简单快速,但可能过度增强噪声和放大局部对比度不均,在虹膜纹理增强中效果一般。②CLAHE(限制对比度自适应直方图均衡化)——将图像分为小块(如8×8),对每块做直方图均衡化,且限制对比度放大倍数(clip limit通常2.0-4.0),防止噪声过度放大,块间用双线性插值消除边界。CLAHE能有效增强虹膜局部纹理(隐窝、褶皱、放射纹),同时抑制噪声,是虹膜图像增强中最常用的方法。③Retinex算法——基于视网膜皮层理论,将图像分解为光照分量(慢变化,反映光照不均)和反射分量(快变化,反映纹理),去除光照分量保留反射分量,消除光照不均(如中心亮边缘暗的渐晕),增强纹理对比度。常用单尺度Retinex(SSR)、多尺度Retinex(MSR)、带色彩恢复的MSR(MSRCR),对光照不均的虹膜图像效果好,但计算量较大。④伽马校正——用幂函数调整灰度曲线(I_out = I_in^γ),γ小于1增强暗部纹理,γ大于1增强亮部纹理。可以根据图像平均灰度自适应选择γ(暗图像用γ小于1,亮图像用γ大于1),简单有效,常作为预处理步骤。⑤高斯模糊去噪——用小核(3×3或5×5)高斯模糊去除传感器噪声,但可能模糊纹理细节,需要权衡核大小(通常3×3,去噪同时保留主要纹理)。也可以用双边滤波(保边去噪)或非局部均值去噪(NLM,效果好但慢)。⑥锐化增强——用Unsharp Mask(USM,原图像加原图像与高斯模糊的差值)或拉普拉斯锐化增强纹理边缘和细节,使隐窝和褶皱更清晰。但锐化也会放大噪声和伪影,需要控制锐化强度(通常amount 0.5-1.0)。⑦组合增强策略——生产系统通常组合多种方法:先去噪(高斯/双边)→光照校正(Retinex/平场校正)→对比度增强(CLAHE)→轻微锐化(USM),逐步提升纹理质量。增强的目标是让虹膜纹理(隐窝、褶皱、放射纹、色素斑)清晰可辨,同时不引入伪影和过度噪声。需要注意的是,图像增强必须在注册和识别时使用完全相同的增强参数和流程(否则同一虹膜在注册和识别时增强后纹理不同,导致匹配分数下降),因此增强算法的参数应固定(或基于图像统计量自适应,但自适应逻辑必须一致),不能在识别时随意调整。
6.5 质量评估(标准判断)
质量评估是"标准判断"的核心——判断归一化后的虹膜纹理是否满足识别要求,不满足时拒绝并提示重新采集。质量评估指标包括:①清晰度(Sharpness)——虹膜纹理是否清晰可辨,用拉普拉斯方差(对归一化图计算拉普拉斯响应的方差,方差大表示边缘多、清晰)、Tenengrad梯度(Sobel梯度的平方和,梯度大表示清晰)、Brenner梯度(相邻像素差的平方和)等指标。清晰度低于阈值说明图像模糊(运动模糊/离焦),纹理不可辨,拒绝。②虹膜可见度(Iris Visibility)——有效虹膜区域(未被眼睑/睫毛/反光遮挡)占归一化图总面积的比例,大于60%为可接受,大于70%为良好。可见度过低说明遮挡太严重,有效纹理信息不足,拒绝。③纹理丰富度(Texture Richness)——虹膜纹理是否足够丰富(有足够的隐窝、褶皱、色素斑等特征用于区分),用灰度方差(纹理丰富的图像灰度方差大)、梯度能量、LBP熵等指标。极少数人的虹膜纹理稀疏(如浅色虹膜、老年人虹膜萎缩、虹膜病变),纹理丰富度低,识别区分度可能不足,需要评估是否适合用虹膜识别(或结合其他生物特征)。④瞳孔直径比(Pupil Diameter Ratio)——瞳孔半径与虹膜半径之比,在0.2-0.6之间为最佳,小于0.1或大于0.7时虹膜环形区域过窄或瞳孔边界模糊,归一化误差大,拒绝或提示调整光照。⑤对比度(Contrast)——虹膜纹理的灰度对比度,用虹膜区域的灰度标准差或最大最小灰度差,大于阈值说明纹理对比明显,可辨性好。⑥反光面积(Specular Reflection Area)——反光像素占有效虹膜区域的比例,小于5%为可接受,大于10%说明反光严重,拒绝(或修复后标记为无效,但大面积反光修复不可靠)。⑦睫毛遮挡比例——睫毛遮挡像素占有效虹膜区域的比例,小于15%为可接受,大于30%说明睫毛遮挡严重,拒绝或提示用户眨眼/抬眉。⑧几何合理性——内外圆心偏心度(两圆心距离与虹膜半径之比)小于0.2为正常,大于0.3说明用户偏角过大,透视变形严重,拒绝;虹膜外边界与眼睑的交点位置合理(上眼睑在虹膜上部1/4-1/2,下眼睑在下部1/4-1/2),异常说明定位或分割失败。⑨综合质量分数——将上述各指标加权综合为0-100的质量分数,注册时要求大于80-90(确保模板质量高),识别时要求大于60-70(识别可以容忍稍低质量,因为只需要与已注册模板匹配)。质量评估是整套算法的"守门员"——确保只有满足质量标准的虹膜图像进入特征提取和模板库,低质量图像及时拒绝,避免低质量模板入库导致后续识别失败(这是虹膜识别系统中最常见的问题之一:注册时质量差,模板本身就有噪声,后续识别时FRR高)。
七、特征提取与虹膜编码
特征提取与编码的任务是从归一化后的虹膜纹理图中提取具有区分性的特征,并量化为紧凑的二进制编码(IrisCode,虹膜编码),用于后续匹配和存储。虹膜编码需要满足:①区分性——不同人的虹膜编码差异大(汉明距离接近0.5,即近似随机独立);②稳定性——同一个人的虹膜在不同时间、不同采集条件下编码差异小(汉明距离接近0);③紧凑性——编码长度适中(通常2048-16384位,即256字节-2KB),便于存储和快速匹配;④对光照和对比度鲁棒——只编码纹理的相位/结构信息,不编码绝对灰度,因此光照变化不影响编码。最经典的特征提取方法是Daugman提出的2D Gabor小波相位编码,生成2048位IrisCode,至今仍是绝大多数商用系统的标准方法。近年来,Log-Gabor、小波包、LBP、深度学习特征等方法也被提出,在特定场景下有优势。
7.1 Daugman 2D Gabor小波特征
Daugman于1993年提出用2D Gabor小波提取虹膜纹理特征,其核心思想是:虹膜纹理由不同频率、不同方向的条纹结构组成,用多尺度多方向的2D Gabor滤波器组对归一化虹膜纹理进行卷积,可以提取出丰富的纹理特征;Gabor滤波器的响应包含幅度和相位,其中相位信息对光照和对比度变化鲁棒(光照变化主要改变幅度,相位相对稳定),因此只保留相位信息并量化为二进制编码,生成对光照不变的虹膜特征。2D Gabor滤波器的数学表达式为:G(x,y;λ,θ,σ,γ) = exp(-(x'²+γ²y'²)/(2σ²)) · exp(i(2πx'/λ)),其中x' = x cosθ + y sinθ,y' = -x sinθ + y cosθ,λ是正弦波波长(决定频率,λ越小频率越高),θ是滤波器方向(0到π,决定响应的条纹方向),σ是高斯包络标准差(决定滤波器空间尺寸,σ越大感受野越大),γ是空间纵横比(决定滤波器形状,γ=1为圆形,γ<1为椭圆形),实部和虚部分别是余弦和正弦调制的高斯包络。
Gabor滤波器提取虹膜特征的过程:①滤波器组设计——选择多个尺度(波长λ,如4个尺度对应不同频率:低频捕捉大褶皱,高频捕捉细微隐窝)和多个方向(θ,如4个方向:0°、45°、90°、135°,捕捉不同走向的纹理),组成4×4=16个Gabor滤波器。也可以用更多尺度和方向(如5×8=40个),提取更丰富特征,但编码长度和计算量增加。Daugman原始方法用约1-2个尺度和多个方向,生成2048位编码。②卷积——对归一化虹膜纹理图(64×512)用每个Gabor滤波器进行卷积,得到复数响应图(实部+虚部,每个像素一个复数值)。卷积可以用空间域卷积(直接卷积,适合小核)或频域卷积(FFT加速,适合大核),Gabor核通常不大(σ对应10-30像素),空间域卷积即可。③相位量化——对每个像素的复数响应,只保留相位角(arg(响应) = atan2(虚部, 实部)),将相位角量化为2位二进制:相位角在[0, π/2)编码为00,[π/2, π)编码为01,[π, 3π/2)编码为10,[3π/2, 2π)编码为11。2位编码对应复平面的四个象限,只保留相位所在象限,丢弃相位的精确值和幅度信息。④下采样——如果对每个像素都编码,64×512×16滤波器×2位=1,048,576位(128KB),太长且冗余(相邻像素特征高度相关)。通常对响应图下采样(如每隔8×8像素取一个点,或用局部平均池化),将编码长度压缩到2048位(256字节)。Daugman原始方法在每个滤波器的响应图上取约64个采样点(分布在归一化图的不同位置),16个滤波器×64点×2位=2048位。⑤掩码生成——与编码同时生成一个等长的掩码(mask),标记每个编码位是否有效:如果该编码位对应的图像区域被遮挡(眼睑/睫毛/反光),或Gabor响应幅度太低(纹理弱,相位不可靠),则掩码位标记为0(无效),否则标记为1(有效)。掩码在匹配时用于排除无效位,只比较两个编码都有效的位。
Gabor相位编码的关键特性:①光照不变性——只编码相位(纹理结构),不编码幅度(绝对灰度),光照变化主要改变幅度而相位相对稳定,因此虹膜编码对光照和对比度变化鲁棒。这是虹膜识别能够在不同光照下稳定识别的核心原因之一。②多尺度多方向——Gabor滤波器组模拟人类视觉皮层的简单细胞响应,能捕捉不同频率(粗/细纹理)和不同方向(横/竖/斜纹理)的特征,全面表征虹膜纹理。③相位的区分性——研究表明,虹膜纹理的Gabor相位在不同人之间近似随机独立(汉明距离分布均值0.5,标准差约0.007,服从二项分布),因此2048位编码的区分度极高——理论上可以区分2^2048个个体,远超过全球人口,实际误识率(FAR)可达10^-6到10^-12。④稳定性——同一个人的虹膜在不同采集条件下,Gabor相位的稳定性高(有效位的汉明距离通常小于0.1-0.2),因为虹膜纹理终身稳定且相位对几何变化(经归一化后)和光照变化鲁棒。⑤计算效率——Gabor卷积可以用FFT加速或预计算滤波器组,相位量化只是简单的象限判断,编码生成速度快(毫秒级),适合实时系统。Gabor相位编码是虹膜识别的标志性技术,其设计思想(相位编码、多尺度、掩码、汉明距离匹配)深刻影响了整个生物识别领域,OSIRIS、MIRLIN等开源实现和绝大多数商用系统都采用此方法。
7.2 IrisCode虹膜编码
IrisCode(虹膜编码)是Gabor相位编码的产物,是虹膜识别系统中存储和比对的标准模板格式:①编码结构——一个完整的虹膜模板通常包含:·IrisCode(虹膜编码):二进制位串,长度通常2048位(256字节),也可以是4096位(512字节)或更长(更精细的特征,区分度更高但存储和匹配成本增加);·Mask(掩码):与IrisCode等长的二进制位串,标记每位是否有效(1=有效,0=遮挡/低质量);·元数据:采集设备型号、采集时间、图像质量分数、瞳孔直径比、左右眼标识、模板版本号、加密签名等。一个完整模板通常512字节-2KB(编码+掩码+元数据),非常紧凑,百万级模板库只需要几GB存储空间。②编码生成示例——以64×512归一化图、16个Gabor滤波器(4尺度×4方向)、每个滤波器64个采样点为例:每个采样点的Gabor复响应量化为2位,16滤波器×64点×2位=2048位IrisCode;同时生成2048位掩码,遮挡区域和低响应区域对应位为0。采样点的位置通常均匀分布在归一化图上(如8×8网格,但避开边缘和常被遮挡的上下区域),或根据纹理丰富度自适应选择(纹理丰富的区域采样更密)。③编码的统计特性——Daugman的大量实验表明:·同一个人(genuine)的两次采集,IrisCode有效位的汉明距离均值约0.05-0.15(即5-15%的位不同,主要由噪声、遮挡、轻微定位误差、瞳孔变化引起);·不同人(impostor)的两次采集,汉明距离均值约0.45-0.5(接近0.5,即近似随机独立,因为不同人的虹膜纹理无关),标准差约0.007(2048位时),服从二项分布B(n=2048, p=0.5);·两个分布(genuine和impostor)几乎完全分离——genuine最大约0.25,impostor最小约0.35,中间有清晰的间隔(0.25-0.35),因此阈值设为0.30-0.35时,FAR和FRR都极低。这是虹膜识别高精度的统计基础。④模板保护——虹膜模板是敏感生物特征信息(虹膜不可更改,一旦泄露无法像密码一样更换),存储和传输时需要加密保护:·加密存储——模板用AES等对称加密存储在数据库中,密钥由安全模块(HSM/TEE)管理;·不可逆变换(Cancellable Biometrics)——用用户特定的密钥/盐值对IrisCode进行不可逆变换(如随机投影、置换、加盐哈希),存储变换后的模板,即使数据库泄露也无法恢复原始虹膜特征,且用户可以更换密钥重新生成模板("可撤销生物特征");·同态加密(FHE)——在加密域直接计算汉明距离,不需要解密模板,最新研究(如2026年arXiv论文)用高性能FHE实现毫秒级加密虹膜匹配,适合云端隐私保护场景;·联邦学习/安全多方计算——模板不离开本地设备,在加密域完成匹配。生产系统通常至少采用加密存储和传输,高安全场景(金融、政务)采用不可逆变换和硬件安全模块。
7.3 其他特征提取方法
除了Daugman Gabor相位编码,还有多种特征提取方法,各有优势和适用场景:①Log-Gabor滤波器——对数Gabor滤波器,在频域用对数坐标设计高斯包络,与传统Gabor相比,在高频区域有更平坦的响应(传统Gabor的高频响应受高斯包络限制而衰减),能提取更丰富的高频纹理细节(细微隐窝和褶皱)。Log-Gabor在虹膜识别中被证明比传统Gabor有略高的区分度(EER降低10-20%),OSIRIS开源实现默认使用Log-Gabor滤波器。Log-Gabor的缺点是没有解析的空域表达式(需要在频域设计再逆FFT到时域),实现稍复杂。②小波包变换(Wavelet Packet Transform)——用多分辨率小波包分解将归一化虹膜图分解为不同频带的子带,选择具有区分性的子带系数作为特征,或系数量化为二进制编码。小波包比Gabor更灵活(可以自适应选择最佳基),但特征选择和量化需要调优,区分度通常略低于Gabor相位编码。③LBP(局部二值模式)——对归一化图的每个像素,比较其与邻域像素的灰度大小,生成二进制LBP码,统计LBP直方图作为特征。LBP计算极快(只需像素比较和直方图统计),对单调光照变化鲁棒,但区分度低于Gabor(LBP捕捉局部纹理模式,但没有多尺度多方向的全局结构信息),适合对速度要求极高的嵌入式场景,或作为Gabor特征的补充。④SIFT/SURF特征点——检测虹膜中的尺度不变特征点(SIFT)或快速鲁棒特征点(SURF),用特征点描述子作为特征。SIFT/SURF对旋转、缩放、光照变化鲁棒,但虹膜中稳定的特征点数量有限(隐窝和色素斑可以作为特征点,但褶皱和放射纹不是稳定的角点),且特征点匹配的计算量较大,在虹膜识别中不是主流方法,适合与Gabor特征融合提升鲁棒性。⑤Ordinal Measures(有序测度)——比较虹膜图像中不同区域的灰度大小关系(如区域A比区域B亮编码为1,否则0),生成二进制编码。有序测度对单调光照变化完全鲁棒(只比较相对大小),计算简单,但区分度低于Gabor相位编码,适合资源极度受限的场景。⑥深度学习特征——用CNN/ViT网络从归一化虹膜图(或原始ROI图)中提取深度特征,生成固定长度的特征向量(如128维/512维浮点向量,或二值化的深度哈希编码)。训练方法:·度量学习——用孪生网络(Siamese Network)、三元组损失(Triplet Loss)、ArcFace/CosFace等判别性损失,让网络学习到"同一个人特征近、不同人特征远"的度量空间;·自监督预训练——在大规模无标注虹膜图像上用对比学习(SimCLR/MoCo)预训练特征提取器,再在小规模标注数据上微调,解决虹膜标注数据不足的问题;·端到端——网络同时完成分割、归一化(用空间变换网络STN)、特征提取,输入原始图像输出特征向量,减少人工预处理步骤。深度学习特征在遮挡、低质量、可见光、跨设备等复杂场景下鲁棒性显著优于Gabor(EER可降低30-50%),是当前研究热点;但深度学习特征是浮点向量(不是二进制编码),匹配时用余弦相似度/欧氏距离(不是汉明距离),匹配速度稍慢,且模型较大需要轻量化,可解释性弱。生产系统的趋势是"Gabor编码为主+深度学习特征为辅"的混合架构:Gabor编码用于快速初筛(汉明距离匹配快,百万级库毫秒级),深度学习特征用于复杂场景的精排和Gabor失败时的兜底,两者融合提升整体精度和鲁棒性。
7.4 模板标准化与互操作性
虹膜模板的标准化是不同厂商设备互操作的关键:①ISO/IEC 19794-6标准——国际标准化组织制定的生物特征数据交换格式第6部分:虹膜图像数据,定义了虹膜模板的标准化格式,包括:·图像数据格式(原始虹膜图像或归一化图像的存储格式、分辨率、色彩空间);·特征数据格式(IrisCode的编码方式、长度、掩码格式、元数据字段);·质量指标(质量分数的定义和范围);·设备信息(采集设备的型号、光源波长、光学参数)。遵循ISO/IEC 19794-6的模板可以在不同厂商的系统间交换和比对,是国家身份系统(如印度Aadhaar、世界银行ID4D)和跨境通关(如国际民航组织ICAO生物特征旅行证件)的基础要求。②ANSI/INCITS 379标准——美国国家标准学会制定的虹膜数据交换格式,与ISO/IEC 19794-6类似但细节有差异,北美地区常用。③模板互操作的挑战——即使遵循标准,不同厂商的Gabor滤波器参数(尺度/方向/采样点位置)、归一化尺寸、增强算法、掩码生成逻辑可能不同,导致同一虹膜在不同厂商设备上生成的模板无法直接比对(汉明距离偏高)。解决方法:·严格遵循标准的最小互操作子集(定义统一的滤波器参数和编码流程);·用原始图像交换(不交换特征模板,交换原始虹膜图像,在接收端用统一算法生成模板),但原始图像数据量大且隐私敏感;·用深度学习通用特征(训练一个跨设备的通用特征提取器,不同设备的图像都映射到同一特征空间),是未来互操作的方向。④模板更新——虹膜纹理理论上终身不变,但随年龄增长可能有轻微变化(如老年人虹膜萎缩、瞳孔括约肌功能下降导致瞳孔变化),疾病和手术(白内障手术、虹膜修复、激光手术)可能改变虹膜。系统应支持模板更新——识别时如果匹配分数在阈值附近但质量高,可以用新采集的图像更新模板(模板融合,将多次采集的编码取多数/平均,提升模板质量和覆盖度),保持模板的长期有效性。⑤左右眼——同一个人的左右眼虹膜完全不同(是两个独立的生物标识符),模板中必须标注左右眼,匹配时只比较同一只眼的模板。双目采集(同时采集左右眼)可以提升便利性(用户不需要指定哪只眼)和安全性(双眼同时匹配,FAR更低),也可以用于活体检测(左右眼的瞳孔对光反射同步性)。
八、匹配与识别
匹配与识别是虹膜识别系统的最后一环,其任务是计算待识别虹膜编码与库中模板的相似度,与阈值比较判断是否为同一人。匹配分为两种模式:①1:1验证(Verification)——用户声明身份(如输入账号/身份证号),系统将采集到的虹膜编码与该身份对应的模板比较,判断是否匹配,用于登录、支付、门禁等场景;②1:N识别(Identification)——用户不声明身份,系统将采集到的虹膜编码与库中所有模板逐一比较,找到最匹配的模板(或判定库中无此人),用于刑侦排查、失踪人口、大规模身份查重、边境通关黑名单等场景。1:1验证只需要一次比较,速度快;1:N识别需要与库中所有模板比较,库越大越慢,需要索引加速。最经典的匹配方法是汉明距离(Hamming Distance),配合循环移位补偿旋转和掩码排除遮挡区域。
8.1 汉明距离匹配
汉明距离(Hamming Distance)是两个等长二进制串中对应位不同的位数占比,是虹膜识别中最常用的匹配方法,由Daugman于1993年提出并沿用至今。对于两个虹膜编码A和B(长度均为N位,如2048位),以及对应的掩码M_A和M_B(标记每位是否有效),汉明距离的计算公式为:HD = (Σ_{i=1}^{N} (A_i XOR B_i) AND M_A_i AND M_B_i) / (Σ_{i=1}^{N} M_A_i AND M_B_i),其中XOR是异或运算(两位不同时为1,相同时为0),AND是与运算,分子是两个编码都有效且位值不同的位数,分母是两个编码都有效的位数。换句话说,只比较两个模板都标记为有效的位,计算这些位中不同位的比例。汉明距离的取值范围是0到1:HD=0表示两个编码完全相同(同一个人的完美采集),HD=0.5表示两个编码完全随机独立(不同人,因为二进制位随机独立时不同位的期望比例是0.5),HD接近1表示两个编码几乎完全相反(罕见,通常意味着一个编码被反转或有系统性错误)。
汉明距离的统计特性是虹膜识别高精度的基础:①同一个人(genuine)的两次采集——由于虹膜纹理终身稳定,且相位编码对光照、对比度、轻微定位误差鲁棒,同一个人两次采集的有效位汉明距离通常在0.05到0.2之间(均值约0.1),即5-20%的位不同,主要由噪声、遮挡、轻微定位偏差、瞳孔大小变化、头部旋转引起;②不同人(impostor)的两次采集——不同人的虹膜纹理在胚胎发育中随机形成,彼此无关,因此Gabor相位编码近似随机独立,汉明距离的均值约0.5(标准差约0.007,当N=2048时,二项分布B(2048, 0.5)的标准差为sqrt(0.5×0.5/2048)≈0.011,考虑掩码后有效位减少,标准差约0.007-0.015),即45-55%的位不同,服从以0.5为中心的二项分布;③两个分布几乎完全分离——genuine分布的上限约0.25(极少数质量差的采集),impostor分布的下限约0.35(极少数巧合),中间有0.25到0.35的清晰间隔(decision gap),因此将阈值设为0.30到0.35之间时,错误接受率(FAR)和错误拒绝率(FRR)都极低。Daugman的经典阈值是0.32(即HD小于0.32判为同一人,大于0.32判为不同人),在2048位编码下,FAR可达10^-6到10^-12(取决于阈值和有效位数量),远高于人脸识别(FAR约10^-3到10^-4)和指纹识别(FAR约10^-5到10^-6)。
阈值选择是匹配的关键参数,需要根据应用场景的安全要求在FAR和FRR之间权衡:①高安全场景(金融大额交易、边境通关、监狱门禁)——优先降低FAR(防止冒名顶替),阈值设低一些(如0.25-0.30),FAR极低但FRR稍高(合法用户可能被拒绝,需要重新采集或人工复核);②便利场景(手机解锁、办公门禁、会员识别)——优先降低FRR(提升用户体验),阈值设高一些(如0.35-0.40),FRR低但FAR稍高;③等错误率(EER)——FAR等于FRR时的阈值,是算法本身性能的参考指标,不直接用于生产(生产通常偏向低FAR或低FRR)。阈值还需要根据有效位数量调整——如果遮挡严重、有效位少(如只有500位有效),汉明距离的方差增大(二项分布标准差与1/sqrt(N)成正比),分布重叠增加,需要适当降低阈值并要求最小有效位数量(如有效位大于500才接受匹配,否则拒绝并提示重新采集)。
8.2 旋转补偿(循环移位)
头部旋转和眼球转动会导致虹膜在图像中旋转,归一化后表现为矩形图的水平位移(角度θ偏移),如果不补偿,同一个人的两次采集因旋转角度不同,归一化后纹理位置错位,汉明距离会显著上升。Daugman提出用循环移位(Circular Shift)补偿旋转——在匹配时,将一个虹膜编码在水平方向循环移位多个位置,计算所有移位下的汉明距离,取最小值作为最终匹配分数。循环移位的原理是:虹膜是环形的,角度θ是周期性的(0度和360度相同),归一化后矩形图的左边界(θ=0)和右边界(θ=2π)在物理上是相邻的,因此水平循环移位对应物理上的旋转,移位后纹理重新对齐。
循环移位的具体实现:①移位范围——通常±15度到±30度,覆盖正常头部旋转和眼球转动范围。对于512列的归一化图,360度对应512列,因此1度对应512/360≈1.42列,±15度对应±21列,±30度对应±43列。移位范围越大,能补偿的旋转越大,但计算量越大(需要计算更多移位位置的汉明距离),且增大FAR(移位越多,偶然匹配的概率越大,需要适当降低阈值补偿)。②移位步长——通常1列(约0.7度),精度足够;也可以用粗精两级(先步长4列粗搜找到最佳移位范围,再步长1列精搜),减少计算量。③计算方法——对于每个移位s(从-21到+21),将编码B循环移位s位(B'_i = B_{(i+s) mod N}),计算A与B'的汉明距离(带掩码),取所有移位中的最小值:HD_min = min_{s=-S}^{S} HD(A, shift(B, s))。用位运算(XOR、AND、popcount计数)可以高效计算,2048位编码的43次移位匹配在现代CPU上只需几微秒。④掩码同步移位——移位时掩码也要同步循环移位,因为遮挡区域(如上部眼睑)随旋转一起移动,移位后掩码位置也要对应移动,确保只比较有效位。⑤大角度旋转——如果旋转超过±30度(如严重侧头),虹膜会被眼睑严重遮挡(外侧虹膜被眼睑覆盖),且透视变形大,此时应拒绝识别并提示用户正视摄像头,而不是用更大的移位范围尝试匹配(大移位会显著增大FAR且遮挡严重导致有效位不足)。
循环移位是虹膜识别中简单而高效的旋转不变性设计,不需要精确估计旋转角度(估计角度本身可能有误差),直接在匹配时穷举所有可能的移位取最小值,鲁棒性强。除了循环移位,还有其他旋转处理方法:①归一化阶段旋转校正——在归一化前先估计旋转角度(如用眼睑倾斜角、虹膜特征点匹配),将图像旋转校正后再归一化,这样匹配时只需要小范围移位(±5度),但旋转角度估计误差可能引入额外错位;②特征点对齐——用SIFT/SURF等特征点匹配注册和识别图像,估计仿射变换(旋转+缩放+平移),将识别图像对齐到注册图像后再匹配,精度高但计算量大,适合非理想图像。生产系统通常以循环移位为主(简单可靠),在质量评估中检测大角度旋转并拒绝,确保移位范围在±15到±30度内。
8.3 掩码处理与分数归一化
掩码(Mask)是虹膜编码的重要组成部分,标记每个编码位是否有效(1=有效,0=遮挡/低质量)。掩码在匹配中的作用是排除遮挡区域的干扰——如果一个编码位对应的图像区域被眼睑、睫毛、反光遮挡,该位的编码值不可靠(可能是噪声而不是真实纹理),参与匹配会导致汉明距离偏高(同一个人也可能因遮挡区域的随机噪声而位不同)。因此,汉明距离计算时只比较两个编码都有效的位(M_A AND M_B),遮挡区域不参与匹配。掩码处理的几个要点:①掩码生成——在特征编码阶段同时生成掩码,遮挡区域(根据分割掩码和眼睑/睫毛/反光检测结果)对应位标记为0,Gabor响应幅度太低(纹理弱,相位不可靠)的位也标记为0;②最小有效位要求——匹配时要求两个编码的共同有效位数量(Σ M_A AND M_B)大于阈值(如500位),如果有效位太少(如小于300位),汉明距离的统计可靠性差(方差大),拒绝匹配并提示重新采集;③掩码与移位——循环移位时掩码同步移位,确保遮挡区域随旋转一起移动;④掩码的安全性——掩码本身不包含身份信息(只标记哪些位有效),可以与编码一起存储和传输,不增加隐私风险。
分数归一化将汉明距离转换为更直观的相似度分数或置信度,便于系统决策和用户展示:①相似度分数——Sim = 1 – HD(汉明距离越小,相似度越高,Sim=1表示完全相同,Sim=0.5表示随机),阈值对应Sim大于0.68(1-0.32)判为匹配;②置信度——根据汉明距离与阈值的差距、有效位数量、图像质量分数综合计算置信度(0-100%),如HD远小于阈值且有效位多、质量高,置信度高(99%);HD接近阈值或有效位少,置信度低(60-70%),需要人工复核或重新采集;③多帧融合——如果连续采集多帧,将多帧的匹配分数融合(取最小HD、或加权平均、或多数投票),提升鲁棒性——单帧可能因偶然质量差导致FRR,多帧融合可以显著降低FRR;④1:N识别的候选排序——1:N识别时,计算待识别编码与库中所有模板的汉明距离,按HD从小到大排序,取Top-K候选(如Top-1/Top-5),如果Top-1的HD小于阈值且与Top-2的差距足够大(margin,如HD_top2 – HD_top1 > 0.05),判定为Top-1对应的身份;如果Top-1的HD大于阈值,判定库中无此人;如果Top-1和Top-2接近(margin小),判定为不确定,需要人工复核或采集更多信息。margin判断可以降低1:N识别的FAR(避免在相似模板间选错)。
8.4 其他匹配方法与深度学习度量学习
除了汉明距离,还有几种匹配方法适用于不同特征类型:①加权欧氏距离(Weighted Euclidean Distance)——对于实值特征向量(如小波包系数、深度学习特征),计算加权欧氏距离:d = sqrt(Σ w_i (x_i – y_i)^2),权重w_i根据特征的区分度分配(区分度高的特征权重高),适用于非二进制特征;②归一化互相关(Normalized Correlation, NC)——计算两个特征向量的归一化互相关:NC = (Σ(x_i – x̄)(y_i – ȳ)) / (sqrt(Σ(x_i-x̄)^2) sqrt(Σ(y_i-ȳ)^2)),取值-1到1,NC接近1表示高度相似,对光照和对比度变化鲁棒(归一化消除了均值和方差差异),适用于实值特征;③马氏距离(Mahalanobis Distance)——考虑特征维度间的相关性,用协方差矩阵归一化:d = sqrt((x-y)^T Σ^{-1} (x-y)),对特征分布建模,区分度高但需要估计协方差矩阵(样本量要求大);④余弦相似度(Cosine Similarity)——计算两个特征向量的夹角余弦:cosθ = (x·y)/(||x|| ||y||),对向量长度不敏感,是深度学习特征最常用的相似度度量。
深度学习度量学习(Deep Metric Learning)是当前虹膜识别匹配的研究热点,用神经网络直接学习判别性的特征空间和相似度度量:①孪生网络(Siamese Network)——两个共享权重的子网络分别提取两个虹膜图像的特征向量,用对比损失(Contrastive Loss)训练:同一个人的特征距离小,不同人的特征距离大(大于margin),推理时计算特征距离与阈值比较;②三元组损失(Triplet Loss)——每个训练样本包含锚点(Anchor)、正样本(同一个人)、负样本(不同人),损失函数让锚点与正样本的距离小于锚点与负样本的距离(减去margin),三元组损失比对比损失更有效地利用样本间关系,是人脸识别和虹膜识别的主流训练方法;③ArcFace/CosFace——在分类损失中加入角度间隔(angular margin),让不同类别的特征在角度空间上有更大间隔,提升特征的判别性和泛化能力,在人脸识别中取得SOTA,迁移到虹膜识别效果好;④深度哈希(Deep Hashing)——用神经网络学习从虹膜图像到二进制哈希编码的映射,训练时让同一个人的哈希编码汉明距离小、不同人的大,推理时用汉明距离快速匹配(与传统Gabor编码的匹配方式相同,但特征是数据驱动学习的),深度哈希结合了深度学习特征的判别性和汉明距离的快速匹配,适合大规模1:N检索;⑤端到端匹配——网络直接输入两个虹膜图像,输出匹配分数(0到1的相似度),不需要手动设计特征和距离度量,端到端优化匹配性能,但推理时需要成对输入(1:N识别时需要与每个模板配对计算,速度慢),适合1:1验证场景。深度学习匹配方法在遮挡、低质量、可见光、跨设备等复杂场景下EER可比传统Gabor+汉明距离降低30-50%,是当前算法升级的重要方向;但深度学习特征是浮点向量(512维-2048维),存储和匹配成本高于2048位二进制编码,1:N大规模检索需要用向量索引(如FAISS、HNSW)加速,且模型可解释性弱。生产系统的趋势是"传统Gabor+汉明距离为主(快速初筛)+深度学习特征为辅(复杂场景精排和兜底)"的混合架构。
8.5 1:N大规模检索与性能指标
1:N识别(Identification)需要将待识别编码与库中所有模板逐一比较,库越大越慢。当库规模达到百万级(如国家身份系统、刑侦数据库)时,暴力匹配(逐一比较)的延迟不可接受(百万次匹配即使每次1微秒也需要1秒),需要索引加速:①海明空间索引——汉明距离是二进制空间中的L1距离,可以用专门的索引结构加速:·BK-tree(Burkhard-Keller Tree)——基于距离的树结构,利用汉明距离的三角不等式剪枝,适合小规模库(万级);·多探针局部敏感哈希(Multi-probe LSH)——将汉明距离相近的编码哈希到相近桶,查询时探查多个桶召回候选,适合百万级库,召回率和速度可调;·倒排索引(Inverted Index)——将编码按位分片,每片建倒排表,查询时合并候选,适合超大规模库;·海明空间排序——按编码的整数值排序,用二分查找和范围查询缩小候选范围。②GPU并行加速——将库中模板加载到GPU显存,用CUDA核函数并行计算待识别编码与所有模板的汉明距离(位运算+popcount),现代GPU(如A100)可以在几毫秒内完成百万级匹配,是最直接的加速方法,适合有GPU的服务器场景;③分库分表——按人群属性(地域、年龄、性别)或编码前缀将库分为多个子库,查询时只在相关子库中搜索(如根据用户的地理位置信息只在该地区子库中匹配),减少搜索范围;④级联匹配——先用快速但精度稍低的方法(如短编码、LSH粗筛)从百万库中召回Top-K候选(如Top-1000),再用精确方法(完整Gabor编码+深度学习特征)在候选中精排,兼顾速度和精度;⑤模板压缩——将多个模板融合为一个高质量模板(同一个人的多次采集取多数/平均),减少库中模板数量,同时提升模板质量。
虹膜识别系统的性能指标:①错误接受率(False Acceptance Rate, FAR)——不同人被误判为同一人的比例,FAR越低越安全,金融级要求FAR小于10^-6甚至10^-9,虹膜识别在2048位编码+阈值0.32时FAR可达10^-6到10^-12;②错误拒绝率(False Rejection Rate, FRR)——同一个人被误判为不同人的比例,FRR越低用户体验越好,便利场景要求FRR小于1%,高安全场景可接受FRR 3-5%(被拒用户可重新采集);③等错误率(Equal Error Rate, EER)——FAR等于FRR时的错误率,是算法本身性能的参考指标(不直接用于生产),EER越低算法越好,高质量近红外图像上EER可小于0.1%;④ROC曲线(Receiver Operating Characteristic)——以FPR(=FAR)为横轴、TPR(=1-FRR)为纵轴的曲线,曲线越靠近左上角性能越好,AUC(曲线下面积)接近1为优秀;⑤DET曲线(Detection Error Tradeoff)——以FAR为横轴、FRR为纵轴的对数坐标曲线,直观展示FAR和FRR的权衡关系,曲线越靠近左下角性能越好;⑥识别速度——1:1验证的单次匹配时间(微秒级)、1:N识别的库检索时间(百万级库毫秒级)、端到端延迟(从采集到出结果,通常小于1秒);⑦模板大小——单个模板的存储大小(编码+掩码+元数据,通常512字节-2KB),百万级模板库存储需求(几GB到几十GB);⑧注册成功率——用户首次注册时成功生成高质量模板的比例,受采集质量和用户配合度影响,高质量设备上注册成功率大于95%。
8.6 完整Python代码实现
以下是一个虹膜识别核心算法的教学示例Python代码,涵盖从图像输入到匹配输出的完整流程,包括瞳孔/虹膜定位(简化版Daugman算子)、归一化(橡胶片模型)、Gabor特征编码、汉明距离匹配(带循环移位和掩码)。代码为教学演示,实际生产系统需要更鲁棒的定位、分割和优化实现。
import numpy as np
import cv2
from scipy import ndimage
from scipy.signal import convolve2d
class IrisRecognizer:
def __init__(self, norm_height=64, norm_width=512, code_bits=2048):
self.norm_height = norm_height # 归一化图高度(径向)
self.norm_width = norm_width # 归一化图宽度(角度)
self.code_bits = code_bits # 虹膜编码位数
self.gabor_filters = self._build_gabor_filters()
def _build_gabor_filters(self):
"""构建多尺度多方向2D Gabor滤波器组"""
filters = []
for wavelength in [8, 16, 32]: # 3个尺度(波长)
for theta in [0, np.pi/4, np.pi/2, 3*np.pi/4]: # 4个方向
sigma = wavelength * 0.5
kernel_size = int(sigma * 4) | 1
kernel = cv2.getGaborKernel((kernel_size, kernel_size),
sigma, theta, wavelength, 0.5, 0)
filters.append(kernel)
return filters
def detect_pupil(self, gray_img):
"""简化版瞳孔检测:阈值分割+形态学+最大连通域"""
_, binary = cv2.threshold(gray_img, 40, 255, cv2.THRESH_BINARY_INV)
kernel = np.ones((5,5), np.uint8)
binary = cv2.morphologyEx(binary, cv2.MORPH_OPEN, kernel)
contours, _ = cv2.findContours(binary, cv2.RETR_EXTERNAL,
cv2.CHAIN_APPROX_SIMPLE)
if not contours:
return None
largest = max(contours, key=cv2.contourArea)
(x, y), radius = cv2.minEnclosingCircle(largest)
return int(x), int(y), int(radius)
def detect_iris_boundary(self, gray_img, pupil_cx, pupil_cy, pupil_r):
"""简化版虹膜外边界检测:在瞳孔外搜索灰度梯度最大的圆"""
best_r, best_score = pupil_r * 3, 0
for r in range(int(pupil_r*2), int(pupil_r*4)):
circumference = 2 * np.pi * r
points = [(int(pupil_cx + r*np.cos(t)),
int(pupil_cy + r*np.sin(t)))
for t in np.linspace(0, 2*np.pi, int(circumference))]
grad_sum = 0
for (px, py) in points:
if 0 < px < gray_img.shape[1]-1 and 0 < py < gray_img.shape[0]-1:
grad_sum += abs(int(gray_img[py, px+1]) – int(gray_img[py, px-1]))
score = grad_sum / len(points)
if score > best_score:
best_score, best_r = score, r
return pupil_cx, pupil_cy, best_r
def normalize(self, gray_img, pupil_cx, pupil_cy, pupil_r, iris_r):
"""Daugman橡胶片模型:环形虹膜→固定大小矩形"""
norm_img = np.zeros((self.norm_height, self.norm_width), dtype=np.uint8)
mask = np.ones((self.norm_height, self.norm_width), dtype=np.uint8)
for y in range(self.norm_height):
r_ratio = y / self.norm_height # 径向比例 0→1
for x in range(self.norm_width):
theta = 2 * np.pi * x / self.norm_width # 角度
# 瞳孔边界点到虹膜外边界点的线性插值
px = pupil_cx + (pupil_r + r_ratio * (iris_r – pupil_r)) * np.cos(theta)
py = pupil_cy + (pupil_r + r_ratio * (iris_r – pupil_r)) * np.sin(theta)
px_int, py_int = int(px), int(py)
if 0 <= px_int < gray_img.shape[1] and 0 <= py_int < gray_img.shape[0]:
norm_img[y, x] = gray_img[py_int, px_int]
else:
mask[y, x] = 0 # 越界标记为无效
return norm_img, mask
def encode(self, norm_img, mask):
"""2D Gabor小波相位编码→二进制IrisCode+掩码"""
code = []
code_mask = []
step_y = norm_img.shape[0] // 8 #采样步长
step_x = norm_img.shape[1] // 8
for gabor in self.gabor_filters:
response = convolve2d(norm_img.astype(float), gabor, mode='same')
for y in range(0, norm_img.shape[0], step_y):
for x in range(0, norm_img.shape[1], step_x):
if len(code) >= self.code_bits:
break
real_val = np.real(response[y, x])
imag_val = np.imag(response[y, x])
# 相位量化为2位(四个象限)
bit1 = 1 if real_val >= 0 else 0
bit2 = 1 if imag_val >= 0 else 0
code.extend([bit1, bit2])
# 掩码:响应幅度低或图像区域遮挡则标记无效
magnitude = np.sqrt(real_val**2 + imag_val**2)
valid = 1 if (magnitude > 10 and mask[y, x] == 1) else 0
code_mask.extend([valid, valid])
return np.array(code[:self.code_bits]), np.array(code_mask[:self.code_bits])
def hamming_distance(self, code1, mask1, code2, mask2, max_shift=21):
"""汉明距离匹配,带循环移位补偿旋转和掩码处理"""
common_valid = mask1 & mask2
if np.sum(common_valid) < 500: # 有效位不足,拒绝
return 1.0, 0
min_hd = 1.0
best_shift = 0
for shift in range(-max_shift, max_shift + 1):
shifted_code2 = np.roll(code2, shift)
shifted_mask2 = np.roll(mask2, shift)
valid = mask1 & shifted_mask2
if np.sum(valid) < 500:
continue
diff = np.logical_xor(code1, shifted_code2) & valid
hd = np.sum(diff) / np.sum(valid)
if hd < min_hd:
min_hd = hd
best_shift = shift
return min_hd, best_shift
def verify(self, img1, img2, threshold=0.32):
"""1:1验证:判断两幅虹膜图像是否为同一人"""
code1, mask1 = self.extract_template(img1)
code2, mask2 = self.extract_template(img2)
hd, shift = self.hamming_distance(code1, mask1, code2, mask2)
return {'match': hd < threshold, 'hamming_distance': hd,
'best_shift': shift, 'threshold': threshold}
def extract_template(self, gray_img):
"""从图像提取虹膜模板(定位→归一化→编码)"""
pupil = self.detect_pupil(gray_img)
if pupil is None:
raise ValueError("未检测到瞳孔")
cx, cy, pr = pupil
_, _, ir = self.detect_iris_boundary(gray_img, cx, cy, pr)
norm_img, norm_mask = self.normalize(gray_img, cx, cy, pr, ir)
code, code_mask = self.encode(norm_img, norm_mask)
return code, code_mask
# 使用示例
if __name__ == "__main__":
recognizer = IrisRecognizer()
# 加载两幅近红外虹膜灰度图像
img1 = cv2.imread("iris_sample1.jpg", cv2.IMREAD_GRAYSCALE)
img2 = cv2.imread("iris_sample2.jpg", cv2.IMREAD_GRAYSCALE)
result = recognizer.verify(img1, img2, threshold=0.32)
print(f"匹配结果: {'同一人' if result['match'] else '不同人'}")
print(f"汉明距离: {result['hamming_distance']:.4f}")
print(f"最佳移位: {result['best_shift']}")
代码说明:①detect_pupil用阈值分割+形态学操作快速定位瞳孔(教学简化版,实际系统用Daugman积分微分算子或Hough变换);②detect_iris_boundary在瞳孔外搜索灰度梯度最大的圆作为虹膜外边界(简化版,实际用Daugman算子);③normalize实现Daugman橡胶片模型,将环形虹膜映射为64×512矩形;④encode用12个Gabor滤波器(3尺度×4方向)提取相位,量化为2位编码,生成2048位IrisCode和掩码;⑤hamming_distance实现带循环移位(±21列对应±15度)和掩码处理的汉明距离匹配,有效位不足500时拒绝;⑥verify封装1:1验证流程。实际生产系统需要更鲁棒的定位(Daugman算子/Hough/深度学习)、像素级分割(U-Net)、眼睑/睫毛/反光检测、图像增强(CLAHE)、多帧融合、模板加密存储、1:N索引加速等。
九、活体检测与安全防护
虹膜识别虽然精度极高,但也面临伪造攻击的风险——攻击者可能用打印虹膜照片、数字视频回放、人工假眼、彩色隐形眼镜(美瞳)、AI生成虹膜图像等方式欺骗系统。活体检测(Liveness Detection / Presentation Attack Detection, PAD)的任务是判断采集到的虹膜图像来自真实活体人眼还是伪造攻击,是虹膜识别系统安全防护的核心环节。没有活体检测的虹膜识别系统可以被高质量虹膜照片轻易欺骗(将虹膜照片放在摄像头前),因此所有商用虹膜识别系统都必须集成活体检测。
9.1 攻击类型
虹膜识别面临的主要攻击类型:①打印照片攻击(Print Attack)——将他人虹膜图像打印在纸张上(或显示在屏幕上),放在摄像头前欺骗系统。这是最简单的攻击,打印照片的纹理与真实虹膜有差异(纸张纹理、墨水点、摩尔纹、缺乏景深),传统纹理分析可以检测;②视频回放攻击(Video Replay)——用屏幕播放他人虹膜的视频(可能是偷录的或从网上获取的),欺骗系统。视频回放有屏幕刷新频率、像素结构、反光等特征,可通过频域分析和时序分析检测;③人工假眼(Artificial Eye / Prosthetic Eye)——用玻璃、塑料、硅胶等材料制作的假眼,表面印有虹膜纹理。假眼没有生理活动(瞳孔不会对光反射、没有微震颤),纹理是印刷的(缺乏真实虹膜的三维结构和细节),可通过生理信号和纹理分析检测;④彩色隐形眼镜(Colored Contact Lens / Cosmetic Lens)——攻击者佩戴印有他人虹膜纹理的彩色隐形眼镜(美瞳),覆盖自己的真实虹膜。这是最难检测的攻击之一——美瞳下的眼睛是活体(有瞳孔反射、微震颤),但表面纹理是印刷的(有隐形眼镜边缘、印刷纹理规律、缺乏三维隐窝结构),需要专门的纹理分析和光学检测;⑤AI生成虹膜(Synthetic Iris / Deepfake)——用生成对抗网络(GAN)或扩散模型(Diffusion Model)生成的高仿真虹膜图像,纹理逼真但可能有生成伪影(缺乏真实虹膜的生理细节、统计分布异常),需要用深度学习反伪造检测器识别;⑥部分遮挡/拼接攻击——将真实虹膜的部分区域与伪造区域拼接,或用半透明材料覆盖部分虹膜,混合真实和伪造纹理,增加检测难度。
9.2 活体检测方法
虹膜活体检测方法分为几大类:①生理信号法——利用活体人眼的生理活动特征:·瞳孔对光反射(Pupillary Light Reflex, PLR)——用不同强度的近红外光照射眼睛,活体瞳孔会随光照强度变化而收缩/放大(强光收缩、弱光放大),假眼和照片的瞳孔大小不变。通过连续采集多帧图像,跟踪瞳孔直径随光照的变化,判断是否有正常的瞳孔对光反射。这是最可靠的活体检测方法之一(假眼完全没有瞳孔反射),但需要额外的可控光照硬件(可调节强度的近红外LED)和多帧采集(增加采集时间到1-2秒);·微震颤(Micro-tremor / Microsaccade)——活体人眼在注视时会有微小的不自主震颤(幅度几个像素,频率几Hz到几十Hz),假眼和照片完全静止。通过高帧率(大于30fps)连续采集,分析虹膜位置的微小振动,判断是否为活体;·心跳/脉搏引起的虹膜微位移——心脏跳动引起眼部微血管充血变化,导致虹膜有微小的周期性位移(幅度亚像素,频率与心率一致约1Hz),可通过高帧率图像的相位相关分析检测(类似rPPG);·左右眼瞳孔反射同步性——活体左右眼的瞳孔对光反射是同步的(神经系统控制),假眼或单眼伪造的同步性异常。生理信号法的优点是可靠性高(假眼完全无法伪造生理活动),缺点是需要多帧采集和特殊硬件,采集时间稍长。
②纹理/图像质量分析法——利用真实虹膜与伪造物的纹理差异:·真实虹膜的三维结构——真实虹膜有隐窝(凹陷)、褶皱(隆起)、色素斑等三维结构,在近红外光下有明暗变化和阴影;打印照片和屏幕显示是二维平面,没有三维结构和景深,纹理平坦;·印刷伪影——打印照片有半色调网点(ink dots)、纸张纹理,屏幕显示有像素结构(RGB子像素)、刷新摩尔纹,这些在频域(FFT)中表现为周期性峰值,可通过频域分析检测;·清晰度和锐度差异——真实虹膜的纹理边缘自然,打印照片的边缘可能模糊或有墨水扩散,屏幕显示可能有过锐化或像素化;·深度学习分类器——用CNN(ResNet/MobileNet/EfficientNet)对虹膜图像进行二分类(活体/伪造),训练数据包含各种攻击类型(打印/屏幕/假眼/美瞳/AI生成),深度学习方法能自动学习伪造物的统计特征,在已知攻击类型上准确率高(大于95%),但对未知攻击类型(零样本攻击)泛化能力有限,需要用域适应、异常检测、自监督学习提升泛化。纹理分析法的优点是单帧即可检测(不需要多帧和特殊硬件),速度快,缺点是对高质量伪造(高分辨率打印、OLED屏幕、高精度美瞳)检测难度大。
③光学/硬件辅助法——利用特殊光学硬件检测活体:·多光谱成像——用多个波长的近红外光(如760nm、850nm、940nm)分别成像,真实虹膜在不同波长下的反射率有差异(血红蛋白、黑色素的光谱吸收特性),打印照片和假眼的光谱响应异常(印刷颜料的光谱特性与真实组织不同);·偏振光成像——用偏振光源和偏振镜头,真实虹膜的散射光有特定偏振特性(组织的次表面散射),打印照片和屏幕的反射光偏振特性不同(镜面反射vs漫反射),可通过偏振差分成像分离;·深度/3D成像——用结构光、ToF、双目视觉获取眼睛的三维深度信息,真实虹膜是三维曲面(有隐窝凹陷、角膜弧度),打印照片是平面(深度一致),假眼可能是曲面但缺乏细微三维结构;·角膜反光检测——真实眼睛的角膜有规则的光源反光(specular reflection),且反光位置随眼球运动而变化,打印照片和屏幕的反光位置固定或异常。光学辅助法的优点是可靠性高(硬件层面区分活体和伪造),缺点是需要额外硬件(增加成本和体积),不适合手机等消费级设备。
④时序/行为分析法——利用视频序列中的动态特征:·眨眼检测——活体人眼会自然眨眼(频率约每分钟10-15次),照片和假眼不会眨眼;·眼球运动检测——活体人眼会有不自主的微眼跳和追随运动,照片静止;·瞳孔动态变化——除了对光反射,活体瞳孔还有生理性的微小波动(hippus,瞳孔不自主节律性收缩放大),假眼没有;·表情/头部运动关联——活体的眼球运动与头部运动、表情变化协调一致,伪造物的运动可能不自然。时序分析法通常与生理信号法结合,通过视频序列(3-10秒)综合判断活体。生产系统通常采用多方法融合的活体检测策略:纹理分析(单帧快速初筛)+瞳孔对光反射(可控光照,高可靠)+深度学习反伪造(检测AI生成和高质量伪造)+多帧时序分析,多方法投票或级联决策,确保对各种攻击类型都有高检测率(APCER小于0.1%,BPCER小于2%)。高安全场景(金融、边境)还会要求用户做随机动作(如眨眼、左右看、注视移动的光点),增加攻击难度(动作随机,无法预先录制)。
9.3 模板保护与隐私安全
虹膜是不可撤销的生物特征——一个人的虹膜终身不变,一旦虹膜模板泄露,无法像密码一样更换,因此虹膜模板的隐私保护至关重要。模板保护技术包括:①加密存储与传输——虹膜模板(编码+掩码+元数据)在存储时用AES-256等对称加密,传输时用TLS/SSL加密,密钥由硬件安全模块(HSM)或可信执行环境(TEE)管理,即使数据库泄露,没有密钥也无法解密模板;②不可逆变换(Cancellable Biometrics / 可撤销生物特征)——用用户特定的密钥或盐值对虹膜编码进行不可逆变换(如随机投影、置换、加盐哈希、BioHashing),存储变换后的模板而不是原始编码。变换是单向的(无法从变换后的模板恢复原始虹膜特征),且用户可以更换密钥重新生成模板("可撤销"),即使变换后的模板泄露,攻击者也无法恢复原始虹膜特征,也无法在其他系统中使用(不同系统用不同密钥)。常用方法:·BioHashing——将用户密钥(随机数)与虹膜特征混合,生成伪随机特征,同一用户的不同采集映射到相近的哈希值,不同用户映射到随机值;·随机多空间量化(RMSQ)——用随机投影矩阵将虹膜特征投影到低维空间再量化,投影矩阵是用户特定的;·置换混淆——用用户特定的置换矩阵打乱虹膜编码的位顺序,置换矩阵是密钥。不可逆变换的挑战是变换后匹配精度可能下降(变换引入噪声),需要在安全性和精度间权衡。
③同态加密(Homomorphic Encryption, HE)——在加密域直接计算汉明距离,不需要解密模板。客户端将待识别虹膜编码加密后发送到服务器,服务器在加密域与加密的库模板计算汉明距离,返回加密的匹配结果,客户端解密得到结果。整个过程服务器无法看到任何明文虹膜特征,实现了"数据可用不可见"。最新研究(如2026年arXiv论文"Private Iris Recognition with High-Performance FHE")用高性能全同态加密(FHE)实现了毫秒级加密虹膜匹配,使得云端隐私保护虹膜识别成为可能。同态加密的挑战是计算开销大(比明文匹配慢几个数量级),需要算法优化和硬件加速;④联邦学习与安全多方计算——模板不离开本地设备(如手机、门禁终端),在加密域或联邦学习框架下完成匹配,多方协同计算但不暴露各自数据,适合跨机构、跨系统的虹膜识别场景;⑤差分隐私——在模板或匹配结果中加入可控噪声,使得单个用户的虹膜特征无法被推断,同时保持整体识别精度,适合大规模数据分析场景;⑥合规与监管——虹膜识别属于敏感个人信息,受《个人信息保护法》《数据安全法》《网络安全法》等法律法规约束,需要遵循"知情同意、最小必要、目的限制、安全保障"原则,明确告知用户采集目的、存储期限、使用范围,提供删除和撤回同意的渠道。高安全场景(金融、政务)还需要通过等保三级、密码应用安全性评估(密评)等安全认证。生产系统至少应采用加密存储和传输,高安全场景应采用不可逆变换或同态加密,确保虹膜模板的隐私安全。
十、数据集与开源工具
10.1 主流虹膜数据集
虹膜识别算法的训练和评估需要高质量、多样化的公开数据集。以下是主流虹膜数据集的对比:
|
数据集 |
发布机构 |
规模(人数/图像数) |
采集条件与特点 |
主要用途 |
|
CASIA-IrisV1 |
中科院自动化所(CASIA) |
108人 / 756张 |
近红外(850nm LED环形照明),320×280分辨率,近距离采集,每只眼7张图像(2次采集间隔),是最早公开的虹膜数据集之一 |
算法验证、教学实验、入门研究 |
|
CASIA-IrisV3 / V4 |
中科院自动化所 |
V3: 数百人 / 数千张;V4: 数千人 / 数万张 |
近红外,包含多个子集(Interval/Lamp/Twins/Distance/Syn等),V4-Distance是远距离采集(3米外),V4-Syn是合成虹膜图像,涵盖不同光照、距离、姿态 |
算法研究、跨条件评估、远距离识别 |
|
CASIA-Iris-Thousand (V4 Thousand) |
中科院自动化所 |
1000人 / 20000张 |
近红外,IrisKing IKEMB-100双目相机采集,每只眼10张图像,大规模多样化(不同年龄、性别、种族),是目前最大的公开近红外虹膜数据集之一 |
深度学习训练、大规模评估、1:N检索 |
|
IITD Iris Database V1 |
印度理工学院德里分校(IIT Delhi) |
224人 / 1120张 |
近红外,320×240分辨率,每只眼5张图像,包含不同光照和姿态,印度人群为主,公开免费获取 |
算法研究、跨数据集评估 |
|
UBIRIS.v1 / v2 |
葡萄牙贝拉地区大学(UBI) |
v1: 241人 / 1877张;v2: 167人 / 11258张 |
可见光(不是近红外!),在真实环境中采集(移动中、不同光照、不同距离),v2包含大量噪声、运动模糊、遮挡、反光,是最具挑战性的可见光虹膜数据集之一 |
可见光虹膜识别、鲁棒性研究、噪声处理 |
|
MMU1 / MMU2 |
马来西亚多媒体大学(MMU) |
MMU1: 100人 / 450张;MMU2: 100人 / 995张 |
近红外,320×240分辨率,每只眼5张(MMU1)或10张(MMU2),包含不同光照和睁眼程度,亚洲人群为主 |
算法验证、教学实验 |
|
ND-IRIS-0405 |
美国圣母大学(Notre Dame) |
356人 / 64980张 |
近红外,高分辨率(640×480),多次采集(间隔数周),包含不同表情、眼镜、光照,是时间稳定性评估的重要数据集 |
时间稳定性评估、跨时段识别 |
|
ICE 2005 / 2006 |
美国国家标准与技术研究院(NIST) |
ICE2005: 152人 / 2953张;ICE2006: 数百人 / 数万张 |
近红外,Iris Challenge Evaluation竞赛数据集,高分辨率,包含不同质量和遮挡,用于第三方算法评测,有标准评测协议 |
算法竞赛、第三方评测、标准基准 |
|
MICHE I / II |
意大利多所大学联合 |
MICHE-I: 60人 / 1600张;MICHE-II: 110人 / 数千张 |
可见光,用手机(iPhone/Samsung)和平板电脑的前置摄像头采集,不同光照(室内/室外)、不同距离、不同姿态,模拟真实移动设备虹膜识别场景 |
移动设备虹膜识别、可见光、手机端部署 |
|
BioSec / Warsaw |
波兰华沙工业大学 |
数百人 / 数千张 |
近红外,多次采集(间隔数月),包含不同传感器,用于跨设备和时间稳定性评估 |
跨设备评估、长期稳定性 |
|
CelebA-Spoof / 活体检测数据集 |
多机构联合 |
数千人 / 数十万张 |
包含真实虹膜和多种攻击类型(打印/屏幕/假眼/美瞳/AI生成),用于活体检测(PAD)算法训练和评估 |
活体检测、反伪造、对抗攻击 |
数据集使用注意事项:①近红外vs可见光——绝大多数数据集是近红外的(CASIA/IITD/MMU/ND/ICE),可见光数据集少(UBIRIS/MICHE)且质量差、噪声大,研究可见光虹膜识别需要专门的数据集或域适应;②标注——大多数公开数据集只有图像,没有像素级分割标注和边界参数标注,需要自行标注(用传统方法自动生成+人工修正),深度学习分割研究需要标注数据集;③评测协议——ICE、ND等数据集有标准评测协议(训练/测试划分、匹配对/非匹配对定义),使用时应遵循标准协议以便与文献结果对比;④多样性——单一数据集的人群、设备、条件有限,跨数据集评估(在A上训练、在B上测试)才能验证算法的泛化能力;⑤伦理与合规——使用公开数据集应遵循数据集的使用协议(学术研究免费、商用需授权),注意个人信息保护。
10.2 开源实现与工具
虹膜识别的开源实现和工具:①OSIRIS(Open Source IRIS)——法国国家信息与自动化研究所(INRIA)开发的开源虹膜识别系统,实现了完整的Daugman框架(积分微分算子定位+橡胶片模型归一化+Log-Gabor特征编码+汉明距离匹配+循环移位),是最经典的开源虹膜识别实现,学术研究中广泛使用,C++实现,可在Linux/Windows上编译运行;②OpenIris——开源虹膜识别库,Python/C++实现,包含图像预处理、瞳孔/虹膜定位、归一化、Gabor编码、匹配等模块,适合教学和快速原型开发;③MIRLIN(Multimodal Iris Recognition Library)——美国圣母大学开发的多模态虹膜识别库,支持多种特征提取和匹配方法,包含评测工具;④UBIRIS开源框架——葡萄牙贝拉地区大学开发的可见光虹膜识别开源框架,针对噪声和遮挡优化;⑤深度学习分割模型——U-Net/U-Net++/FCN等虹膜分割模型的开源实现(GitHub上有多个项目,如iris-segmentation、unet-iris),在CASIA/IITD/UBIRIS上预训练,可直接用于分割或微调;⑥深度学习特征提取——基于PyTorch/TensorFlow的虹膜识别深度学习模型(如ArcFace-Iris、IrisNet),包含训练代码和预训练模型,支持度量学习和深度哈希;⑦活体检测开源——虹膜PAD(Presentation Attack Detection)开源工具,包含多种攻击类型的检测算法和评测协议;⑧OpenCV——计算机视觉开源库,提供了图像预处理、特征提取、形态学操作等基础功能,是虹膜识别开发的基础工具(但OpenCV没有内置完整的虹膜识别流水线,需要自己组装);⑨工业级SDK——商汤、旷视、中科虹霸、中科逸视、虹软等厂商提供商用虹膜识别SDK(支持Windows/Linux/Android/嵌入式),包含完整的采集、活体检测、识别、模板管理功能,精度和稳定性高于开源实现,适合产品化部署。开源实现适合学术研究、教学、原型验证,生产级产品通常使用商用SDK(经过大量优化和测试)或在开源基础上深度定制。
10.3 性能基准与竞赛
虹膜识别的性能基准与竞赛:①ICE(Iris Challenge Evaluation)——美国NIST主办的虹膜识别算法竞赛,2005年和2006年举办,提供标准数据集和评测协议,评估算法的识别精度(FAR/FRR/EER)和速度,是虹膜识别领域最权威的第三方评测之一,参赛算法包括学术界和工业界的主流系统;②IREX(Iris Recognition Exchange)——NIST主办的虹膜识别算法评估系列,持续更新,评估跨设备、跨条件、大规模库下的识别性能,最新版本包含移动端、可见光、活体检测等评估维度;③ICB/IJCB生物识别竞赛——国际生物识别会议(ICB/IJCB)主办的生物识别竞赛,包含虹膜识别赛道,评估最新算法在挑战性数据集上的性能;④学术论文基准——虹膜识别论文通常在CASIA-IrisV1/V3、IITD、MMU等标准数据集上报告EER和FAR@FRR,便于横向对比。近年来的性能基准趋势:①从近红外到可见光——传统基准都是近红外高质量图像,最新基准增加了可见光、移动设备、非受控环境的评估;②从精度到速度+精度——早期只评估精度,现在同时评估速度(1:N检索时间、端侧推理时间)和模型大小(适合嵌入式部署);③从识别到活体检测+隐私保护——安全和隐私成为重要评估维度,包含APCER/BPCER(活体检测错误率)和模板保护性能;④跨设备跨域泛化——评估算法在不同设备、不同人群、不同条件下的泛化能力,而不仅仅是在同一数据集的训练/测试划分上的性能。
十一、工程落地与优化
11.1 端侧部署与模型轻量化
虹膜识别系统通常需要部署在边缘设备(门禁终端、手机、嵌入式模组、ATM)而不是云端,因为:①隐私——虹膜模板是敏感生物特征,端侧处理可以避免原始图像和模板上传云端,保护隐私;②延迟——端侧识别延迟低(毫秒级),不需要网络传输,适合实时门禁、解锁等场景;③可靠性——不依赖网络,离线也能工作,适合网络不稳定的场景(如边境、野外);④成本——端侧处理不需要云端服务器和带宽,大规模部署成本低。端侧部署的核心挑战是计算资源有限(嵌入式CPU性能低、内存小、功耗受限),需要模型轻量化和算法优化:①模型轻量化——深度学习模型(分割、特征提取、活体检测)用MobileNet/EfficientNet/ShuffleNet等轻量级骨干网络,或用知识蒸馏(用大模型"教"小模型)、模型剪枝(去除冗余权重和通道)、量化(FP32→INT8,模型大小减少75%、推理速度提升2-4倍)压缩模型,将U-Net分割模型从几十MB压缩到1-5MB,推理时间从几百毫秒降到几毫秒;②算法优化——传统算法(Daugman算子、Gabor卷积、汉明距离)用SIMD指令(ARM NEON、x86 SSE/AVX)加速位运算和卷积,用多线程并行处理多帧和多滤波器,用查找表(LUT)加速相位量化和汉明距离计算;③硬件加速——利用嵌入式NPU(如瑞芯微RK3588、海思Hi3559、英伟达Jetson)、FPGA、DSP等硬件加速深度学习推理和图像预处理,将端到端延迟降到100-300毫秒;④内存优化——图像和中间结果用原地计算(in-place)减少内存占用,用图像金字塔(先低分辨率粗定位再高分辨率精定位)减少高分辨率处理范围,模板用紧凑存储(2048位编码+2048位掩码=512字节+元数据);⑤功耗优化——用动态频率调节(DFVS)根据负载调整CPU/NPU频率,用低功耗模式(空闲时关闭非必要模块),用硬件加速器(比CPU通用计算功耗低),确保电池供电设备(手机、手持终端)的续航。端侧部署的性能目标:端到端延迟(从采集到出结果)小于500毫秒(便利场景)或小于1秒(高安全场景,含活体检测),模型总大小小于20MB,内存占用小于200MB,功耗小于1W(待机)/5W(工作)。
11.2 实时性优化
实时性是虹膜识别用户体验的关键——用户希望看一眼摄像头就能快速识别,而不是长时间等待。实时性优化策略:①检测-跟踪联动——视频流中,第一帧用检测网络(或传统检测)定位虹膜,后续帧用轻量级跟踪器(KCF/CSRT/光流/关键点跟踪)跟踪虹膜位置,跟踪失败或每N帧(如每10帧)重新触发检测,大幅减少计算量(检测只在1/N帧运行);②ROI局部处理——检测到虹膜位置后,只在ROI区域内做定位、分割、归一化、编码,不处理整幅图像,计算量与ROI面积成正比(通常ROI只有整幅图像的1/10到1/5);③跳帧策略——视频流中不需要每帧都做完整识别,每2-3帧做一次完整识别(定位+分割+编码+匹配),中间帧只做跟踪和质量评估,在保证识别稳定性的同时降低计算量;④多线程流水线——将采集、预处理、检测/跟踪、定位/分割、编码、匹配、结果输出放在不同线程,形成流水线(pipeline),各阶段并行处理,提升整体吞吐量(虽然单帧延迟不变,但单位时间处理的帧数增加);⑤硬件加速——用GPU/NPU/FPGA并行加速图像预处理(卷积、形态学)、Gabor滤波(多滤波器并行)、深度学习推理(批量处理)、汉明距离匹配(位运算并行),关键路径延迟降低一个数量级;⑥早停与快速拒绝——质量评估不达标时立即拒绝(不进入后续耗时的定位/分割/编码),匹配时如果前几位汉明距离已经远大于阈值,提前终止匹配(快速拒绝不同人),1:N检索时用粗筛(短编码/LSH)快速排除大部分不匹配模板,只对Top-K候选做精确匹配;⑦预计算与缓存——Gabor滤波器核、归一化映射表(每个归一化像素对应原图坐标)、汉明距离查找表等预计算并缓存,避免重复计算;多帧采集时缓存前几帧的定位结果和编码,用于模板融合和稳定性判断。实时性优化的目标是端到端延迟(从用户对准摄像头到出识别结果)小于300-500毫秒(不含用户对准时间),帧率大于15-30fps(跟踪和质量评估),识别成功率大于95%(第一次对准即成功)。
11.3 鲁棒性优化
鲁棒性是指虹膜识别在非理想条件下(光照变化、姿态变化、遮挡、低质量、跨设备)仍能稳定识别的能力,是工程落地的核心挑战。鲁棒性优化策略:①光照鲁棒——近红外主动照明本身对环境光有一定抑制作用(近红外LED亮度远高于环境近红外光),但仍需:·自动曝光和增益控制(根据环境光调整传感器曝光和LED亮度,确保虹膜不过曝/欠曝);·光照校正算法(Retinex、平场校正、直方图匹配,消除光照不均和渐晕);·相位编码的光照不变性(Gabor相位编码只编码纹理结构,对绝对灰度不敏感,这是算法层面的光照鲁棒性);·多帧融合(不同曝光的多帧融合,扩展动态范围)。②姿态鲁棒——用户偏头、斜视、距离不当会导致虹膜透视变形和遮挡:·质量评估检测大角度偏斜(内外圆心偏心度大、虹膜可见度低),拒绝并提示用户正视;·小角度偏斜(小于20-30度)用循环移位补偿旋转,用透视校正(根据内外圆的椭圆变形估计姿态,做逆透视变换)校正;·采集端用视觉引导(屏幕上的眼睛框、箭头提示)帮助用户快速对准,减少姿态偏差。③遮挡鲁棒——眼睑、睫毛、反光、眼镜、头发遮挡:·精确的分割和掩码(U-Net像素级分割+眼睑/睫毛/反光检测),准确标记遮挡区域,匹配时排除;·有效位最低要求(确保有足够的未遮挡纹理用于匹配,如大于500位);·多帧选择(连续采集多帧,选择遮挡最少、质量最高的一帧);·采集端引导(提示用户摘眼镜、抬眉、眨眼、移开头发);·硬件缓解(偏振滤光片减少反光、多角度LED分散反光、抗反光镀膜镜头)。④图像质量鲁棒——运动模糊、离焦模糊、低分辨率、噪声:·质量评估(清晰度、分辨率、噪声)检测低质量图像,拒绝并提示重新采集;·图像增强(去噪、锐化、超分辨率重建)提升低质量图像的纹理可辨性;·多帧融合(多帧平均去噪、多帧选优);·采集端用自动对焦(确保虹膜在焦平面)、高帧率(减少运动模糊)、近红外主动照明(减少噪声)。⑤跨设备鲁棒——不同虹膜相机(不同分辨率、不同光源波长、不同光学特性)采集的同一人虹膜图像可能有差异:·设备校准(色彩/灰度校准、几何畸变校准、光源光谱校准);·域适应(用域对抗训练、风格迁移将不同设备的图像映射到统一特征空间);·模板标准化(遵循ISO/IEC 19794-6,统一编码格式和参数);·注册时用多设备采集(如果用户可能在不同设备上识别,注册时用多种设备采集生成鲁棒模板)。⑥跨人群鲁棒——不同年龄、性别、种族、虹膜颜色的人群:·训练数据多样化(覆盖不同人群,避免算法对特定人群偏见);·公平性评估(分别评估不同人群的FAR/FRR,确保没有显著差异);·浅色虹膜和老年人虹膜(纹理可能稀疏)的特殊处理(调整特征参数、增加有效位要求、结合其他生物特征)。鲁棒性优化是一个系统工程——需要算法、硬件、用户引导三方面结合,算法层面提升对非理想条件的容忍度,硬件层面从源头提升采集质量,用户引导层面帮助用户快速达到最佳采集条件。生产系统通常在实验室理想条件下EER小于0.1%,在真实非受控环境下EER可能上升到1-5%,鲁棒性优化的目标是缩小这个差距。
11.4 系统集成与业务流程
虹膜识别系统的工程落地需要与具体业务场景集成,设计完整的业务流程:①注册流程(Enrollment)——用户首次使用时注册虹膜模板:·用户引导(提示用户摘下眼镜、正视摄像头、保持距离);·活体检测(确保是真人,防止注册他人虹膜);·多帧采集(连续采集5-20帧,选择质量最高的1-3帧);·质量评估(确保注册模板质量高,质量分数大于80-90);·模板生成(定位→分割→归一化→编码,生成IrisCode+掩码);·模板融合(多帧模板融合,取多数/平均,提升模板质量和覆盖度);·模板加密存储(加密后存入数据库,关联用户身份信息);·注册成功反馈(提示注册成功,可选择注册双眼提升便利性和安全性)。注册是最关键的环节——注册模板质量直接决定后续识别成功率,注册时质量差会导致后续FRR高,因此注册时应严格要求质量,宁可让用户多采集几次,也要确保模板质量。②识别流程(Identification/Verification)——用户日常使用时识别:·用户检测(传感器/摄像头检测到有人靠近,唤醒系统);·活体检测+采集(同时进行活体检测和虹膜图像采集);·质量评估(质量不达标时实时提示用户调整,如"请靠近一点""请正视摄像头");·模板生成(定位→分割→归一化→编码);·匹配(1:1验证时与声明身份的模板比较;1:N识别时与库中所有模板比较,返回Top-K候选);·结果判定(汉明距离与阈值比较,结合margin判断和置信度);·业务联动(匹配成功则开门/登录/支付/放行,匹配失败则提示重试或转人工);·日志记录(记录识别时间、设备、用户、结果、图像(可选,隐私合规),用于审计和问题排查)。③模板更新流程——长期使用中模板可能需要更新:·识别时如果匹配分数在阈值附近但图像质量高,自动用新采集的图像更新模板(模板融合,提升覆盖度);·用户主动请求更新(如眼部手术后、识别成功率下降时);·定期更新(如每年一次,应对年龄相关的虹膜变化)。④异常处理流程——各种异常情况的处理:·识别失败(连续N次失败后锁定账户或转人工核验,防止暴力尝试);·活体检测失败(提示"请使用真实虹膜",记录可疑攻击);·设备故障(摄像头/LED故障时降级为人脸识别或人工核验,确保业务不中断);·网络故障(端侧本地识别不依赖网络,云端比对时网络故障则降级为本地缓存比对或离线模式);·隐私合规(用户请求删除模板时,安全擦除数据库中的模板和备份,记录删除操作)。⑤系统架构——典型的虹膜识别系统架构:·终端层(虹膜采集设备:门禁、手机、ATM、自助终端,负责采集、活体检测、端侧识别);·网络层(有线/WiFi/4G/5G,传输识别请求和结果,不传输原始虹膜图像(隐私保护));·服务层(模板管理服务:模板的增删改查、加密存储;识别服务:1:N大规模检索、多设备协同;用户管理服务:用户信息、权限、审计日志;运维监控服务:设备状态、识别成功率、异常告警);·数据层(模板数据库:加密存储虹膜模板,支持百万级检索;用户数据库:用户身份信息;日志数据库:识别日志和审计记录;备份与容灾:多副本、异地备份,确保数据安全和高可用)。生产系统的设计原则:隐私优先(原始图像不上云、模板加密、最小必要)、安全可靠(活体检测、防重放、防篡改、审计日志)、用户体验好(快速对准、实时引导、高识别率、低失败率)、可扩展(支持从几百到百万级用户、从单设备到多设备协同)、易运维(远程监控、OTA升级、故障诊断)。


评论前必须登录!
注册