 网硕互联帮助中心
💖💖作者:计算机毕业设计小途 💙💙个人简介:曾长期从事计算机专业培训教学,本人也热爱上课教学,语言擅长Java、微信小程序、Python、Golang、安卓Android等,开发项目包括大数据、深度学习、网站、小程序、安卓、算法。平常会做一些项目定制化开发、代码讲解、答辩教学、文档编写、也懂一些降重方面的技巧。平常喜欢分享一些自己开发中遇到的问题的解决办法,也喜欢交流技术,大家有技术代码这一块的问题可以问我! 💛💛想说的话:感谢大家的关注与支持! 💜💜 网站实战项目 安卓/小程序实战项目 大数据实战项目 深度学习实战项目
目录
- 奥运会奖牌榜数据分析与可视化系统介绍
- 奥运会奖牌榜数据分析与可视化系统演示视频
- 奥运会奖牌榜数据分析与可视化系统演示图片
- 奥运会奖牌榜数据分析与可视化系统代码展示
- 奥运会奖牌榜数据分析与可视化系统文档展示
奥运会奖牌榜数据分析与可视化系统介绍
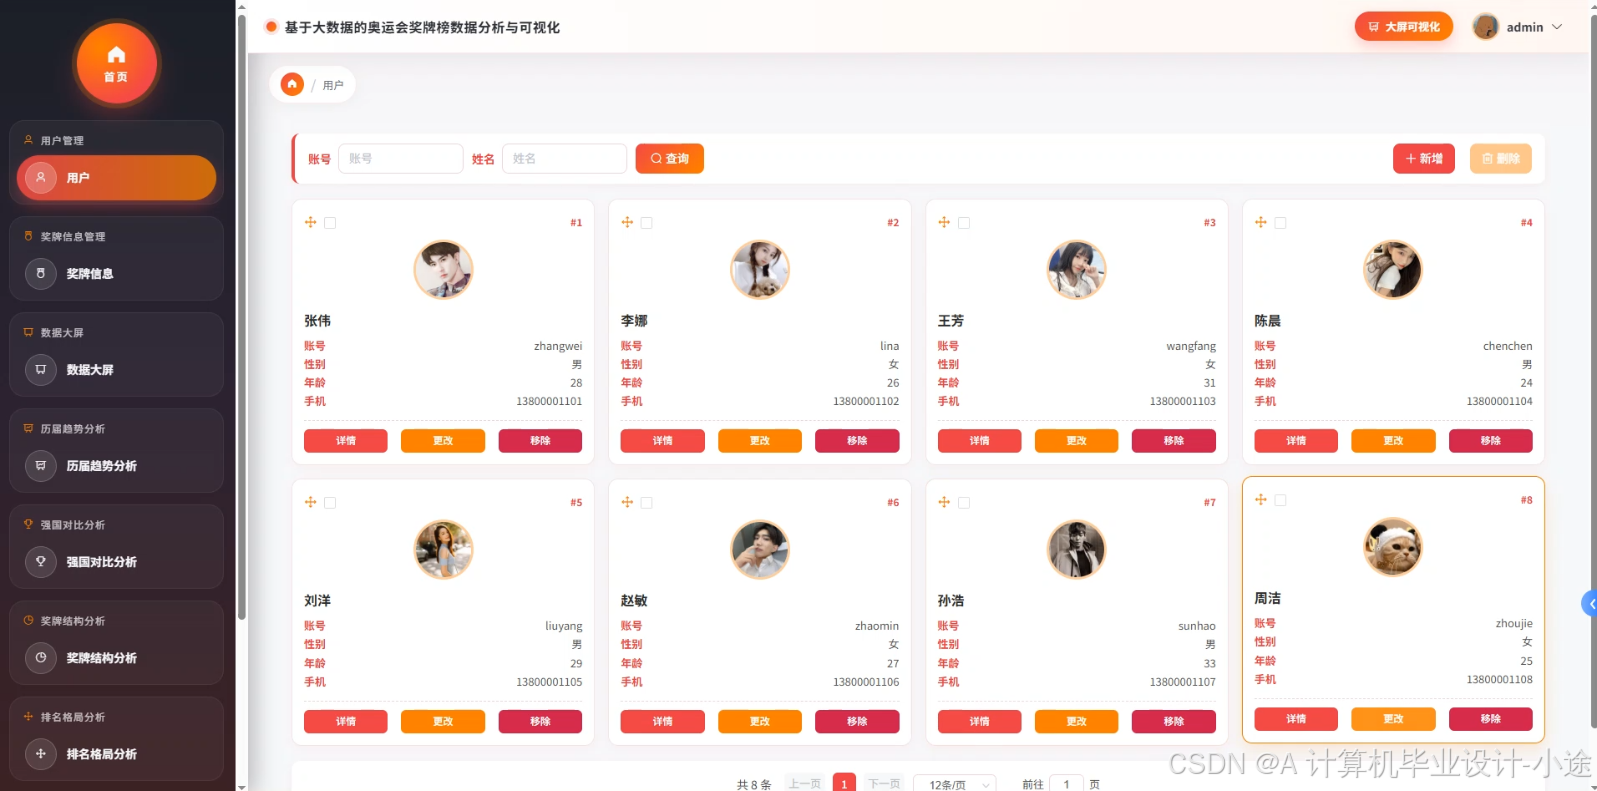
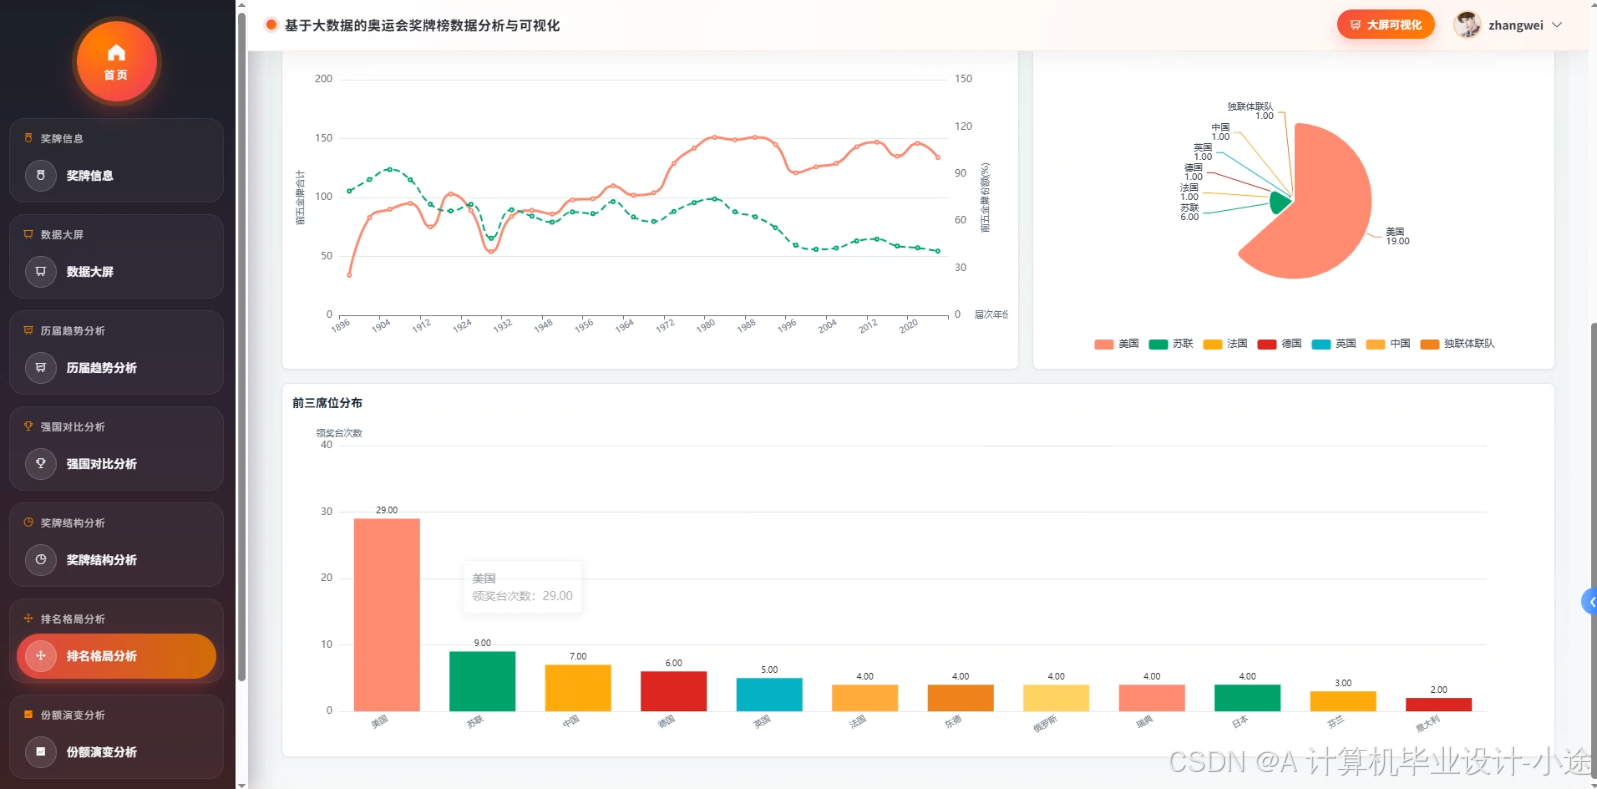
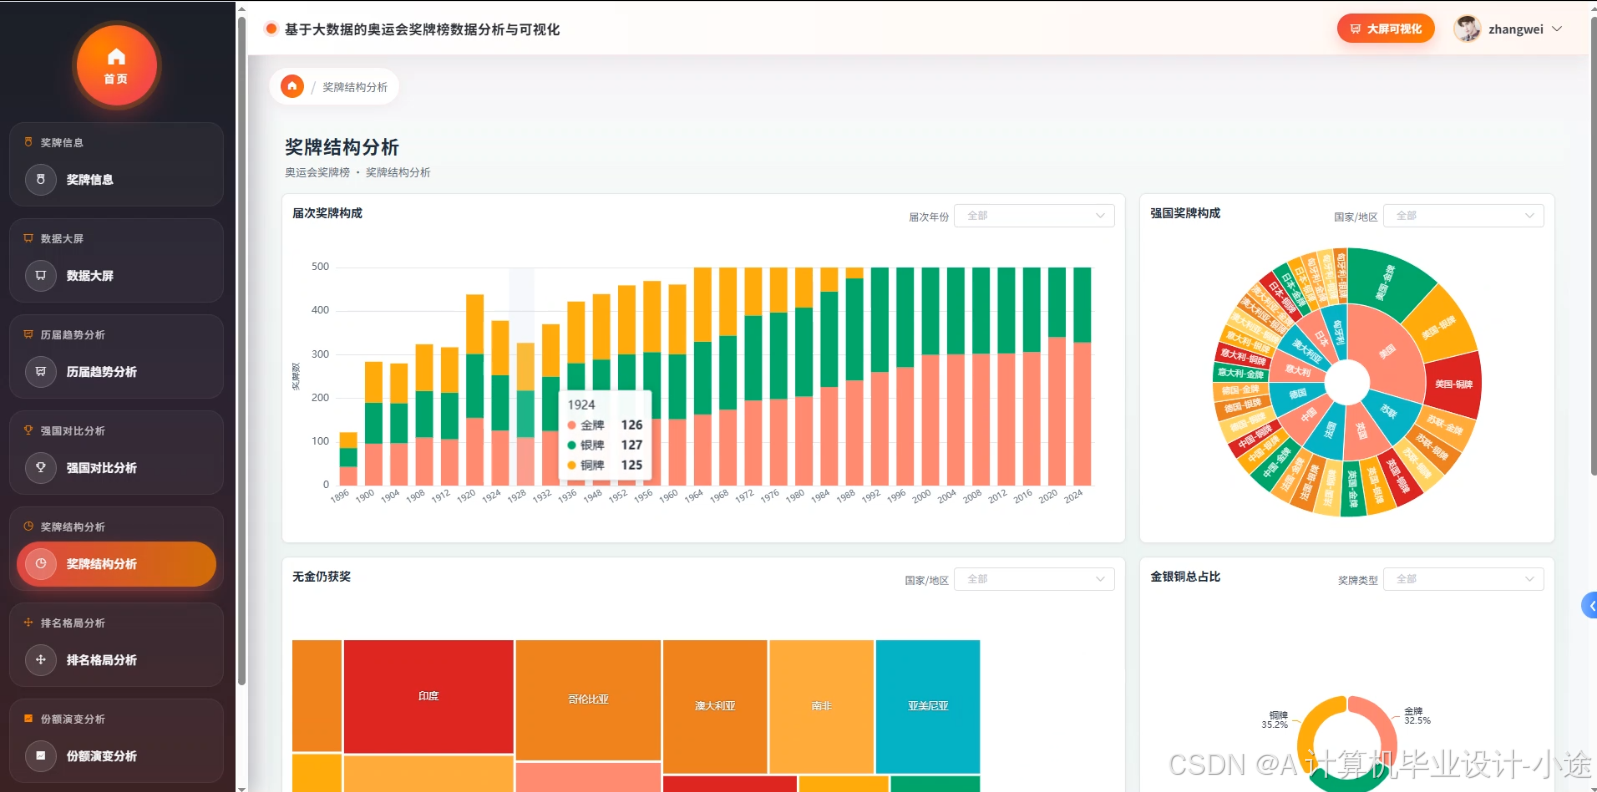
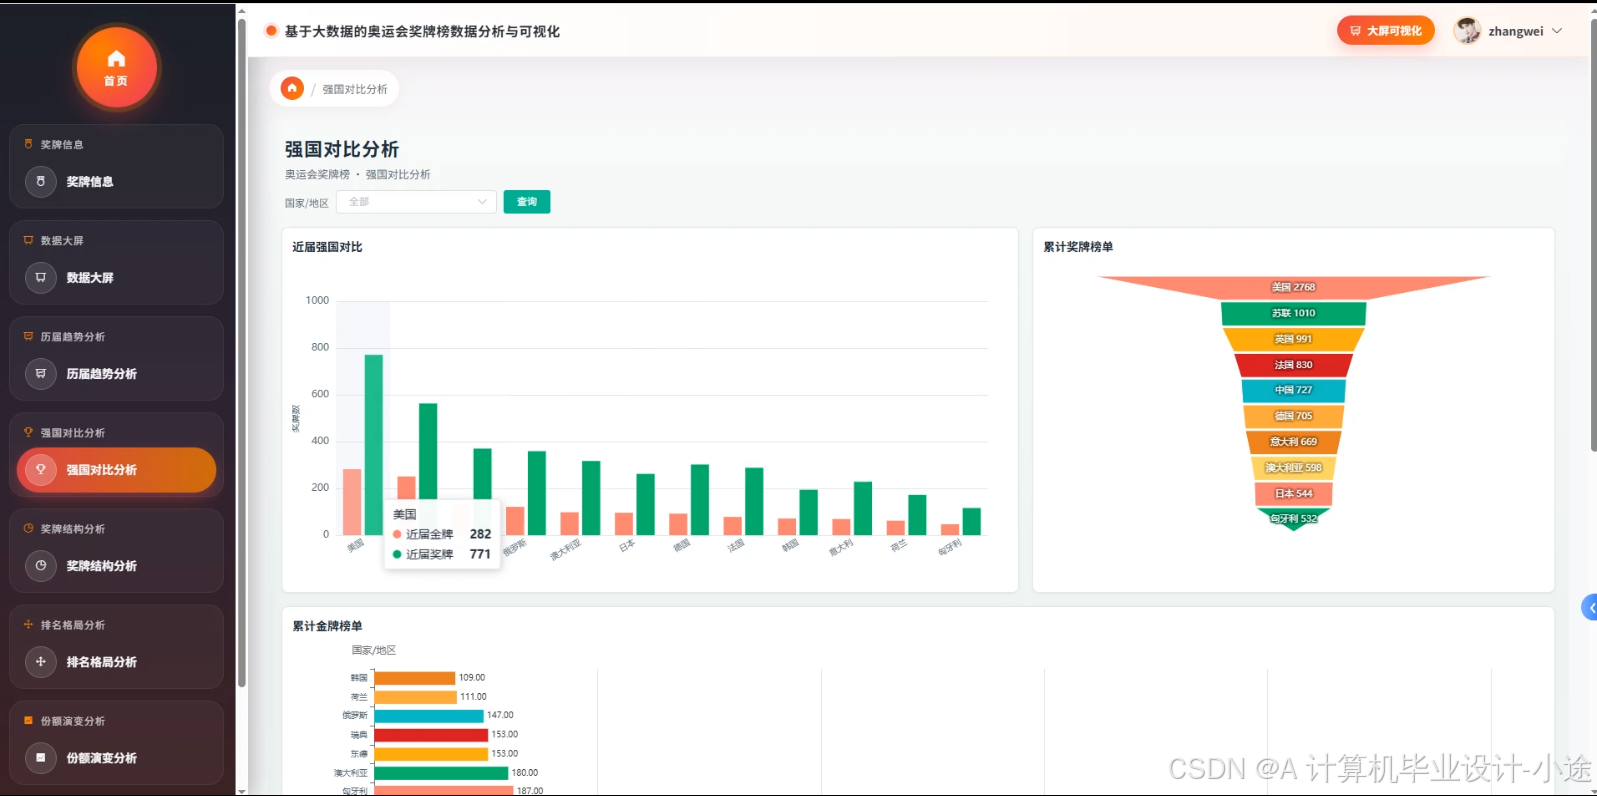
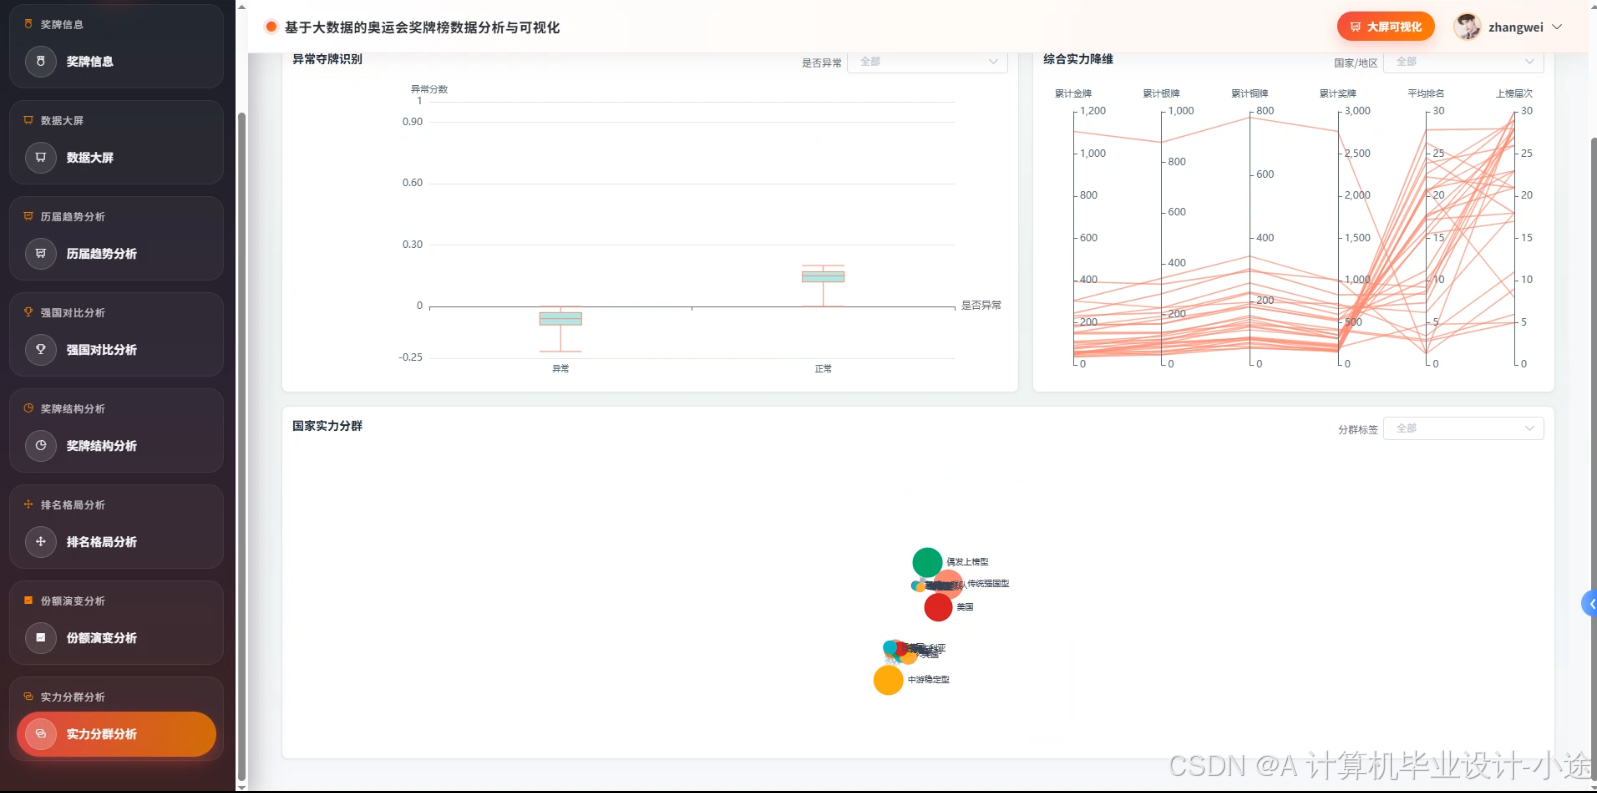
本系统《基于大数据的奥运会奖牌榜数据分析与可视化》是一套面向奥运会历史奖牌数据的分析与展示平台,整体采用Hadoop与Spark构建大数据处理链路,通过HDFS完成奖牌数据的存储,借助Spark与Spark SQL对历届奥运会奖牌数据进行清洗、统计与聚合计算,并结合Pandas、NumPy完成必要的数据整理与指标计算,最终将处理结果写入MySQL供后端调用。系统后端提供Python与Java两个版本,分别基于Django与Spring Boot实现,前端采用Vue、ElementUI、Echarts配合HTML、CSS、JavaScript与jQuery完成页面交互与图表渲染。功能层面涵盖系统首页、大屏可视化、用户管理、奖牌信息管理、数据大屏、历届趋势分析、强国对比分析、奖牌结构分析、排名格局分析、份额演变分析、实力分群分析、个人信息与修改密码等模块,能够从时间趋势、国家对比、奖牌构成、排名变化、份额演变以及实力分层等多个角度呈现奥运会奖牌榜的总体面貌。用户可以通过可视化大屏直观查看各国奖牌分布与变化情况,也可以进入具体分析页面查看不同维度的统计结果,从而对奥运会奖牌榜数据形成较为完整的认识。本系统适合作为计算机专业大数据方向的毕业设计项目,技术路线清晰,功能划分明确,能够体现大数据分析的基本流程与可视化展示的基本方法。
奥运会奖牌榜数据分析与可视化系统演示视频
项目演示视频
奥运会奖牌榜数据分析与可视化系统演示图片
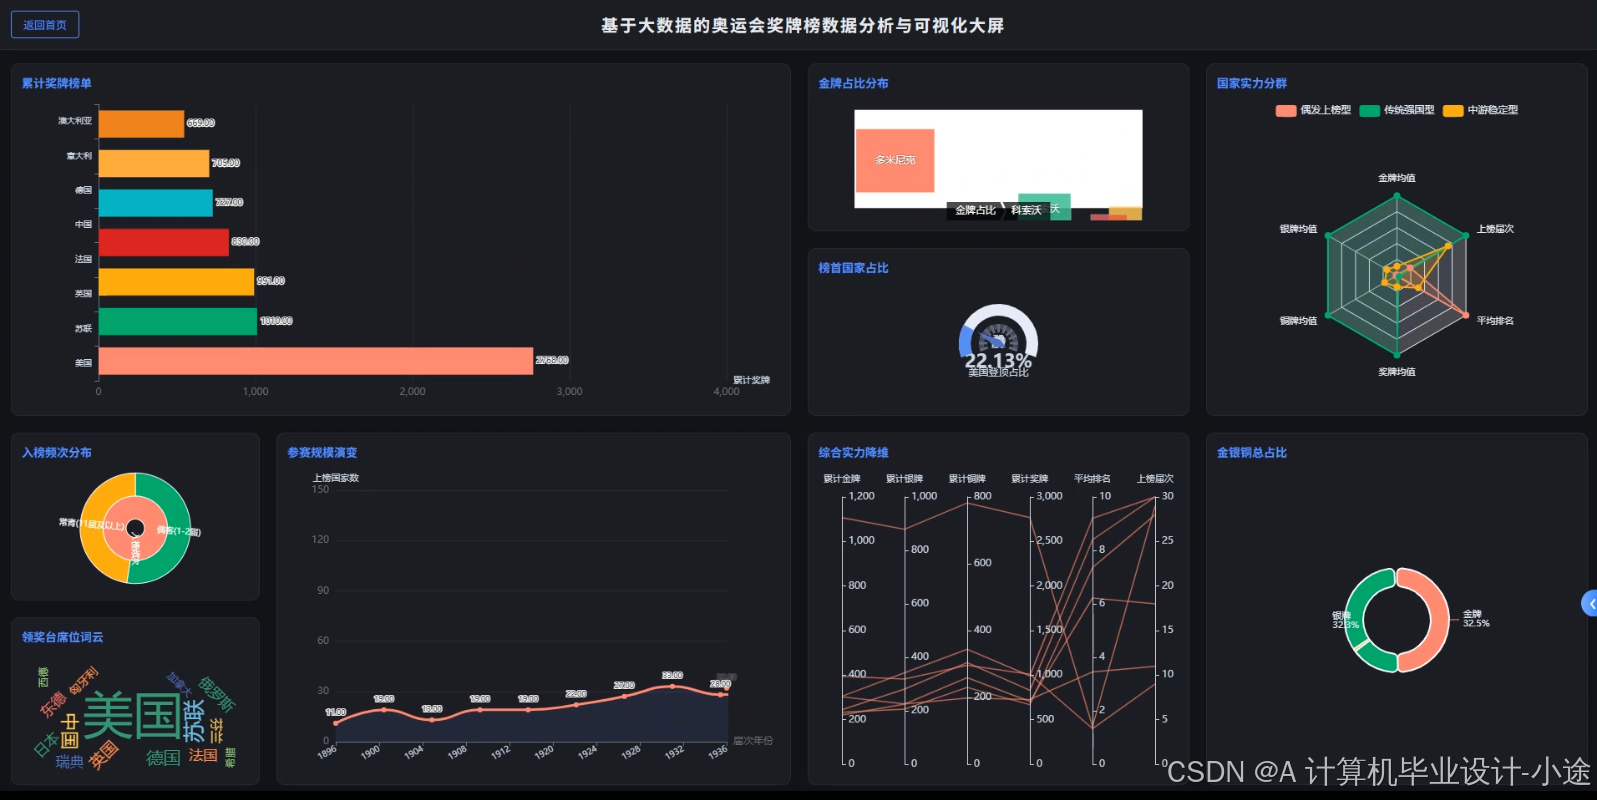
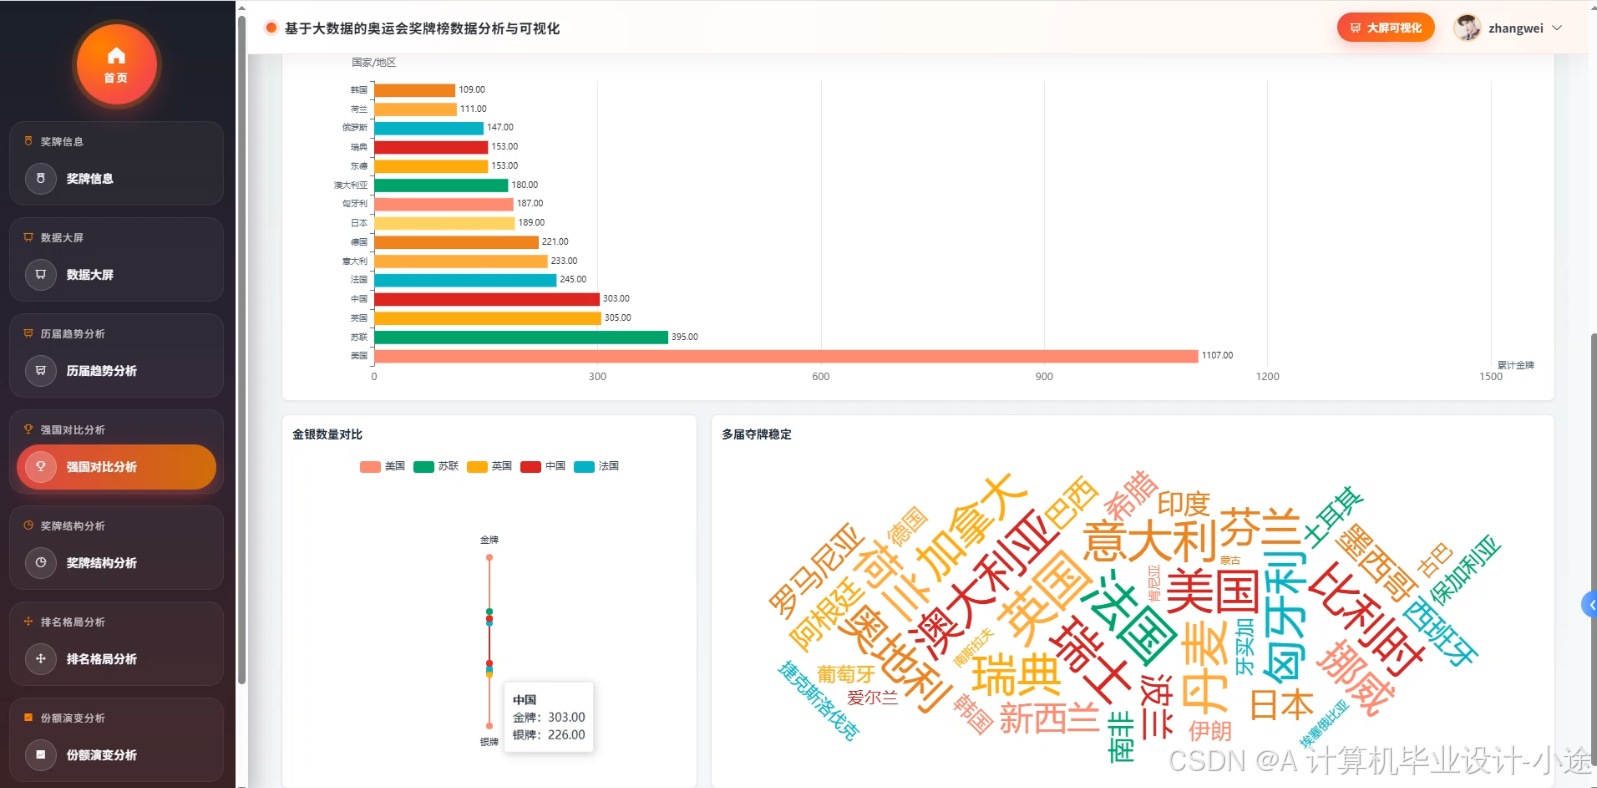
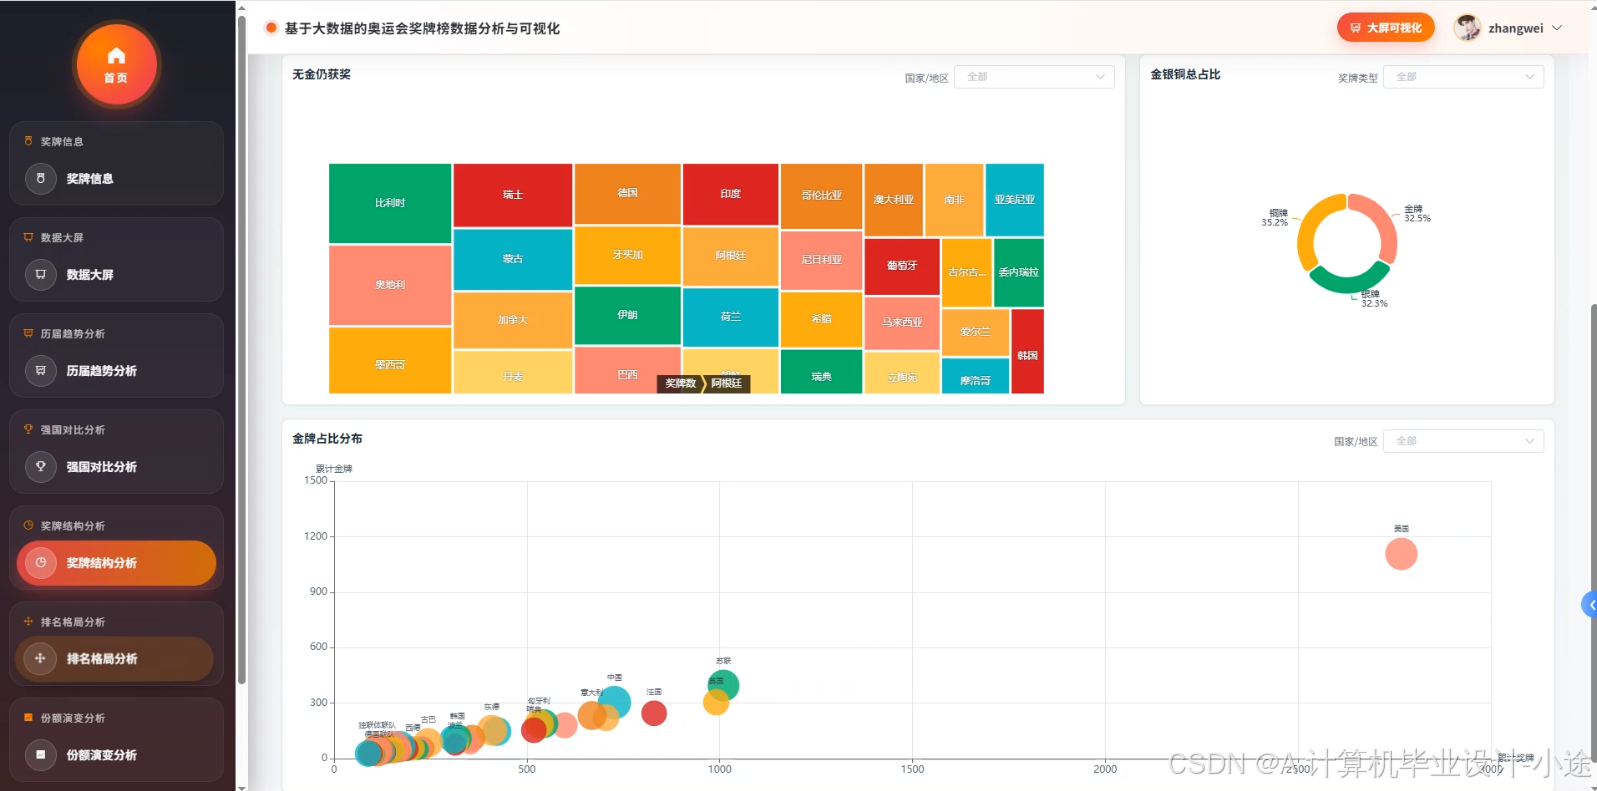
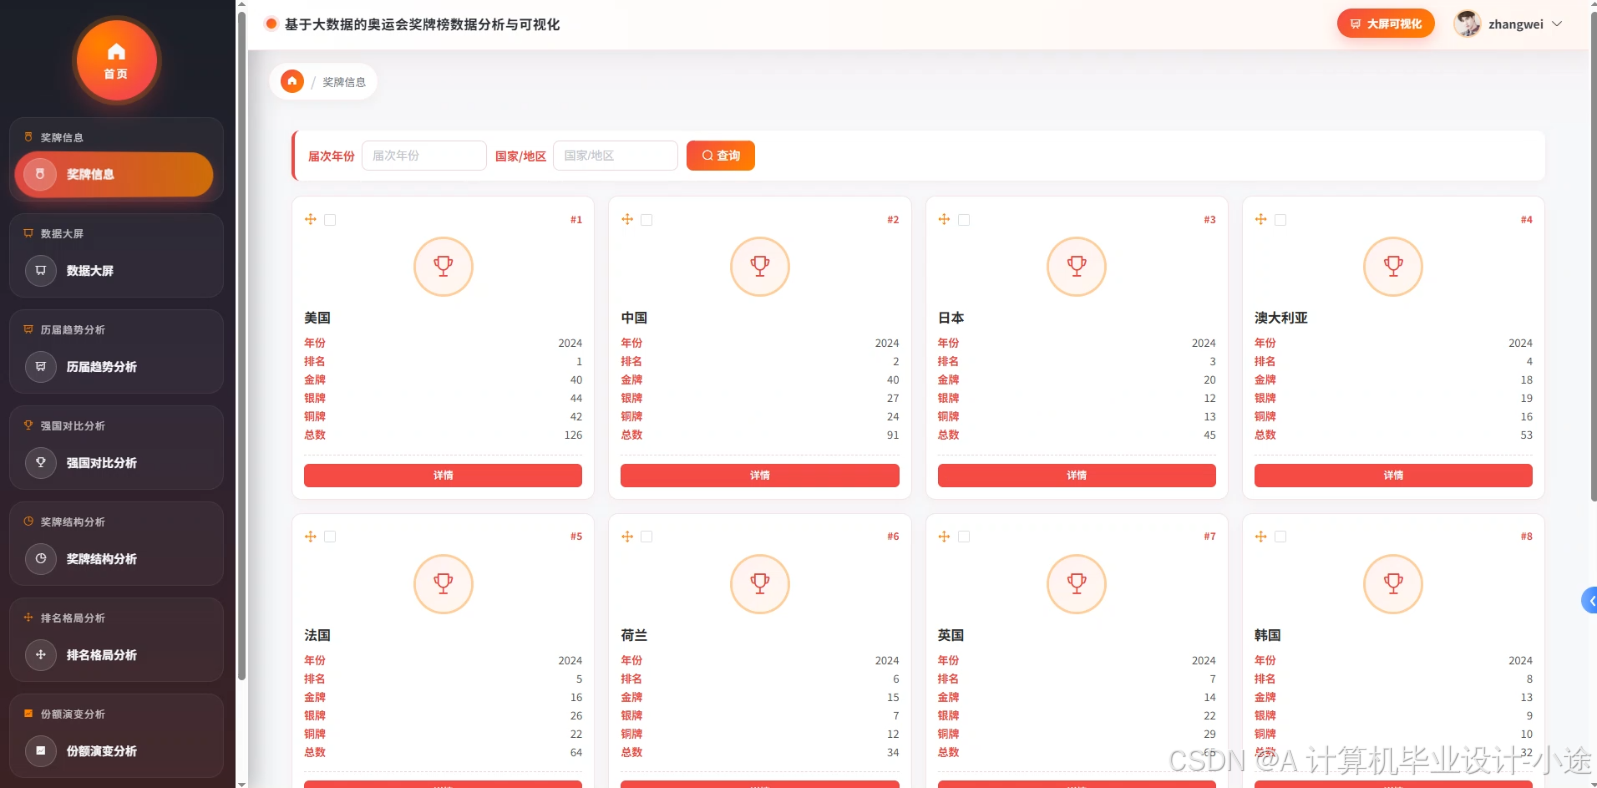
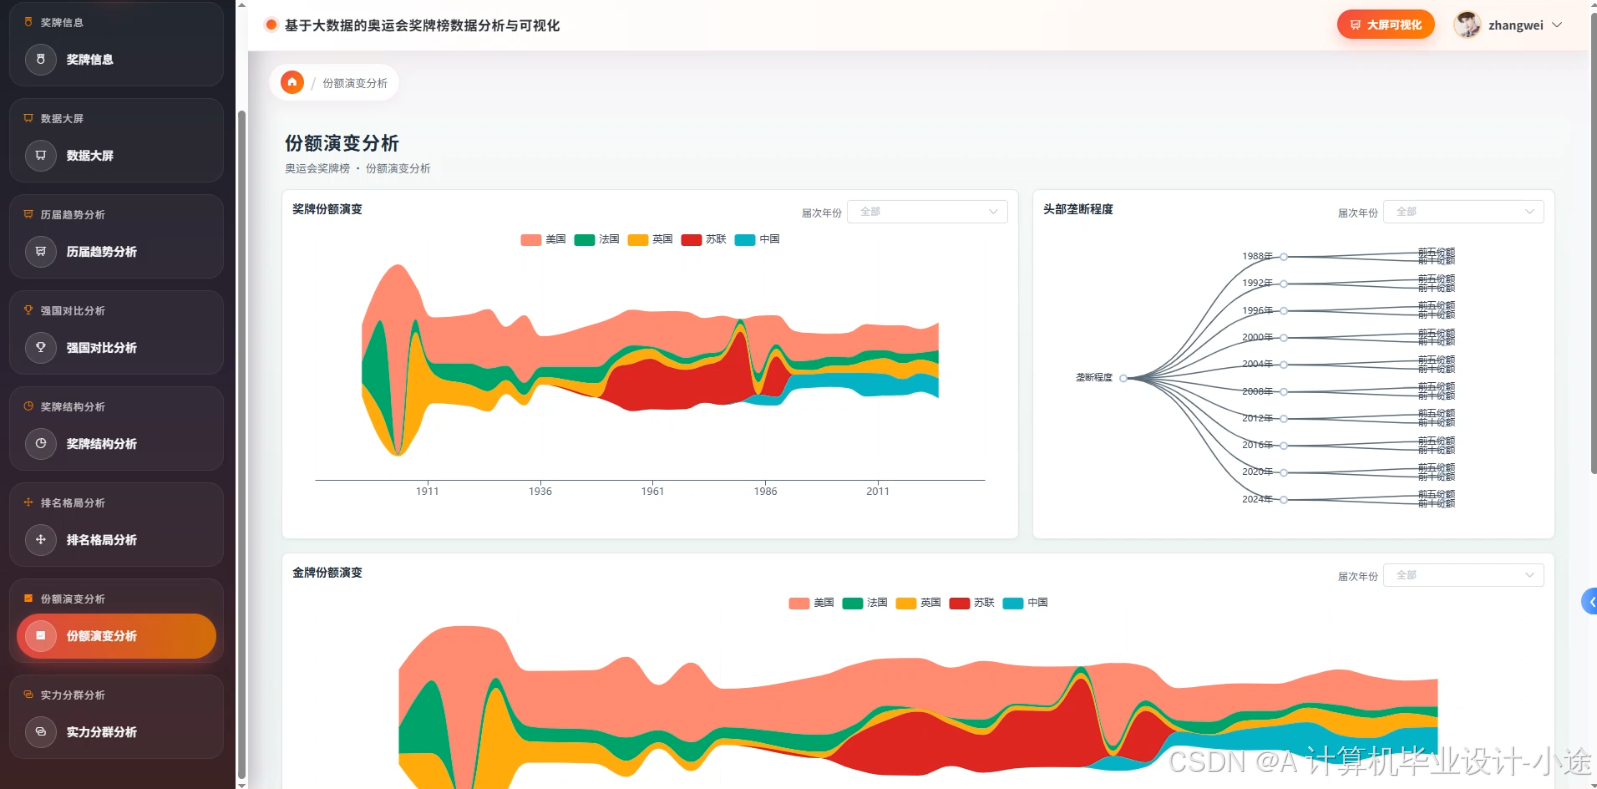
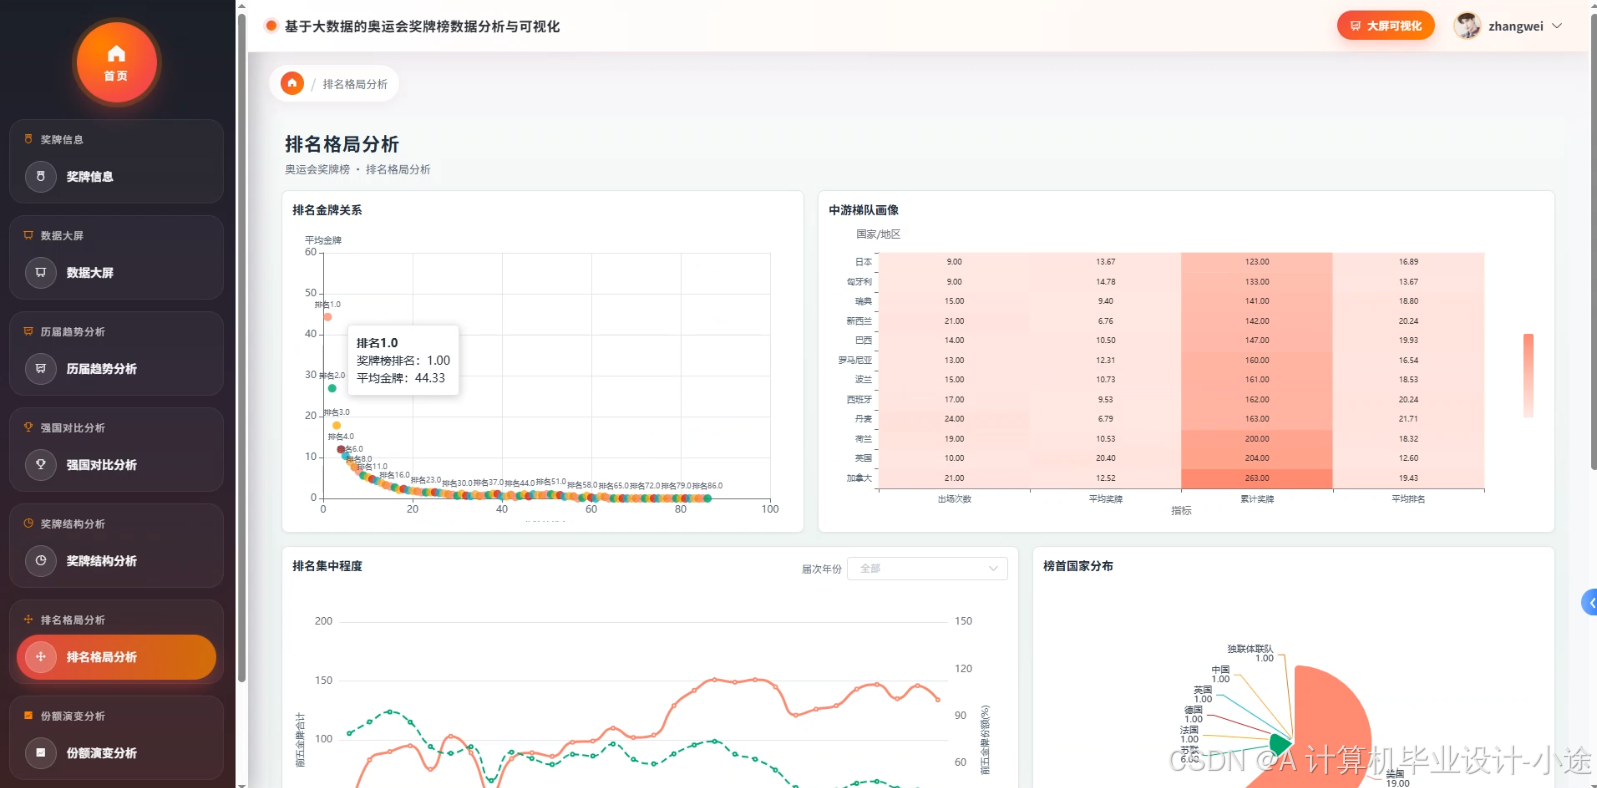
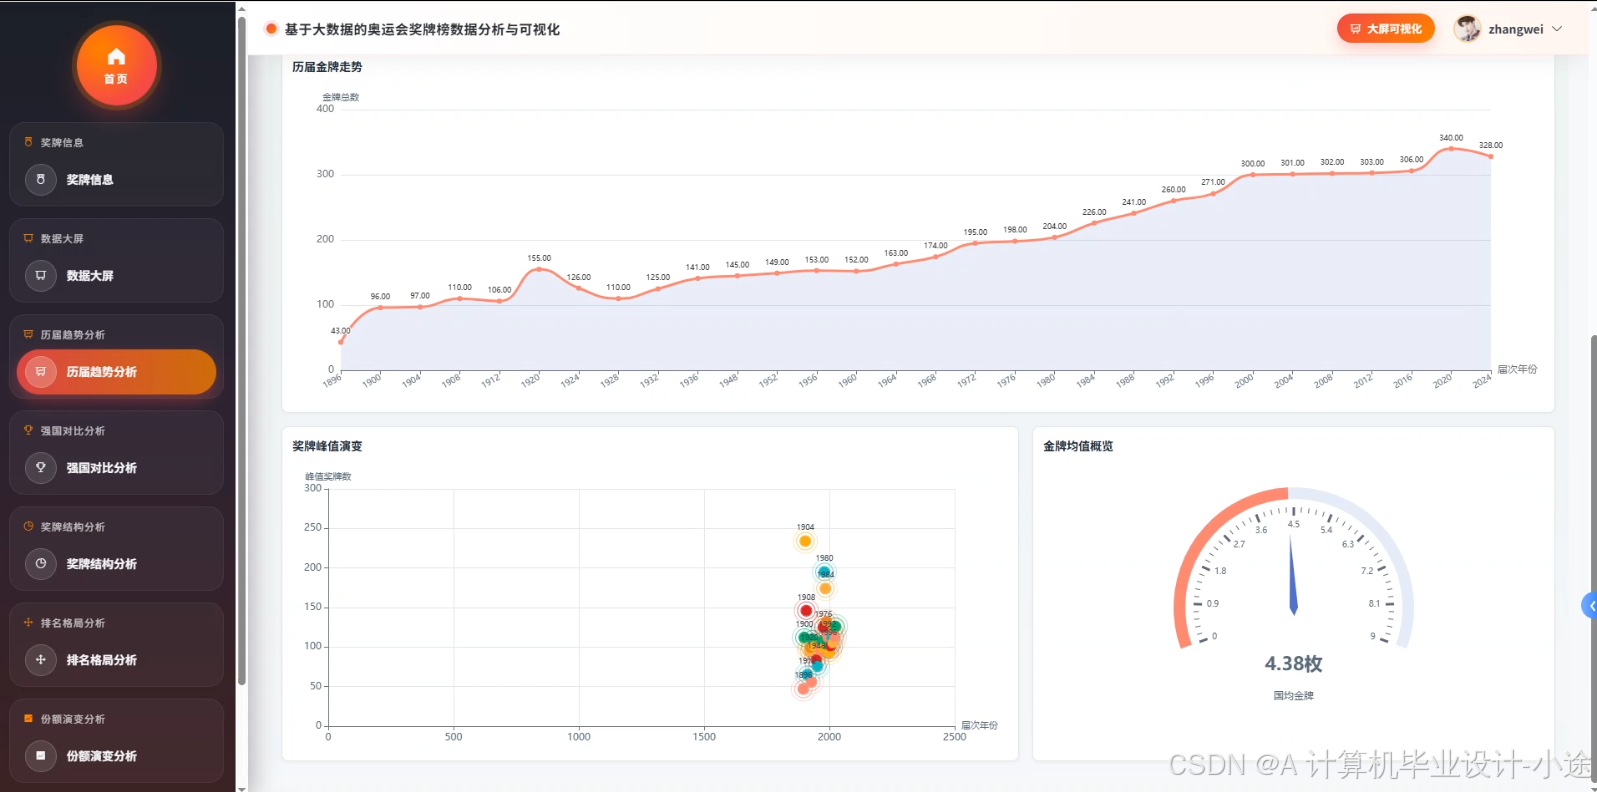
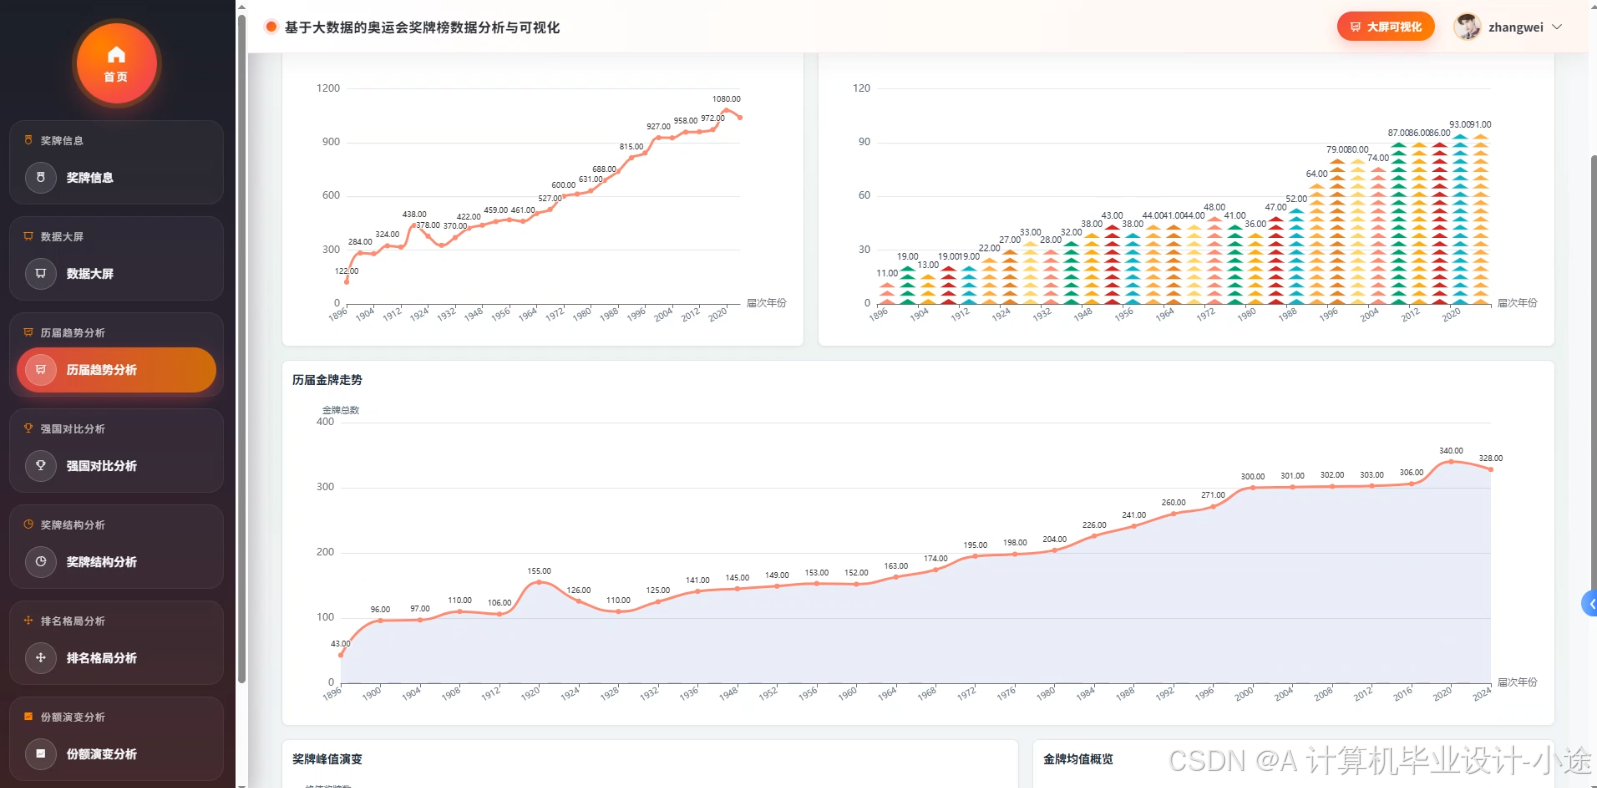
奥运会奖牌榜数据分析与可视化系统代码展示
from pyspark.sql import SparkSession
from pyspark.sql.functions import col, sum, desc, rank, round
from django.http import JsonResponse
from django.db import connection
spark = SparkSession.builder.appName("OlympicMedalAnalysis").master("local[*]").getOrCreate()
def medal_trend_analysis(request):
df = spark.read.format("jdbc").option("url", "jdbc:mysql://localhost:3306/olympic").option("dbtable", "medal_detail").option("user", "root").option("password", "123456").load()
df.createOrReplaceTempView("medal_detail")
trend_df = spark.sql("SELECT year, country, SUM(gold) AS gold_count, SUM(silver) AS silver_count, SUM(bronze) AS bronze_count, SUM(total) AS total_count FROM medal_detail GROUP BY year, country ORDER BY year ASC")
trend_df.createOrReplaceTempView("trend_result")
result_df = spark.sql("SELECT year, country, gold_count, silver_count, bronze_count, total_count, ROUND(total_count * 100.0 / SUM(total_count) OVER (PARTITION BY year), 2) AS share FROM trend_result ORDER BY year ASC, total_count DESC")
result_list = result_df.collect()
data = []
for row in result_list:
data.append({"year": row["year"], "country": row["country"], "gold": row["gold_count"], "silver": row["silver_count"], "bronze": row["bronze_count"], "total": row["total_count"], "share": row["share"]})
return JsonResponse({"code": 200, "msg": "历届趋势分析成功", "data": data})
def country_compare_analysis(request):
df = spark.read.format("jdbc").option("url", "jdbc:mysql://localhost:3306/olympic").option("dbtable", "medal_detail").option("user", "root").option("password", "123456").load()
df.createOrReplaceTempView("medal_detail")
compare_df = spark.sql("SELECT country, SUM(gold) AS gold_total, SUM(silver) AS silver_total, SUM(bronze) AS bronze_total, SUM(total) AS total_medal FROM medal_detail GROUP BY country")
compare_df.createOrReplaceTempView("compare_result")
rank_df = spark.sql("SELECT country, gold_total, silver_total, bronze_total, total_medal, RANK() OVER (ORDER BY gold_total DESC, total_medal DESC) AS gold_rank FROM compare_result ORDER BY gold_rank ASC")
rank_list = rank_df.collect()
data = []
for row in rank_list:
data.append({"country": row["country"], "gold": row["gold_total"], "silver": row["silver_total"], "bronze": row["bronze_total"], "total": row["total_medal"], "rank": row["gold_rank"]})
return JsonResponse({"code": 200, "msg": "强国对比分析成功", "data": data})
def strength_cluster_analysis(request):
df = spark.read.format("jdbc").option("url", "jdbc:mysql://localhost:3306/olympic").option("dbtable", "medal_detail").option("user", "root").option("password", "123456").load()
df.createOrReplaceTempView("medal_detail")
cluster_df = spark.sql("SELECT country, SUM(gold) AS gold_total, SUM(silver) AS silver_total, SUM(bronze) AS bronze_total, SUM(total) AS total_medal FROM medal_detail GROUP BY country")
cluster_df.createOrReplaceTempView("cluster_base")
level_df = spark.sql("SELECT country, gold_total, silver_total, bronze_total, total_medal, CASE WHEN gold_total >= 30 THEN '第一梯队' WHEN gold_total >= 10 THEN '第二梯队' WHEN gold_total >= 3 THEN '第三梯队' ELSE '第四梯队' END AS strength_level FROM cluster_base ORDER BY gold_total DESC")
level_list = level_df.collect()
data = []
for row in level_list:
data.append({"country": row["country"], "gold": row["gold_total"], "silver": row["silver_total"], "bronze": row["bronze_total"], "total": row["total_medal"], "level": row["strength_level"]})
return JsonResponse({"code": 200, "msg": "实力分群分析成功", "data": data})
奥运会奖牌榜数据分析与可视化系统文档展示
💖💖作者:计算机毕业设计小途 💙💙个人简介:曾长期从事计算机专业培训教学,本人也热爱上课教学,语言擅长Java、微信小程序、Python、Golang、安卓Android等,开发项目包括大数据、深度学习、网站、小程序、安卓、算法。平常会做一些项目定制化开发、代码讲解、答辩教学、文档编写、也懂一些降重方面的技巧。平常喜欢分享一些自己开发中遇到的问题的解决办法,也喜欢交流技术,大家有技术代码这一块的问题可以问我! 💛💛想说的话:感谢大家的关注与支持! 💜💜 网站实战项目 安卓/小程序实战项目 大数据实战项目 深度学习实战项目


评论前必须登录!
注册